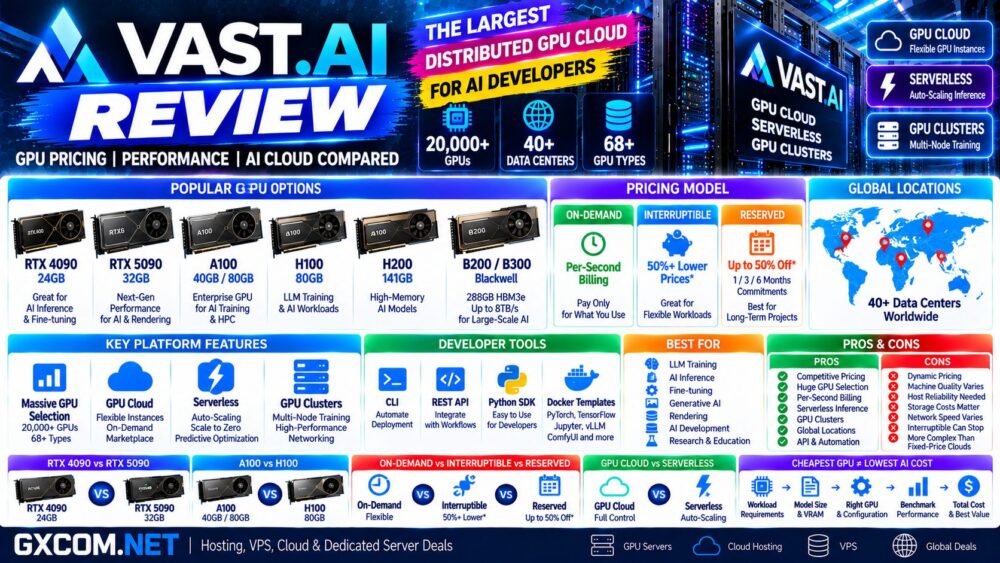
Vast.ai 已从一个低成本的GPU交易平台发展成为一个更广泛的人工智能基础设施平台,提供GPU云、无服务器GPU推理以及多节点GPU集群服务。.
与其仅运营一个采用固定GPU价格的集中式机队,, 广阔的.ai 通过分布式市场将各处的 GPU 算力连接起来。价格根据供需情况动态调整,用户可以按型号、VRAM、位置、可靠性、性能、存储、网络能力以及每小时成本等维度对 GPU 进行比较。.
该平台目前提供遍布40多个数据中心的20,000多块GPU,涵盖68多种GPU类型,从RTX 3090和RTX 4090等价格亲民的消费级GPU,到A100、H100、 H200、B200和B300等企业级加速器。.
在这篇 广阔的.ai 评测, ,我们将探讨 GPU 的定价、性能、市场模式、GPU 云、无服务器架构、可中断实例和预留实例、安全性、可靠性、AI 工作负载,以及在租用 GPU 计算资源前需要考虑的主要优缺点。.
Vast.ai 评测:简要概述
| 功能 | Vast.ai |
|---|---|
| 平台 | 分布式 GPU 云市场 |
| GPU 云 | 是的 |
| 无服务器 | 是的 |
| GPU 集群 | 是的 |
| GPU 集群 | 20,000+ |
| GPU 类型 | 68+ |
| 数据中心 | 40+ |
| RTX 4090 | 是的 |
| RTX 5090 | 是的 |
| NVIDIA A100 | 是的 |
| NVIDIA H100 | 是的 |
| NVIDIA H200 | 是的 |
| NVIDIA B200 | 是的 |
| NVIDIA B300 | 是的 |
| 按需 | 是的 |
| 可中断的 | 是的 |
| 保留 | 是的 |
| 账单 | 每秒 |
| 最低启动资金 | $5 账户余额 |
| CLI / API / SDK | 是的 |
| Docker 模板 | 是的 |
| 最适合 | AI训练、推理、微调、渲染和GPU开发 |
什么是 Vast.ai?
Vast.ai 是一个 GPU 计算市场和人工智能基础设施平台。.
Vast.ai 与传统云服务提供商之间的主要区别在于 GPU 算力的供应方式和定价模式。.
传统云服务通常拥有或直接控制集中式基础设施,并公布相对固定的实例价格。.
Vast.ai 则整合了分布式基础设施提供商的 GPU 算力,并允许它们竞标工作负载。.
其结果是一个价格随以下因素而波动的市场:
- GPU 型号
- GPU数量
- VRAM
- 主持人
- 位置
- 可靠性
- CPU
- RAM
- 存储
- 网络
- 供求
这虽然能带来极具竞争力的 GPU 定价,但也意味着两个搭载相同 GPU 的实例未必完全等同。.
Vast.ai 不仅仅是一个 GPU 交易平台
Vast.ai 目前将其人工智能基础设施划分为三种主要部署模式:
- GPU 云
- 无服务器
- GPU 集群
GPU Cloud 提供直接的实例控制,Serverless 可自动扩展推理工作节点,而 Clusters 则面向大规模多节点 AI 训练。.
这使得该平台的覆盖范围远比早期“仅从市场租用闲置GPU”这一概念更为广泛。.
Vast.ai GPU 云
GPU Cloud 提供了 Vast.ai 一贯的用户体验。.
用户搜索可用基础设施,并根据其工作负载的硬件和价格要求筛选实例。.
当前的筛选条件和选择标准可包括:
- GPU 型号
- GPU数量
- VRAM
- 每小时价格
- DLPerf
- 可靠性
- CPU
- RAM
- 存储
- 网络带宽
- CUDA 版本
- 位置
- 已验证的机器
- 安全云
找到合适的机器后,用户可以通过 Web 控制台、CLI、Python SDK 或 REST API 进行部署。.
Vast.ai GPU 定价
Vast.ai 并未针对每款 GPU 设定固定的价格。.
市场价格随供求变化而波动。.
这意味着,询问“Vast.ai 上的 H100 价格是多少?”并没有一个固定答案。.
正确的比较标准应为工作负载部署时的实时市场汇率。.
Vast.ai 目前表示,在市场条件有利的情况下,H100 的算力价格约为每 GPU-小时 $0.90,但实际报价会持续波动。.
因此,用户应将广告中标注的“起价”视为当前可获得的最低报价,而非有保障的长期利率。.
Vast.ai 的 GPU 价格为何会变动
GPU的价格受以下几个因素的影响:
- GPU 供应
- 需求
- GPU架构
- VRAM
- 主机可靠性
- 机器配置
- 位置
- 存储
- 带宽
- 租赁类型
例如,两款 RTX 4090 套餐可能配备相同的 24GB GPU,但在 CPU、内存、SSD 性能、上传带宽、下载带宽、可靠性评分和地理位置方面存在差异。.
因此,仅比较每小时的GPU价格可能会产生误导。.
Vast.ai 按需实例
“按需”是适用于那些应持续运行直至客户将其停止的工作负载的标准选项。.
Vast.ai 目前将“按需”模式描述为生产工作负载的首选方案。.
优点包括:
- 按秒计费
- 无计划停机
- 灵活的开始和结束
- 无需长期承诺
对于交互式开发、推理服务以及无法容忍抢占的工作负载而言,这通常是更安全的租用类型。.
Vast.ai 可中断实例
可中断实例以牺牲可用性保证为代价,换取更低的价格。.
据 Vast.ai 称,目前这些实例的成本比同等规格的按需实例低 50% 以上。.
其取舍在于,这台机器可以被回收。.
因此,可中断基础设施更适合用于容错型工作负载,例如:
- 批处理
- 带检查点的训练
- 渲染
- 实验
- 可恢复的分布式工作负载
对于必须保持持续可用性的生产服务而言,这通常不太合适。.
Vast.ai 预留实例
预留定价专为需要在较长时间内拥有可预测的 GPU 容量的负载而设计。.
Vast.ai 当前的选项包括以下大致承诺:
- 1个月
- 3个月
- 6个月
Vast.ai 目前宣传称,符合条件的预留容量可享受最高约 50% 的折扣。.
对于持续训练、研究项目、持久性 AI 基础设施以及其他 GPU 利用率可预测的工作负载而言,预留实例是一个不错的选择。.
按需型、可中断型与预留型
| 因子 | 按需 | 可中断的 | 保留 |
|---|---|---|---|
| 承诺 | 低 | 低 | 更高 |
| 中断风险 | 低 | 更高 | 低 |
| 定价 | 标准市场利率 | 较低 | 折现承诺 |
| 最适合 | 生产/开发 | 容错作业 | 稳定的工作量 |
| 账单 | 每秒 | 每秒 | 基于承诺的 |
Vast.ai GPU 选择
Vast.ai 最大的优势之一在于 GPU 种类丰富。.
当前平台提供超过68种GPU型号,涵盖了NVIDIA的多个产品代。.
常见选项包括:
- RTX 3090
- RTX 4090
- RTX 5090
- RTX A系列
- NVIDIA L系列
- NVIDIA A100
- NVIDIA H100 PCIe
- NVIDIA H100 SXM
- NVIDIA H100 NVL
- NVIDIA H200
- NVIDIA B200
- NVIDIA B300
这使用户能够根据实际工作负载选择硬件,而不是仅限于少数几种云实例类型。.
Vast.ai 上的 RTX 4090
对于注重性价比的人工智能工作负载而言,RTX 4090 依然是最受欢迎的显卡之一。.
其中规定:
- 24GB GDDR6X 显存
- 艾达·洛夫莱斯架构
- 16,384 个 CUDA 核心
- 1,008GB/s 内存带宽
对于以下人群而言,它可能特别具有吸引力:
- LLM推理
- 量化语言模型
- LoRA 微调
- Stable Diffusion
- ComfyUI
- 计算机视觉
- 渲染
其主要局限在于24GB的显存容量。.
Vast.ai 上的 RTX 5090
RTX 5090 实例提供了一款搭载 32GB 显存的、基于 Blackwell 架构的新一代消费级 GPU 选项。.
对于内存需求超过24GB的建模和推理配置而言,额外的内存使得RTX 5090比RTX 4090更具实用性。.
不过,性价比应根据实际工作负载来衡量,而不是一味认为新款GPU就一定能提供更高的性价比。.
Vast.ai 上的 NVIDIA A100
A100 仍被广泛应用于人工智能训练、微调、推理、科学计算以及高性能计算(HPC)领域。.
由于其更大的内存配置,当RTX级显卡无法提供足够的显存时,它便派上了用场。.
A100 在以下方面尤其有用:
- LLM微调
- 深度学习
- 大型数据集
- 多GPU训练
- 科学计算
NVIDIA H100 和 H200
H100 和 H200 面向规模大得多的 AI 工作负载。.
Vast.ai 目前提供多种 H100 版本,包括 PCIe、SXM 和 NVL 基础设施,以及 H200 容量。.
这些 GPU 适用于:
- 大型语言模型的训练
- 生成式人工智能
- 大型模型推理
- 分布式训练
- 高通量人工智能
- HPC
如需更多选项,请参阅我们的
NVIDIA H100 GPU 服务器优惠活动
比较。.
Vast.ai 上的 B200 和 B300
2026年,Vast.ai 通过引入 NVIDIA B200 和 B300 GPU 扩展了其市场。.
B300 属于 Blackwell Ultra 系列,配备 288GB HBM3e 内存,内存带宽约为 8TB/s。.
此类加速器专为内存消耗极高的工作负载而设计,包括:
- 大规模推理
- 推理模型
- 分布式训练
- 大型语言模型
- 高内存AI工作负载
B200 和 B300 的推出也表明,与早期专注于低价消费级 GPU 相比,Vast.ai 市场已经变得多么广泛。.
Vast.ai 无服务器
Vast.ai Serverless 主要面向 AI 推理等工作负载,此类工作负载的需求会随时间变化。.
与手动维持固定数量的 GPU 实例不同,无服务器架构可以根据工作负载需求自动调整 GPU 工作进程的规模。.
当前功能包括:
- GPU 工作进程的自动扩展
- 归零
- 预测性优化
- 多种 GPU 工作进程类型
- Python SDK 部署
- 日志和指标
- Jupyter 访问
- SSH 访问
- 储备员工队伍
这一点对于推理 API 尤为重要,因为这类 API 的流量在一天中可能会发生剧烈变化。.
Vast.ai 无服务器定价
Vast.ai 表示,无服务器模式不会在底层 GPU 定价模式的基础上额外收取费用。.
计费方式仍按使用量结算,并支持按需、可中断和预留容量。.
“按需缩放至零”可以降低 GPU 的闲置成本,因为当需求消失时,可以释放工作进程。.
这形成了一种与为仅偶尔接收请求的推理端点持续租用 H100 或 RTX 4090 截然不同的经济模式。.
Vast.ai GPU 集群
对于无法高效部署在单台机器上的工作负载,Vast.ai 还提供多节点 GPU 集群。.
集群专为大规模训练而设计,可在适用的基础设施上使用InfiniBand等高速网络。.
典型的工作负载包括:
- 分布式大型语言模型(LLM)训练
- 大型人工智能模型
- HPC
- 研究
- 多节点机器学习
集群的性能在很大程度上取决于GPU互连和网络架构,而不仅仅取决于GPU的总数量。.
Vast.ai 模板
Vast.ai 提供了可简化常见 AI 环境部署的模板。.
用户可以选择官方模板、社区模板,或者创建自己的基于 Docker 的环境。.
典型的软件包括:
- PyTorch
- TensorFlow
- Jupyter
- CUDA
- vLLM
- ComfyUI
- LLM 框架
- 生成式人工智能工具
模板可以缩短配置时间,但用户仍应验证 CUDA、驱动程序、框架以及 GPU 架构的兼容性。.
CLI、API 和 Python SDK
Vast.ai 越来越注重开发者需求。.
目前,可以通过以下方式控制基础设施:
- Web控制台
- CLI
- REST API
- Python SDK
这使团队能够自动完成 GPU 的发现、配置、扩展和终止,而无需通过控制面板手动选择实例。.
对于规模较大的 AI 工作负载,基于 API 的资源配置可能是 Vast.ai 最实用的功能之一。.
部署前请进行基准测试
Vast.ai 于 2026 年推出了一套特别实用的基准测试工作流。.
其命令行界面(CLI)可在多种GPU类型(如H100、A100、RTX 5090和RTX 4090)上测试相同的工作负载。.
该工具会租用真实的实例,运行基准测试,生成性能和成本效益报告,然后释放这些实例。.
这有助于解答一个比单纯询问“哪款显卡最快”更有价值的问题:
对于这一特定工作负载,哪款GPU的性价比最高?
Vast.ai 的可靠性
在分布式市场中,可靠性需要比在云环境中投入更多的关注,因为在云环境中,每个实例都来自同一组标准化的数据中心集群。.
Vast.ai 提供主机和机器的可靠性信息,这些信息可在筛选报价时使用。.
买家应评估:
- 主机可靠性
- 已验证状态
- 设备可用性
- 网络性能
- 存储性能
- 最大实例时长
对于实验性工作负载,最便宜的机器可能就足够了。.
对于生产基础设施而言,可靠性和安全性可能比每GPU小时节省几美分更为重要。.
安全云
Vast.ai 为需要更严格运营和安全控制的工作负载提供安全云基础设施。.
当前的 GPU 云平台具备隔离环境、直接 SSH 访问、私有网络功能、审计选项以及符合 SOC 2 标准等特点。.
处理涉及商业敏感工作负载的用户应区分“安全云”容量与标准化程度较低的市场基础设施,而不是将每项服务都视为同等。.
存储成本很重要
GPU的每小时价格只是AI基础设施总成本的一个组成部分。.
根据实例和工作负载的不同,用户可能还需要考虑以下因素:
- 容器磁盘
- 持久化存储
- 数据传输
- 模型下载
- 数据集存储
- 闲置资源
如果存储、带宽或数据加载速度慢导致 GPU 利用率降低,那么一款看似极其便宜的 GPU 其吸引力就会大打折扣。.
因此,正确的度量标准是:
总工作负载成本 ≠ 仅 GPU 每小时价格。.
Vast.ai 用于大语言模型(LLM)训练
Vast.ai 对于大型语言模型(LLM)的训练颇具吸引力,因为其市场平台既提供了价格低廉的消费级 GPU,也提供了高端数据中心加速器。.
较小的微调工作负载可在 RTX 4090 或 RTX 5090 系统上高效运行,而较大的模型则可能需要 A100、H100、H200、B200 或 B300 的计算能力。.
如果正确实施检查点机制,可中断定价可以进一步降低训练成本。.
如需了解更多 GPU 选项,请参阅我们的
最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器
指南。.
Vast.ai 用于 AI 推理
推理工作负载与训练的工作负载有不同的要求。.
重要指标包括:
- 获得第一个代币所需的时间
- 每秒代币数
- 并发请求
- VRAM
- 批次大小
- 延迟
- 每次请求的成本
对于可预测的流量,使用持久型 GPU 云实例可能是明智之选。.
对于波动较大的需求,Vast.ai Serverless 可以通过自动调整 GPU 工作节点的规模来减少闲置算力。.
Vast.ai 性能
对于“Vast.ai 的性能”,并没有一个有意义的单一基准。”
该平台包含数千台具有不同特性的机器:
- GPU
- CPU
- RAM
- PCIe 配置
- 存储设备
- 网络连接
- 地点
因此,两台配备相同RTX 4090 GPU的机器,其端到端工作负载性能可能有所不同。.
因此,在决定使用长期运行的实例之前,进行基准测试尤为重要。.
我们是否对 Vast.ai 进行了独立的基准测试?
本评测基于目前已发布的平台规格、定价信息、基础设施文档、产品功能以及市场服务能力,对 Vast.ai 进行了评估。.
除非 GXCOM.NET 明确公布了基准测试方法和实际测试结果,否则不应将 Vast.ai 提出的性能声明视为 GXCOM.NET 的独立基准测试结果。.
对于高强度的人工智能工作负载,请在多种候选 GPU 类型和机器上测试您自己的模型。.
有用的测量数据包括:
- 每秒代币数
- 培训吞吐量
- GPU利用率
- VRAM利用率
- 存储吞吐量
- 网络吞吐量
- 任务完成时间
- 每个已完成工作负载的总成本
Vast.ai 与 RunPod 对比
| 因子 | Vast.ai | RunPod |
|---|---|---|
| 核心模型 | 分布式GPU交易平台 | GPU云平台 |
| 定价 | 充满活力的市场 | 更标准化的云服务定价 |
| GPU种类 | 非常广泛 | 广泛 |
| 消费级显卡 | 高可用性 | 有货 |
| 企业级GPU | 是的 | 是的 |
| 无服务器 | 是的 | 是的 |
| 可中断的 | 是的 | 定价模式各不相同 |
| 宿主变异性 | 更高 | 更规范的体验 |
| 最适合 | 价格发现与丰富的GPU选择 | 简化的 GPU 云工作流 |
由于 GPU 类型、利用率、存储、区域以及当前可用性等因素都会产生影响,因此并非所有工作负载在任一平台上都必然更便宜。.
请阅读我们的
RunPod 评测
如需详细了解该替代平台,请参阅。.
Vast.ai 与 GPU Mart 对比
| 因子 | Vast.ai | GPU Mart |
|---|---|---|
| 基础设施模型 | GPU 市场/云服务 | GPU托管 |
| 动态市场定价 | 是的 | 不 |
| 按月计费的 GPU 服务器 | 保留选项 | 高度关注 |
| 每小时 GPU | 核心模型 | 精选方案 |
| 无服务器 | 是的 | 非核心产品 |
| 专用GPU托管 | 取决于市场 | 高度关注 |
| 最适合 | 灵活的按需人工智能计算 | 持久化 GPU 服务器 |
Vast.ai 的架构通常围绕灵活的按量计费计算服务展开,而 GPU Mart 则更侧重于持久型 GPU 虚拟专用服务器(VPS)和专用 GPU 托管服务。.
Vast.ai 的优缺点
| 优点 | 缺点 |
|---|---|
| 具有市场竞争力的定价 | 价格随时都在变动 |
| 20,000+ 块 GPU | 机器的质量可能有所不同 |
| 68+ 种 GPU 类型 | 比简单的固定价格云服务更为复杂 |
| 消费级和企业级GPU | 最便宜的主机未必是最好的 |
| RTX 4090 和 RTX 5090 | 可中断实例可以被回收 |
| A100、H100 和 H200 | 存储和网络需要分别进行评估 |
| B200 和 B300 | 市场供应情况的变化 |
| 按秒计费 | 生产工作负载需要谨慎选择主机 |
| 可中断服务折扣 | 分布式基础设施的标准化程度较低 |
| 无服务器 | — |
| GPU 集群 | — |
| CLI、API 和 SDK | — |
哪些人应该考虑使用 Vast.ai?
Vast.ai 特别适用于:
- 人工智能开发者
- 机器学习工程师
- LLM开发者
- 研究人员
- 人工智能初创企业
- 生成式人工智能项目
- 微调
- AI推理
- 批处理
- 渲染
- GPU实验
- 对成本敏感的人工智能工作负载
当用户希望对比多款设备和多种GPU类型,以实现性价比最大化时,该功能尤为实用。.
哪些人可能会更倾向于选择其他方案?
对于希望采用完全标准化的硬件、固定实例配置、高度可预测的定价,或深度集成的超大规模云生态系统的团队而言,可能更倾向于选择一家更传统的云服务提供商。.
同样,对于那些只想租用一台长期稳定的月租GPU服务器、而不愿比较市场上的各类服务列表的用户来说,传统的GPU托管服务可能更易于管理。.
Vast.ai 价格便宜吗?
Vast.ai 能够提供极具竞争力的 GPU 价格,因为服务提供商是在一个市场中相互竞争,而不是遵循一个集中式的固定价格目录。.
然而,每小时报价最低的方案并不一定就是成本最低的基础设施。.
请考虑:
GPU 价格 + 性能 + 可靠性 + 存储 + 网络 + 运行时 = 实际 AI 计算成本。.
如果一款更快的 GPU 虽然每小时成本更高,但能显著更快地完成工作负载,那么其实际成本反而可能更低。.
有关当前的替代方案,请参阅我们的
超值GPU租赁优惠
比较。.
Vast.ai 评测:最终总结
Vast.ai 已发展成为一个广泛的人工智能基础设施平台,而不再仅仅是一个低价闲置 GPU 的交易市场。.
其当前的生态系统涵盖超过 20,000 个 GPU、68 多种 GPU 类型、GPU 云、无服务器推理、多节点集群、按秒计费、API 驱动的部署,以及从 RTX 级消费级 GPU 到 H100、H200、 B200和B300加速器等各类硬件。.
市场模式既是其最大的优势,也是其主要取舍。.
服务提供商之间的竞争可以带来极具吸引力的价格和异常丰富的硬件选择,但其基础设施的标准化程度不如集中式云服务。用户需要综合比较可靠性、CPU、内存、存储、网络、地理位置和安全性等因素,而不能仅凭GPU型号和每小时价格来选择。.
对于希望根据实际工作负载优化基础设施的 AI 开发者而言,Vast.ai 提供了相当大的灵活性。.
租房前,请按照以下决策流程操作:
工作负载 → 模型规模 → 显存 → GPU → 可靠性 → 存储 + 网络 → 按需 / 可中断 / 预留 → 基准测试 → 总成本。.