

AMD Instinct MI300X GPU 服务器评测:HBM、ROCm 及大型语言模型(LLM)部署成本
部署大型语言模型需要在GPU内存、推理吞吐量、软件兼容性以及基础设施成本之间取得精妙的平衡。一款强大的加速器可以降低硬件需求,但前提是其性能必须与应用相匹配。AMD……
NVIDIA L40S GPU 服务器评测:48GB 显存、渲染及 AI 推理成本
选择用于人工智能推理或专业渲染的GPU服务器,不能仅靠比较理论处理能力。内存容量、工作负载兼容性、部署成本以及持续利用率,这些因素共同决定了加速器能否带来实际价值。NVIDIA……
适用于VPS主机的AMD EPYC 9005:核心密度、NUMA与虚拟化成本
现代VPS主机性能不仅取决于物理服务器内部的CPU核心数量。内存局部性、处理器调度、存储性能以及资源竞争,共同决定了虚拟机在负载下的性能表现是否稳定。AMD……
NVIDIA H100 GPU 服务器评测:用于大型语言模型(LLM)训练——HBM、NVLink 及租赁经济性
训练大型语言模型不仅需要GPU的原始计算能力。内存容量、内存带宽、GPU间通信、存储吞吐量以及基础设施利用率都会影响训练任务的完成速度。NVIDIA H100 GPU服务器……
NVIDIA H200 GPU 服务器评测:HBM 内存、大型语言模型推理及托管成本
大型语言模型改变了企业评估GPU服务器的方式。虽然原始计算性能依然重要,但GPU内存容量、内存带宽、互连技术以及基础设施成本在决定部署是否可行方面发挥着越来越重要的作用。这款NVIDIA H200……
英特尔至强 6 专用服务器评测:核心密度、功耗及工作负载适配性
仅凭处理器品牌来选择专用服务器可能会导致代价高昂的失误。两台标有“英特尔至强 6”名称的服务器,其性能表现可能截然不同,因为它们的处理器侧重于不同的计算类型……
AMD EPYC Turin 服务器评测:CPU 密度、内存与虚拟化性能
服务器采购者通常会根据核心数来比较处理器,但核心数越多并不一定意味着应用程序性能就越好。内存带宽、CPU 频率、虚拟化开销、存储以及软件许可同样可能……
NVIDIA RTX PRO 6000 Blackwell 服务器评测:96GB 显存与 AI 工作负载
运行大型AI模型已不再仅仅取决于原始计算能力。GPU内存容量、推理吞吐量、软件兼容性以及长期运营成本,在很大程度上决定了部署能否成功。这款NVIDIA RTX PRO 6000 Blackwell……
AMD Instinct MI350 系列云端产品评测:ROCm 支持、GPU 内存与 AI 部署
本篇关于 AMD Instinct MI350 云服务的评测,重点探讨了 AMD Instinct MI350X、MI355X 和 MI350P 加速器、ROCm 软件兼容性、高带宽 GPU 内存、云服务可用性,以及在 AI 训练和推理方面的实际部署注意事项。AMD Instinct…
无服务器 GPU 平台评测:冷启动、自动扩展和生产环境中的 AI 成本
本篇关于无服务器 GPU 平台的评测,对比了现代 AI 推理基础设施背后的技术、部署模式和运营成本。我们分析了 GPU 冷启动、自动扩展行为、并发性、延迟、利用率以及实际生产环境中的服务成本……
NVIDIA Blackwell GPU 云服务评测:B200、GB200 及 AI 基础设施采购考量
本篇关于 NVIDIA Blackwell GPU 云服务的评测,从 AI 基础设施采购的角度出发,对 B200、GB200 Grace Blackwell 超级芯片以及 GB200 NVL72 进行了分析。对于部署大型语言模型、推理系统、生成式 AI 应用以及分布式……
VPSServer 评测:云VPS定价、性能、功能及优缺点
VPSServer.com 是一家全球性的云 VPS 服务提供商,专注于提供灵活的虚拟服务器、NVMe 存储、按小时和按月计费、可扩展的资源、Windows 和 Linux 支持,以及丰富的国际服务器机房选择。其入门级云……
AccuWeb 主机评测:网站托管、Windows VPS、价格与性能
AccuWeb Hosting 围绕经济实惠的网站托管、WordPress、Windows 托管、Linux 和 Windows VPS、云基础设施、应用程序托管以及专用服务器,构建了广泛的服务组合。该公司特别突出的一个领域是……
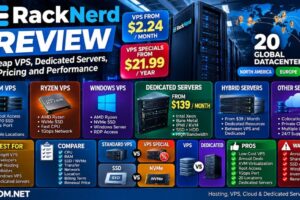
RackNerd 评测:经济实惠的 VPS、独立服务器、价格与性能
RackNerd 通过提供低成本的 KVM 虚拟服务器、频繁推出的年度 VPS 特惠活动、专用服务器、多个全球机房,以及面向开发者、自主托管用户、网站所有者和小……的基础设施,在注重预算的 VPS 用户中赢得了大量拥趸。
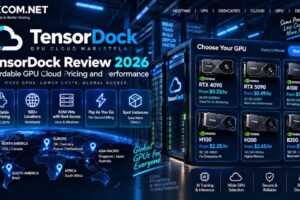
TensorDock 2026 年评测:经济实惠的 GPU 云服务定价与性能
GPU 云服务的费用可能会迅速攀升,特别是对于仅需一两个加速器来进行 AI 推理、图像生成、渲染或模型实验的开发者而言。TensorDock 采取了与传统超大规模云服务不同的方法……