部署大型语言模型需要在GPU内存、推理吞吐量、软件兼容性以及基础设施成本之间取得精妙的平衡。一款强大的加速器可以降低硬件需求,但前提是其性能必须与应用相匹配。.
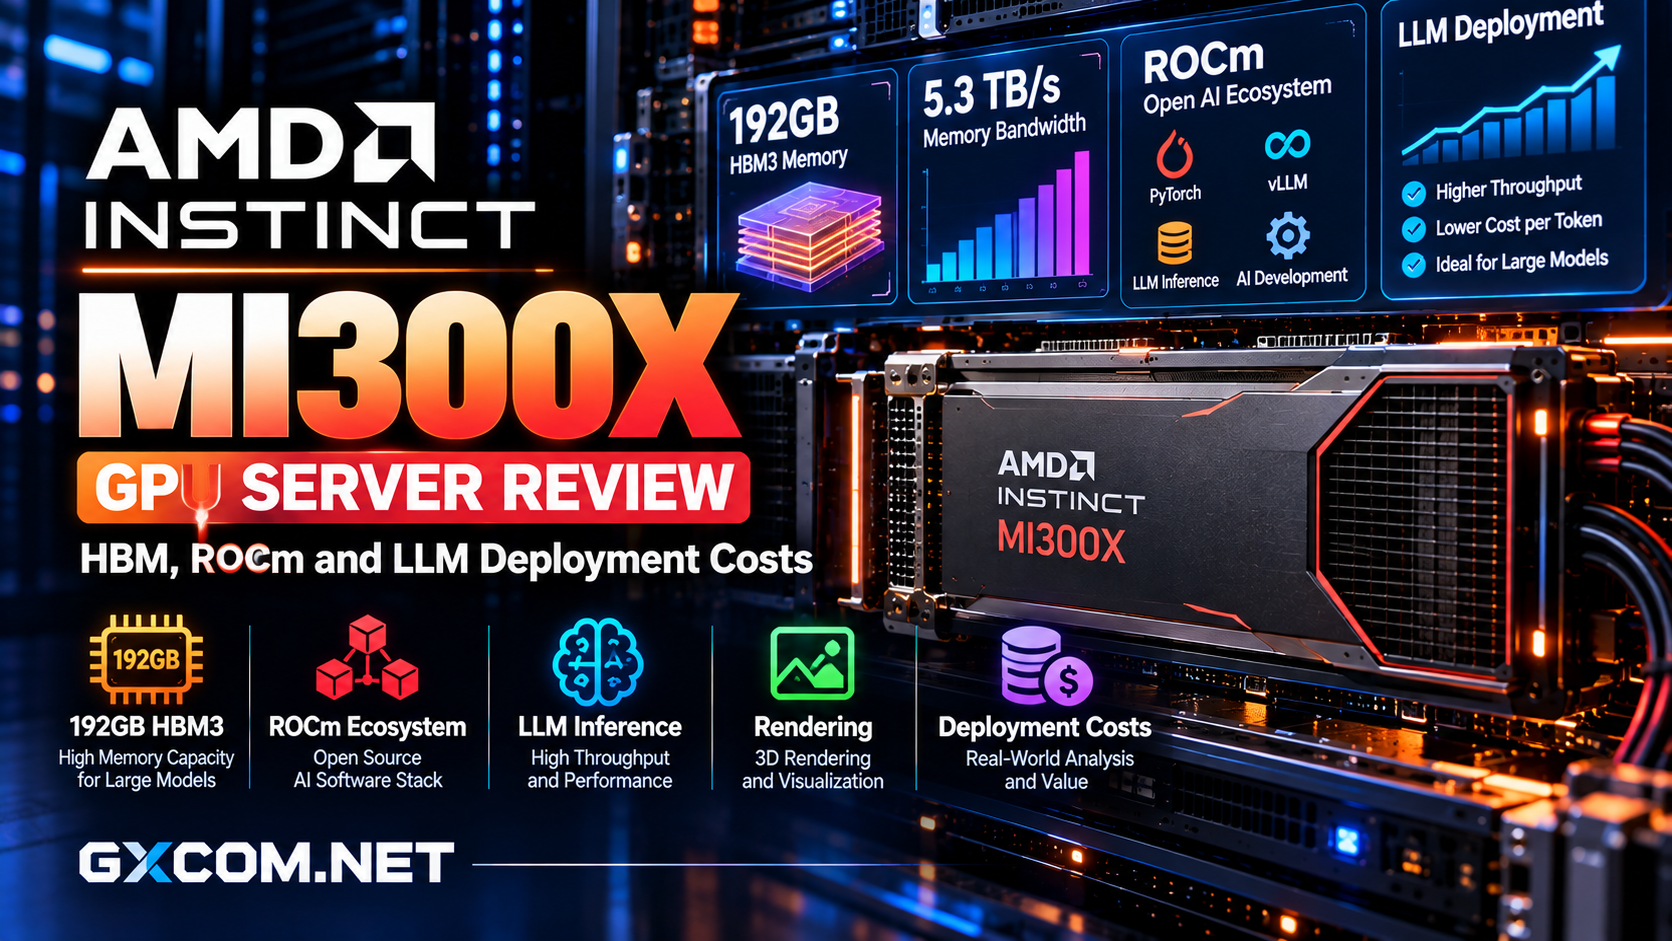
该 AMD Instinct MI300X GPU 服务器 专为要求严苛的人工智能和高性能计算工作负载而设计。凭借 192GB 的 HBM3 内存和 AMD 的 CDNA 3 架构,它为大型模型和内存密集型推理提供了强大的处理能力。.
然而,仅凭硬件规格无法判断 MI300X 是否比 NVIDIA 的替代方案更经济。ROCm 兼容性、部署复杂度以及实际 GPU 利用率也会影响最终成本。.
本评测探讨了 MI300X 的硬件、大型语言模型(LLM)的部署注意事项,以及租赁 AMD GPU 基础设施的经济性。.
AMD Instinct MI300X 规格参数
AMD推出了MI300X,作为一款面向生成式人工智能、模型训练、推理和科学计算的数据中心加速器。.
其规格包括 192GB HBM3 内存、最高 5.3TB/s 的理论内存带宽、304 个计算单元以及 19,456 个流处理器。.
该加速器支持FP8、BF16和FP16运算,其峰值板级功耗可达750W。.
| 规格 | AMD Instinct MI300X |
|---|---|
| 建筑 | AMD CDNA 3 |
| GPU 内存 | 192GB HBM3 |
| 内存带宽 | 最高可达 5.3TB/s |
| 计算单元 | 304 |
| 流处理器 | 19,456 |
| 互连 | AMD Infinity Fabric |
| 峰值板功率 | 750W |
以上为制造商提供的规格参数,并非实际应用中的测试基准。服务器配置和软件优化会影响实际性能表现。.
为什么192GB HBM3对大型语言模型(LLMs)至关重要
大型语言模型会占用 GPU 内存来存储模型权重、激活值、运行时缓冲区和键值缓存。.
MI300X 拥有 192GB 的容量,可减少将某些推理工作负载分配到多个加速器上的需求。.
举例来说,一个包含700亿个参数、每个参数占用2字节存储空间的模型,仅权重部分就需要大约140GB的存储空间。运行时的开销和缓存需求会进一步增加总存储消耗。.
量化可以降低内存需求,但由此产生的吞吐量和模型质量取决于具体实现方式。.
内存带宽与令牌生成
LLM推理通常涉及在GPU内存与计算单元之间传输大量数据。.
MI300X 5.3TB/s 的理论带宽对于受内存限制的操作尤为重要。尽管如此,更高的带宽并不能保证令牌生成速度会成比例地加快。.

批量大小、注意力机制的实现方式、模型架构以及推理软件共同决定了实际结果。.
我们的 NVIDIA GPU 服务器供应商指南 提供了更多的硬件对比。.
ROCm:软件兼容性问题
AMD的ROCm平台为受支持的Instinct加速器提供了GPU计算工具、库以及框架集成。.
ROCm 支持使用 PyTorch 及兼容的推理框架实现重要的机器学习工作流。.
不过,专门针对 NVIDIA CUDA 开发的应用程序,可能需要进行一些修改,才能在 AMD 硬件上高效运行。.
自定义 CUDA 扩展、专用内核以及第三方依赖项值得特别关注。.
在 MI300X 上部署 vLLM
AMD 提供了在启用 ROCm 的环境中运行 vLLM 的文档。基于容器的部署可以简化依赖项管理并提高可重复性。.
典型的操作流程包括:选择一个受支持的 Linux 环境、安装相应的 GPU 驱动程序、使用兼容的 ROCm 容器、加载模型权重,以及验证推理请求。.
在进行生产部署之前,请确认 ROCm、PyTorch、vLLM、模型架构以及量化格式之间的兼容性。.
不要认为 CUDA 上可用的优化在 ROCm 中就有完全相同的实现。.
多GPU服务器与Infinity Fabric
AMD的MI300X平台集成了八个加速器,总计配备1.5TB的HBM3内存。.
Infinity Fabric 为受支持的多加速器操作提供高速 GPU 互连。.
该架构可支持需要张量并行或分布式处理的大型模型部署。.
然而,拥有8个GPU并不意味着性能会自动提升8倍。通信开销、模型分区以及网络拓扑都会影响扩展效率。.
对于多节点部署,在构建大型集群之前,请先验证服务器互连和分布式框架的配置。.
MI300X 与 NVIDIA H100 对比
与标准的 80GB H100 配置相比,MI300X 每个加速器的内存容量更大。.
这种差异可以简化某些大型模型的推理部署,在这些部署中,GPU内存是主要限制因素。.
H100 得益于 NVIDIA 成熟的 CUDA 生态系统以及基于 NVLink 的专用多 GPU 基础设施。.
要在它们之间做出选择,需要对相同的模型、数值精度、批处理大小和延迟目标进行测试。.
对于高度依赖 CUDA 的团队而言,软件成熟度和工程投入可能比硬件规格更为重要。.
MI300X GPU 租赁的经济效益
最有意义的比较是每项完成的工作负载的成本,而不是每小时的GPU租赁费率。.
对于大型语言模型(LLM)的推理,有用的指标包括每秒生成的令牌数、请求延迟、GPU利用率以及每百万个输出令牌的成本。.
每百万代币成本 = 总计费成本 / 生成的代币数量 × 1,000,000
假设某套假想的 GPU 部署每小时成本为 $2,且在该小时内生成 500,000 个输出令牌。.
每百万个输出代币的计算成本为 $4,其中不包括存储、网络和运营费用。.
此示例仅供说明,并非MI300X的实际基准测试结果,亦非当前供应商的报价。.
隐藏的部署成本
ROCm 迁移、模型优化、GPU 空闲时间、持久化存储以及工程支持都会影响总支出。.
长期运行的推理服务应针对持续性工作负载进行基准测试,而不是依赖于短期的性能测试。.
我们的 经济实惠的GPU服务器对比 探讨了相关的基础设施采购决策。.
MI300X 托管服务商及替代方案
Vultr:AMD Instinct 云端 GPU
Vultr 正式提供 MI300X GPU 云基础设施以及基于 ROCm 的部署资源。.
对于希望评估 AMD 加速功能但又无需购买物理服务器的团队而言,这是一个合适的选择。请确认所在地区的可用性、实例配置以及当前的计费条件。.
RunPod:替代性 GPU 云工作流
RunPod 为模型开发和推理提供基于GPU的云基础设施。.

根据您的 MI300X 需求,对比可用的加速器型号、容器工作流和持久化存储选项。.
Cherry Servers:专用基础设施
Cherry 服务器 提供专用的服务器基础设施,以支持持续的计算工作负载。.
在考虑裸机方案时,应评估其可用的GPU配置及管理要求。.
GPU Mart:专用GPU托管服务
GPU Mart 为优先处理长时间运行工作负载的组织提供专用 GPU 服务器选项。.
在将该产品的功能与 MI300X 部署方案进行比较之前,请先确认可用的加速器及软件兼容性。.
探索我们的 AI GPU VPS 服务商对比 以及 裸机服务器提供商指南 查看更多选项。.
哪些人适合选择 AMD MI300X?
MI300X 特别适合内存密集型的大型语言模型(LLM)推理、大型模型实验,以及准备运行基于 ROCm 的软件的组织。.
当应用程序高度依赖不受支持的 CUDA 特定组件时,或者当较小的 GPU 已经能够满足吞吐量要求时,这种方案可能不太合适。.
租赁前,请对实际机型进行对比评估,核实软件兼容性,并估算完整的部署成本。.
最终裁决
该 AMD Instinct MI300X GPU 服务器 将海量的HBM3容量与高内存带宽相结合,并拥有日益强大的ROCm软件生态系统。.
其最大的机遇在于大型模型工作负载,在这些场景中,内存容量能够降低部署复杂性。.
然而,最佳采购决策取决于经过验证的推理吞吐量、软件兼容性、运维开销以及每项完成的工作负载的总成本。.