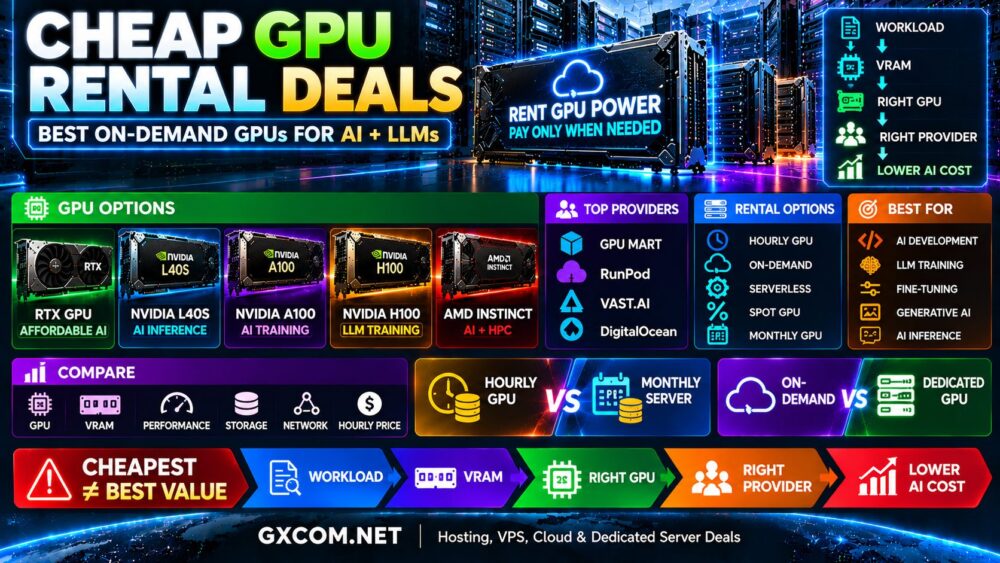
租用 GPU 计算能力已成为构建人工智能应用程序的最便捷方式之一,无需在实体硬件上花费数千美元。开发人员现在可以按小时租用强大的 NVIDIA 和 AMD 加速器,用于大型语言模型(LLM)训练、生成式人工智能、机器学习、推理、图像生成以及其他需要大量 GPU 资源的工作负载。.
但要找到 最划算的显卡租赁优惠 这不仅仅需要按每小时价格对服务商进行排序。GPU内存、性能、存储、网络、计费粒度、可用性以及工作负载持续时间,都可能对AI项目的实际成本产生巨大影响。.
本指南对比了来自 RunPod, Vast.ai, GPU Mart, DigitalOcean, ,以及其他基础设施模型。我们还对比了 RTX、L40S、A100、H100 和 AMD 显卡的租赁方案,以帮助您在性能与成本之间找到最佳平衡点。.
超值GPU租赁优惠一览
| 服务提供商 | 租赁模式 | 最适合 | 定价方式 |
|---|---|---|---|
| RunPod | GPU云 | 人工智能、大型语言模型与开发 | 按使用量计费 |
| Vast.ai | GPU 市场 | 经济型 GPU 计算 | 市场驱动 |
| GPU Mart | 按小时计费的GPU托管服务 | 开发和持续性工作负载 | 按小时 + 按月 |
| DigitalOcean | GPU云 | 云原生人工智能 | 按需 / 预留 |
GPU 的租赁价格和可用性经常发生变化。在部署工作负载之前,请务必核实最新价格、完整的实例规格、计费条款以及区域可用性。.
什么是按需GPU租赁?
按需 GPU 租赁服务让您无需购买实体硬件,即可使用 GPU 计算基础设施。.
根据服务提供商的不同,计费可能按秒、分钟、小时或其他计费周期进行计算。.
该模型特别适用于:
- 人工智能开发
- LLM 训练
- 模型微调
- AI推理
- 机器学习
- 生成式人工智能
- 图像生成
- 渲染
用户无需购买可能在项目间隙处于闲置状态的GPU服务器,而可以在需要时调配GPU资源,并在工作负载完成后释放这些资源。.
GPU租赁的价格能有多低?
入门级 GPU 云资源的每小时费用可能远低于 1 美元,而 NVIDIA H100、H200、B200 和 B300 等高端 AI 加速器的每 GPU 小时费用则可能达到几美元。.
关键问题不仅仅在于“哪款显卡最便宜?”
更好的问题是:
哪款GPU能以最低的总成本完成我的工作负载?
例如,即使某款GPU的每小时成本是另一款的两倍,但只要它能显著更快地完成训练任务,总体上仍可能更划算。.
当前 GPU 租赁价格示例
| GPU | 使用示例 | 当前 RunPod 安全云参考文档 |
|---|---|---|
| RTX A5000 24GB | 人工智能开发 | 约$0.27/小时 |
| RTX 4090 24GB | 生成式人工智能 | 约 $0.74/小时 |
| L40S 48GB | 推论 | 约 $1.09/小时 |
| A100 80GB | 训练与微调 | 约 $1.59/小时 |
| H100 PCIe 80GB | LLM 训练 | 约 $2.89/小时 |
| H100 SXM 80GB | 高端人工智能训练 | 约 $3.49/小时 |
这些数字仅供参考,并非固定价格。随着服务商调整运力、产品和基础设施,GPU云服务的定价也会随之变化。.
RunPod:面向人工智能的灵活GPU租赁服务
RunPod 通过其专注于人工智能的云平台,提供种类繁多的 GPU。.
当前可选的产品涵盖了从经济实惠的开发级 GPU 到大内存、高性能加速器,使该平台能够胜任从实验到大型语言模型(LLM)训练等各类工作负载。.
RunPod 对于以下人群尤其具有吸引力:
- 人工智能开发
- LLM 训练
- 微调
- 生成式人工智能
- 推论
- 临时GPU工作
RTX 级显卡等低成本 GPU 可以降低开发成本,而 A100、H100、H200 以及更新一代的加速器则能够处理要求更高的模型。.
该模型的主要优势在于灵活性:开发人员可以根据项目的各个阶段选择相应的GPU类别,而无需为每项任务都使用昂贵的训练硬件。.
Vast.ai:经济实惠的GPU租赁平台
Vast.ai 的运营模式与传统的标准化云服务提供商不同。.
其交易平台允许用户搜索由大量分布式机器提供的GPU资源。价格受供需关系影响,可能会动态变化。.
这使得 Vast.ai 对正在寻找低价 GPU 租赁服务的用户来说尤为吸引人。.
不过,比较时不要只看价格。市面上的机器在以下方面可能存在差异:
- GPU 型号
- GPU数量
- 主机可靠性
- CPU性能
- 系统内存
- 存储
- 网络性能
- 位置
- 可用性
对于能够容忍主机之间差异的灵活工作负载而言,市场竞争可以带来极具吸引力的GPU成本效益。.
GPU Mart:低成本按小时计费的GPU托管服务
除了长期托管服务外,GPU Mart 还提供按需付费的 GPU VPS 和服务器方案。.
其按小时计费的 GPU 服务适用于测试、开发、实验以及短期项目——在这些情况下,长期租用整台月租制 GPU 服务器可能并不划算。.
GPU Mart 宣传的入门级按小时计费方案起价约为 $0.20 左右,不过最终价格取决于具体的 GPU 型号和完整配置。.
服务商同时提供按小时和按月两种计费方式的一大优势在于,用户可以先从短期GPU租赁开始,之后再比较对于持续性工作负载而言,按月租用服务器是否更经济。.
DigitalOcean:按需 GPU 云服务
DigitalOcean 作为其更广泛的云基础设施的一部分,提供按需 GPU Droplets 服务。.
其当前的GPU产品组合包括NVIDIA H100、H200、L40S、RTX系列GPU以及AMD Instinct加速器等产品。.
这使得 DigitalOcean 对于需要同时使用 GPU 计算的开发者来说具有重要意义:
- 云虚拟机
- 存储
- 人际网络
- 数据库
- 应用基础设施
与专业市场相比,DigitalOcean 提供的独立 GPU 价格未必总是最低的,但与更广泛的开发者云平台的集成对于生产环境中的 AI 应用而言具有重要价值。.
廉价GPU租赁服务商对比
| 服务提供商 | 强度 | 合身 | 请注意 |
|---|---|---|---|
| RunPod | 丰富的GPU选择 | AI 和 LLM 工作负载 | GPU 供应情况 |
| Vast.ai | 市场竞争 | 经济型计算 | 机器之间的差异 |
| GPU Mart | 按小时和按月计费选项 | 开发和持久化 GPU | 完整服务器规格 |
| DigitalOcean | 云生态系统 | 生产级人工智能应用 | 基础设施总成本 |
RTX 显卡租赁:是否是经济实惠的 AI 开发最佳选择?
在转向昂贵的数据中心加速器之前,通常值得先评估一下 RTX 级别的 GPU。.
它们在以下方面能提供极高的性价比:
- 人工智能开发
- 模型实验
- Stable Diffusion
- 图像生成
- 计算机视觉
- 较小的LLM
- 渲染
主要限制因素通常是VRAM。.
当模型能够轻松装入内存时,24GB的GPU性价比极高;但当工作负载需要显著更多的GPU内存时,它就不再适用。.
L40S 租赁:均衡的人工智能推理
NVIDIA L40S 配备 48GB 级别的 GPU 内存,将 AI 加速与图形处理能力相结合。.
以下人群可能会对此感兴趣:
- AI推理
- 生成式人工智能
- 图像生成
- 计算机视觉
- 可视化
- 渲染
对于无需高端 H100 基础设施的推理工作负载,L40S 可以在价格实惠的 RTX 硬件与高端训练加速器之间提供一个实用的折中方案。.
A100 租赁:AI 训练的超值之选
NVIDIA A100 在训练、微调、机器学习和人工智能研究领域依然具有重要作用。.
随着新一代产品的推出,A100的价格使其成为一种值得考虑的选择,适用于那些并不特别需要H100级性能的工作负载。.
当GPU内存需求超过经济实惠的消费级或工作站级GPU所能提供的容量时,A100 80GB就显得尤为实用。.
H100 租赁:最适合高端 LLM 工作负载
NVIDIA H100 专为高负载的人工智能工作负载而设计,包括大型语言模型的训练和高性能推理。.
只有当工作负载确实能充分发挥H100的性能时,租赁H100才是最明智的选择。.
在支付保费之前,请先询问:
- 该模型需要达到这种性能水平吗?
- 它需要80GB级别的GPU内存吗?
- 是否需要多GPU训练?
- 加快培训进度能否降低项目总成本?
- A100 或 L40S 够用吗?
有关 H100 的专属优惠,请参阅我们的
NVIDIA H100 GPU 服务器优惠活动
比较。.
最划算的大语言模型(LLM)GPU租赁服务
大型语言模型(LLM)的工作负载差异极大,因此并不存在一款适用于所有语言模型的最佳GPU。.
| LLM 工作量 | GPU 评估方向 |
|---|---|
| 开发与测试 | RTX / 经济实惠的 GPU 云服务 |
| 小型模型推理 | RTX / L40S |
| 微调 | L40S / A100 / H100(视型号而定) |
| 大型模型推理 | A100 / H100 / 高内存版本 |
| 大型语言模型(LLM)训练 | H100 / H200 / 多GPU基础设施 |
如需更深入的工作负载比较,请阅读我们的
最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器
指南。.
按小时租赁 GPU 与按月租赁 GPU 服务器
按小时计费的廉价GPU租赁,算下来整个月未必更划算。.
| 用法 | 用于比较的模型 |
|---|---|
| 每月几小时 | 每小时 GPU |
| 短期开发项目 | 按需GPU |
| 不定期培训 | 每小时 GPU |
| 变量推断 | 云 / 无服务器 |
| 持续使用 GPU | 按月计费 / 专用 GPU |
| 稳定生产的AI | 比较预留和月度 |
一个简单的初步计算是:
预计每月计算成本 = GPU 每小时费率 × GPU 使用小时数
然后加上存储、数据传输以及其他任何基础设施费用。.
按需租用与现货租用 GPU 的对比
一些供应商还提供现货或可中断的GPU算力。.
这些资源的成本可能低于标准的按需实例,因为服务提供商可以在需要时回收这些资源的容量。.
现货GPU适用于以下场景:
- 容错训练
- 批处理
- 实验
- 带检查点的工作负载
- 可以重新启动的作业
对于需要 GPU 持续可用性的应用场景,它们的适用性较低。.
GPU租赁与专用GPU服务器
| 因子 | 按需 GPU | 专用GPU服务器 |
|---|---|---|
| 承诺 | 低 | 通常较高 |
| 缩放 | 灵活的 | 取决于硬件 |
| 账单 | 按使用量计费 | 通常每月一次 |
| 部署 | 快 | 取决于提供商 |
| 最适合 | 可变的工作量 | 稳定的工作负载 |
如果 GPU 需要持续运行,请将每月的总成本与专用服务器的成本进行比较,而不是一味认为按小时租赁更便宜。.
请参阅我们的
最佳独立显卡服务器
长期运行的AI基础设施指南。.
廉价GPU租赁中的隐性成本
GPU的每小时费用仅占账单的一部分。.
请检查:
- 持久化存储费用
- 数据传输费
- 快照
- 闲置资源计费
- CPU 和内存费用
- 最短计费周期
- 公共IP费用
- 无服务器请求费用
计费方式尤为重要。有些服务即使在虚拟机关机后,仍会继续对已预留的资源收取费用。.
如何为您的 AI 工作负载找到最便宜的 GPU
- 确定工作负载。.
- 确定所需的最小显存容量。.
- 选择几款合适的GPU型号。.
- 对工作负载性能进行基准测试或估算。.
- 比较每小时费率。.
- 检查 CPU、内存、存储和网络的规格。.
- 估算实际 GPU 运行时长。.
- 加上存储和带宽成本。.
- 比较按小时和按月计费的方案。.
- 根据总工作量成本进行选择。.
租用廉价GPU时应避免的错误
选择最低的小时价格
如果工作负载耗时明显更长,那么性能较低的 GPU 总体上可能反而更昂贵。.
忽略显存
如果模型无法高效地装入显存中,那么再便宜的GPU也毫无用处。.
使用 H100 进行开发
许多开发和测试任务可以在价格低得多的 RTX 级 GPU 上运行。.
让 GPU 实例处于空闲状态
未被利用的GPU资源可能会让原本经济实惠的租赁服务迅速变成一笔昂贵的账单。.
忽略市场中的机器质量
在使用市场平台基础设施时,应综合评估整台机器和主机,而不仅仅关注 GPU 的价格。.
廉价的GPU租赁方案值得尝试吗?
对于许多人工智能项目来说,确实如此。.
按需租用 GPU 消除了购买硬件所需的前期成本,并使开发人员能够根据工作负载需求的变化在不同代的 GPU 之间进行切换。.
RunPod 提供种类繁多的以人工智能为重点的 GPU;Vast.ai 提供基于市场机制的竞争模式;GPU Mart 结合了按小时和按月计费的托管方案;而 DigitalOcean 则将 GPU 计算整合到更广泛的开发者云服务中。.
最佳平台的选择取决于 GPU、工作负载、所需可靠性、利用率以及周边基础设施。.
结语
最便宜的GPU租赁服务,未必就是每小时价格最低的那款GPU。.
RTX级GPU在开发和小型AI工作负载方面能提供极高的性价比。L40S在推理和生成式AI方面能实现良好的平衡。A100在训练和微调方面依然具有重要作用,而H100及更新一代的加速器则主要面向要求严苛的大型语言模型(LLM)和高性能AI工作负载。.
首先从工作负载出发,确定您实际所需的最低GPU内存和性能。然后对比各服务商的方案、计费模式、存储、网络以及预期利用率。.
更好的决策路径是:
工作负载 → 显存 → GPU → 供应商 → 每小时成本 → 工作负载总成本。.