随着企业训练规模更大的模型、部署生成式人工智能应用、运行海量推理任务以及处理日益复杂的数据集,人工智能工作负载的要求也越来越高。.
云GPU 提供了极佳的灵活性,但对于需要持续运行的工作负载而言,另一种基础设施模型可能更适合: 专用GPU服务器.
专用 GPU 服务器可让您的工作负载访问预留的 GPU 资源,同时提供专为高强度计算任务配置的 CPU、内存、存储和网络资源。根据服务提供商的不同,可用的加速器范围从经济实惠的 RTX 级 GPU 到 NVIDIA A100、L40S、H100、H200 以及 AMD Instinct 硬件不等。.
本指南对比了适用于人工智能、机器学习、大型语言模型(LLM)、推理、渲染及其他GPU密集型工作负载的最佳专用GPU服务器选项。我们还探讨了 GPU Mart, 数据库集市, RunPod, Vast.ai, DigitalOcean, ,以及专用服务器与GPU云基础设施之间的区别。.
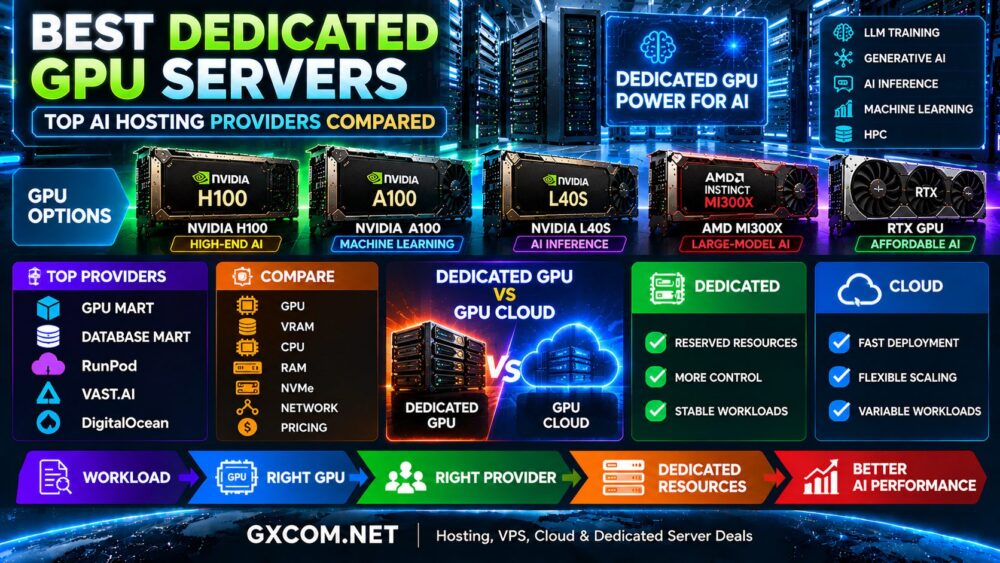
最佳独立显卡服务器一览
| 服务提供商 / 平台 | 基础设施风格 | 最适合 |
|---|---|---|
| GPU Mart | 以GPU为核心的托管服务 | 持续性的 GPU 工作负载 |
| 数据库集市 | 服务器和GPU基础设施 | 传统的服务器部署 |
| RunPod | GPU 云 / AI 基础设施 | 灵活的 AI 工作负载 |
| Vast.ai | GPU 市场 | 注重成本的GPU计算 |
| DigitalOcean | 云端、专用和裸机 GPU 选项 | 云原生人工智能基础设施 |
这些服务商采用不同的基础设施模型,因此不应仅根据其宣传的GPU价格进行比较。正确的选择取决于您需要的是专用硬件、灵活的云算力、市场定价,还是上述方案的组合。.
什么是专用GPU服务器?
专用 GPU 服务器是一种基础设施,其中 GPU 资源专用于您的工作负载,而非在计算层面上与无关的客户共享。.
一台典型的专用 AI 服务器通常包含以下组件:
- 一个或多个GPU
- 专用 CPU 资源
- 系统内存
- NVMe 或 SSD 存储
- 高速网络
- Linux 或其他受支持的操作系统
- GPU驱动程序和人工智能软件
根据服务的不同,基础设施可能以传统物理专用服务器、裸机 GPU 服务器、预留 GPU 实例或其他专用资源模式的形式提供。.
请务必核查服务商的具体架构,不要一味认为所有标榜为“专用 GPU”的产品都完全相同。.
为什么选择专用GPU服务器?
当GPU需求稳定且可预测时,专用GPU基础设施便颇具吸引力。.
常见的优势包括:
- 预留的GPU资源
- 可预测的硬件访问
- 对基础设施的更大控制权
- 持久化存储
- 定制化软件环境
- 长期运行的工作负载
- 多GPU配置
其取舍在于灵活性。专用服务器通常具有固定的硬件配置,而GPU云基础设施则更便于增减算力。.
专用AI服务器的最佳GPU
GPU 是 AI 服务器中最重要的组件,但并没有一种加速器能完美适用于所有工作负载。.
| GPU | 最适合 | 主要优势 |
|---|---|---|
| NVIDIA H100 | 大语言模型(LLM)训练与高端人工智能 | 卓越的人工智能性能 |
| NVIDIA A100 | 机器学习与深度学习 | 成熟的人工智能生态系统 |
| NVIDIA L40S | 推理与图形 | 人工智能 + 可视化 |
| AMD Instinct MI300X | 大型AI模型 | 大容量 GPU 内存 |
| RTX级显卡 | 人工智能的发展与可负担性 | 较低的入门成本 |
NVIDIA H100 专用服务器
NVIDIA H100 仍然是高端 AI 基础设施的重要选择。.
这尤其适用于:
- 大型语言模型的训练
- 生成式人工智能
- 大规模推理
- 深度学习
- 科学计算
- 高性能计算
H100 服务器提供多种配置,因此购买者应确认具体的 GPU 型号、内存、互连技术、GPU 数量、CPU 平台、RAM 以及存储配置。.
如需详细了解 H100 基础设施,请参阅我们的
NVIDIA H100 服务器托管
指南。.
NVIDIA A100 专用服务器
A100 在成熟的机器学习环境中依然实用,当供应商的定价使其比新型加速器更具成本优势时,它便颇具吸引力。.
A100 80GB 配置特别适用于:
- 机器学习
- 深度学习
- 微调
- 人工智能研究
- 数据科学
- 推论
不要仅仅因为出现了新一代产品就忽视某款加速器。对于实际工作负载而言,性价比比 GPU 的年代更重要。.
NVIDIA L40S 专用服务器
NVIDIA L40S 将 AI 加速与图形处理能力相结合,对于那些不需要高端 H100 级训练基础设施的工作负载而言,它是一个值得考虑的选择。.
L40S 特别适用于:
- AI推理
- 生成式人工智能
- 图像生成
- 计算机视觉
- 渲染
- 可视化
对于混合型人工智能和图形工作负载而言,这种多功能性非常宝贵。.
AMD MI300X 专用 AI 服务器
各组织还应考虑采用AMD的产品,而非仅将基础设施评估局限于NVIDIA。.
AMD Instinct MI300X 配备 192GB HBM3 内存,这使其在内存密集型人工智能和大型语言模型工作负载方面尤为引人关注。.
主要考虑因素是软件兼容性。NVIDIA的基础架构以CUDA为核心,而AMD Instinct则采用ROCm。.
请阅读我们的
AMD Instinct MI300X 服务器
深入比较指南。.
顶级专用GPU服务器提供商
各家GPU托管服务提供商在基础设施设计、计费方式、GPU选型、区域、网络、存储以及技术支持等方面存在显著差异。以下平台展示了几种不同的GPU计算访问方式。.
GPU Mart
GPU Mart 专注于以 GPU 为核心的托管服务,主要面向需要为人工智能、机器学习、渲染及相关工作负载配置持久性 GPU 计算资源的客户。.
其以服务器为中心的模式使其在比较长期运行的GPU基础设施(而非仅限于临时云实例)时尤为适用。.
下单前,请比较:
- 确切的 GPU 型号
- 专用GPU分配
- CPU 规格
- 系统内存
- NVMe 存储
- 网络端口速度
- 带宽配额
- 部署时间
- 合同期限
数据库集市
Database Mart 提供更广泛的服务器托管服务组合,其中不仅包括传统的服务器基础设施,还涵盖了 GPU 计算选项。.
因此,对于那些更倾向于传统服务器管理和持久化基础设施,而非纯粹基于使用量的GPU云计算的用户而言,这款产品值得评估。.
在将 Database Mart 与以 GPU 为核心的服务进行比较时,应关注完整的服务器配置,而不仅仅是已安装的显卡。.
RunPod
RunPod 则采取了一种不同的方式。它主要是一个以人工智能为核心的 GPU 云平台,而非传统的按月计费的专用服务器托管服务。.
当用户希望访问多种GPU类别,同时又能随着工作负载的变化灵活调整容量时,该基础设施便极具吸引力。.
RunPod 尤其适合以下人群:
- 人工智能开发
- LLM 训练
- 微调
- AI推理
- 临时 GPU 工作负载
- 测试不同的GPU
这种灵活性使得 RunPod 成为与传统专用 GPU 托管服务进行对比的理想参照点。.
Vast.ai
Vast.ai 运营着一个 GPU 计算资源交易平台。.
它并非完全像一家传统的专用服务器公司那样运作,而是采用市场模式,允许用户对比不同服务商提供的GPU服务器。.
这虽然能为注重成本的人工智能计算创造有吸引力的机会,但用户在评估时不应仅考虑价格。.
请检查:
- 宿主特征
- GPU 型号
- GPU数量
- 可靠性
- CPU 和 RAM
- 存储性能
- 网络性能
- 可用性
DigitalOcean
DigitalOcean 将 GPU 基础设施与更庞大的云生态系统相结合。.
其 GPU 产品组合涵盖云端 GPU 部署以及专用和裸机 GPU 选项,因此非常适合希望将 GPU 加速与云计算、存储、网络、数据库及应用服务集成在一起的团队。.
对于云原生人工智能应用而言,该模型尤为有用,因为在这些应用中,GPU 服务器只是整体架构中的一个组成部分。.
专用GPU托管服务商对比
| 服务提供商 | 型号 | 主要优势 | 适合 |
|---|---|---|---|
| GPU Mart | 以GPU为核心的托管服务 | 持久化 GPU 基础设施 | 专用型工作负载 |
| 数据库集市 | 服务器托管 | 传统基础设施模式 | 长期运行的服务器 |
| RunPod | GPU云 | 灵活的 GPU 访问 | 可变的AI工作负载 |
| Vast.ai | 市场 | 广泛的价格竞争 | 对成本敏感的工作负载 |
| DigitalOcean | 云 + 专用 GPU | 更广泛的云生态系统 | 云原生人工智能 |
专用 GPU 服务器与 GPU 云的对比
最重要的基础设施决策可能并非选择哪家服务提供商,而是您是否真的需要专用基础设施。.
| 因子 | 专用GPU服务器 | GPU 云 |
|---|---|---|
| GPU 访问 | 保留 | 取决于服务 |
| 部署 | 取决于提供商 | 通常很快 |
| 缩放 | 取决于硬件 | 灵活的 |
| 账单 | 通常为每月一次或预留的 | 通常基于使用情况 |
| 控制 | 高 | 取决于平台 |
| 最佳工作负载 | 稳定的利用率 | 变量的使用 |
对于持续运行的 AI 工作负载,专用服务器可以提供可预测的 GPU 资源访问。对于临时训练任务、实验以及需求波动较大的情况,云基础设施则更具灵活性。.
请参阅我们的
NVIDIA GPU 服务器与 GPU 云的对比
请参阅比较部分以获取详细说明。.
专用GPU服务器与购买硬件的对比
专用 GPU 托管服务也可以作为购买 AI 服务器的替代方案。.
购买硬件不仅使组织获得实物所有权,同时也带来了以下方面的责任:
- 资本支出
- 功率
- 冷却
- 机架空间
- 人际网络
- 硬件维护
- 备件
- 未来的升级
租用专用GPU基础设施将数据中心的运营工作很大程度上交由托管服务商负责。.
正确的选择取决于预期使用率、项目周期、资本预算、技术人员以及长期基础设施需求。.
最适合LLM训练的专用GPU服务器
大型语言模型的训练可能需要多块高内存GPU持续运行很长时间。.
重要因素包括:
- GPU 计算性能
- VRAM
- 内存带宽
- 多GPU互连
- 系统内存
- NVMe 吞吐量
- 网络性能
H100级及其他高端AI加速器是处理大规模训练工作负载的天然选择,但完整的服务器架构与GPU型号同样重要。.
我们的
最适合大型语言模型(LLM)训练的GPU服务器
该指南对此工作量进行了更详细的说明。.
最适合 AI 推理的专用 GPU 服务器
推理基础设施应围绕实际生产需求进行优化,而非训练基准。.
重要指标包括:
- 延迟
- 吞吐量
- GPU内存
- 批次大小
- 上下文长度
- 利用率
- 每次请求的成本
根据具体型号的不同,H100、L40S、A100、MI300X或更经济的加速器可能在经济性方面更具优势。.
生成式人工智能的最佳专用GPU服务器
生成式人工智能涵盖了广泛的工作负载,从大型语言模型到图像和视频生成。.
因此,应选择哪款GPU取决于具体应用。.
大型大型语言模型(LLM)工作负载可能更侧重于GPU内存和多GPU扩展,而图像生成任务则可能在价格较低的GPU硬件上也能获得出色的性能。.
避免为工作负载无法利用的高级加速器容量付费。.
一台独立显卡服务器的价格是多少?
专用 GPU 服务器的价格差异很大,因为 GPU 只是系统中的一个组件。.
费用取决于:
- GPU 型号
- GPU 数量
- CPU配置
- 系统内存
- NVMe 存储
- 网络速度
- 带宽配额
- 数据中心区域
- 合同期限
- 托管服务
一台配备相同GPU的服务器,其总价格可能会因其他硬件和网络配置的不同而大相径庭。.
因此,应比较总工作负载成本,而不仅仅是GPU租赁价格。.
按月租用的专用GPU与按小时租用的GPU对比
| 使用模式 | 待评估的模型 |
|---|---|
| 偶尔进行的实验 | 每小时 GPU |
| 简短的AI项目 | GPU云 |
| 培训需求的变化 | GPU云 |
| 持续的 AI 工作负载 | 专用GPU服务器 |
| 稳定生产推断 | 专用云与预留云的对比 |
并不存在一个通用的利用率阈值,达到该阈值后专用主机就会自动变得更便宜。服务商的资费、GPU代数、利用率、存储空间、带宽以及工作负载效率都会影响这一计算结果。.
租用专用GPU服务器前应检查哪些事项
在选择服务提供商之前,请核实完整的基础设施规格。.
- 请确认确切的显卡型号。.
- 检查 GPU 资源是否确实是专用资源。.
- 验证显存容量。.
- 检查 CPU 型号和核心分配情况。.
- 比较系统内存。.
- 检查 NVMe 存储的性能和容量。.
- 验证网络端口速度和传输限制。.
- 检查数据中心的位置。.
- 确认是否兼容 CUDA 或 ROCm。.
- 请仔细阅读合同及取消条款。.
- 查看技术支持。.
- 评估升级和扩展方案。.
专用GPU服务器常见的错误
仅根据GPU名称进行选择
如果两台 H100 服务器的 CPU、内存、存储、网络或多 GPU 架构存在差异,它们的整体性能表现可能会有所不同。.
购买的GPU数量超过了工作负载的需求
当利用率较低时,性能最强的加速器反而可能成为最不经济的选项。.
忽略显存
对于许多人工智能工作负载而言,GPU内存决定了模型能否高效运行。.
忽略网络性能
分布式训练和数据密集型人工智能可能需要相当大的网络吞吐量。.
仅比较月费
性能、利用率、带宽、存储、技术支持以及工作负载完成时间都会影响实际成本。.
哪些人应该选择专用GPU服务器?
当您遇到以下情况时,值得考虑采用专用 GPU 基础设施:
- 连续的 AI 工作负载
- 可预测的GPU利用率
- 长时间运行的大语言模型推理
- 常规机器学习训练
- 持久化数据集
- 定制软件需求
- 对基础设施控制的要求更高
如果对 GPU 的需求只是偶尔出现或难以预测,那么灵活的云 GPU 服务可能会提供更高的资源利用率。.
结语
最好的专用GPU服务器,并不只是配备了最强大图形加速器的服务器。.
NVIDIA H100 专为高要求的人工智能和大型语言模型(LLM)工作负载而设计,A100 仍适用于成熟的机器学习环境,L40S 则将人工智能推理与图形处理完美结合,而 AMD Instinct 为大型模型计算提供了另一条途径。.
服务提供商的模式也各不相同。GPU Mart 和 Database Mart 侧重于服务器导向的 GPU 基础设施,而 RunPod 和 Vast.ai 则提供了更灵活的 GPU 计算访问方式。DigitalOcean 将 GPU 资源与更广泛的云生态系统以及专用 GPU 选项相结合。.
首先,明确工作负载、所需的VRAM、软件生态系统、利用率以及部署时长。然后,对整台服务器(包括GPU、CPU、内存、NVMe存储、网络、技术支持及总成本)进行综合比较。.
更好的决策路径是:
工作负载 → GPU → VRAM → 利用率 → 服务商 → 服务器 → 总成本。.