RunPod 这是一个专为人工智能、机器学习、大型语言模型、生成式人工智能、推理、微调及其他GPU密集型工作负载打造的GPU云平台。.
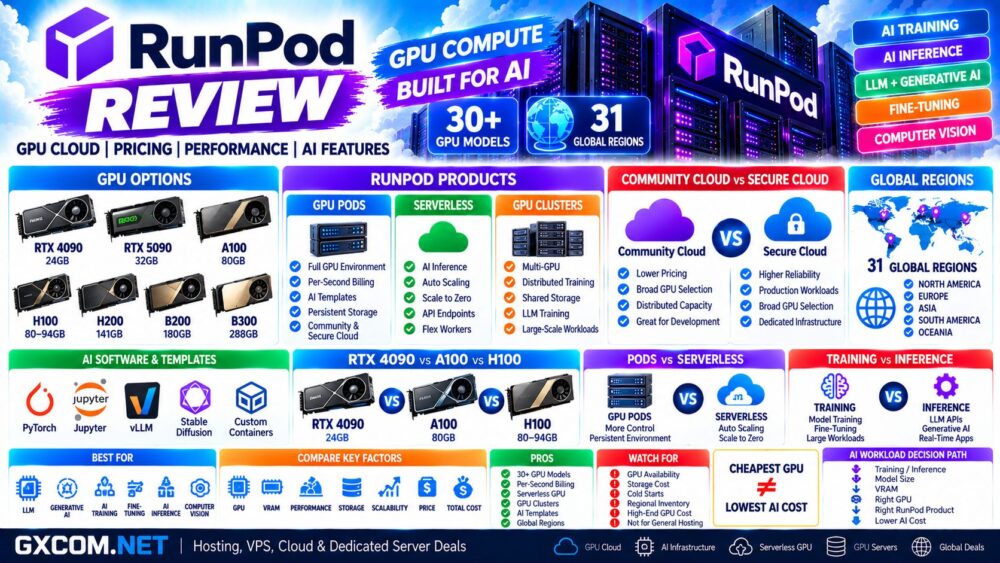
与其要求开发者购买昂贵的GPU硬件,, RunPod 提供按需访问 NVIDIA 加速器的大型产品目录,涵盖从经济实惠的 RTX GPU 到 A100、H100、H200、B200 和 B300 系统等各类产品。.
其基础设施分为三大产品:用于灵活部署 GPU 实例的 GPU Pods、用于自动扩展 AI 推理的无服务器服务,以及用于分布式多 GPU 工作负载的集群。.
这使得 RunPod 这既适用于个人 AI 开发者,也适用于运行生产环境推理或大规模训练任务的团队。.
在这篇 RunPod 评测, ,我们将探讨 GPU 定价、社区云与安全云的对比、H100 和 A100 选项、无服务器 GPU 基础设施、性能考量、存储、全球可用性、AI 功能,以及在租用 GPU 计算资源前需要考虑的主要优缺点。.
RunPod 评测:快速概览
| 功能 | RunPod |
|---|---|
| 主要重点 | GPU 云和人工智能基础设施 |
| GPU 型号 | 30多种型号 |
| 全球地区 | 31 |
| GPU 集群 | 是的 |
| 无服务器 GPU | 是的 |
| GPU 集群 | 是的 |
| 社区云 | 是的 |
| 安全云 | 是的 |
| 按秒计费 | 是的 |
| NVIDIA RTX | 是的 |
| NVIDIA A100 | 是的 |
| NVIDIA H100 | 是的 |
| NVIDIA H200 | 是的 |
| NVIDIA B200 / B300 | 是的 |
| 模板 | 是的 |
| 持久化存储 | 网络卷 |
| 最适合 | 人工智能、大型语言模型、推理、训练、微调和开发 |
什么是RunPod?
RunPod 是一家专业的 GPU 云服务提供商,而非传统的网络托管服务商。.
其基础设施围绕 GPU 计算和人工智能开发进行设计,使用户无需购买或维护物理 GPU 服务器,即可部署配备加速器的环境。.
该平台目前围绕三种主要的计算模型展开:
- GPU 集群
- 无服务器 GPU
- GPU 集群
它们各自适用于不同的工作负载。.
Pod 提供了具有更高控制权的持久性 GPU 实例。无服务器架构主要面向需要自动扩展的推理工作负载。集群则为大型分布式任务提供了多 GPU 基础设施。.
RunPod GPU 计算集群
GPU Pod 是 RunPod 的通用 GPU 实例。.
当您希望直接访问 GPU 环境以处理以下类型的工作负载时,它们非常适合:
- LLM开发
- 模型训练
- 微调
- Stable Diffusion
- 计算机视觉
- 人工智能研究
- Jupyter 开发
- 批处理
- AI推理
RunPod 目前在其云基础设施中提供了 30 多种 GPU 型号,与仅围绕一两种加速器系列构建的平台相比,为开发者提供了更多选择。.
RunPod GPU 定价
GPU 的定价会根据 GPU 型号、云服务等级、区域、可用性以及部署类型而有所不同。.
RunPod 按秒计费 GPU 计算服务,因此用户可以运行短时任务,而无需为整整一小时的闲置算力付费。.
截至本文撰写之时,Secure Cloud Pod 当前的定价示例如下:
| GPU | VRAM | 安全云价格* |
|---|---|---|
| RTX A5000 | 24GB | $0.27/小时 |
| RTX 4090 | 24GB | $0.74/小时 |
| RTX 5090 | 32GB | $0.99/小时 |
| A40 | 48GB | $0.49/小时 |
| RTX A6000 | 48GB | $0.53/小时 |
| L40S | 48GB | $1.09/小时 |
| A100 PCIe | 80GB | $1.59/小时 |
| A100 SXM | 80GB | $1.59/小时 |
| H100 PCIe | 80GB | $2.89/小时 |
| H100 SXM | 80GB | $3.49/小时 |
| H100 NVL | 94GB | $3.19/小时 |
| H200 | 141GB | $4.59/小时 |
| B200 | 180GB | $6.79/小时 |
| B300 | 288GB | $7.89/小时 |
*公布的价格可能会发生变动,且供应情况各不相同。在部署生产环境基础设施之前,请务必查看RunPod的最新价格。.
社区云与安全云
RunPod 的一大显著区别在于“社区云”与“安全云”之间的差异。.
| 因子 | 社区云 | 安全云 |
|---|---|---|
| 定价 | 通常较低 | 通常较高 |
| GPU 选择 | 广泛 | 广泛 |
| 基础设施模型 | 分布式社区能力 | RunPod 安全云基础设施 |
| 最适合 | 注重成本的开发与实验 | 要求更高的生产工作负载 |
对于正在尝试开发人工智能模型的开发者而言,Community Cloud 能提供特别有吸引力的价格。.
例如,当前“社区云”的定价使得RTX 4090等GPU的价格远低于“安全云”的费率。.
然而,不应仅凭最便宜的可用 GPU 来自动决定生产应用程序的部署位置。.
还应考虑基础设施要求、可用性、存储、网络、可靠性预期以及工作负载持续时间。.
RunPod RTX 4090
对于希望获得强劲AI性能、但又不想立即转向昂贵的数据中心加速器的开发者而言,RTX 4090仍然是RunPod方案中最值得关注的选项之一。.
它配备了24GB的显存,可用于以下用途:
- LLM推理
- Stable Diffusion
- 图像生成
- LoRA 训练
- 人工智能开发
- 计算机视觉
- 中小型工作负载
根据 RunPod 当前的定价,RTX 4090 在社区云上的价格约为 $0.34/小时,而在安全云上的价格约为 $0.74/小时。.
其代价是内存容量。.
对于大型语言模型、大批量处理或需要大量模型上下文的工作负载而言,24千兆字节的VRAM可能会显得不足。.
RunPod A100
对于那些对GPU内存需求远高于消费级RTX硬件的工作负载而言,NVIDIA A100依然大有可为。.
RunPod 目前提供配备最高 80GB GPU 内存的 A100 配置。.
典型的工作负载包括:
- 大型语言模型
- 模型训练
- 微调
- 高并发推理
- 机器学习
- 科学计算
目前,A100 PCIe 80GB 和 A100 SXM 80GB 的 Secure Cloud 定价均为约 $1.59/小时。.
如果能找到合适的库存,Community Cloud 的价格可能会更便宜。.
RunPod H100
NVIDIA H100 专为处理要求更高的人工智能工作负载而设计。.
RunPod 目前提供多种 H100 型号,包括:
- H100 PCIe 80GB
- H100 SXM 80GB
- H100 NVL 94GB
H100 特别适用于:
- LLM 训练
- 生成式人工智能
- 高通量推理
- Transformer 工作负载
- 人工智能研究
- 大规模机器学习
然而,不应仅仅因为H100是更快的硬件就自动选择它。.
如果开发工作负载能够轻松容纳在 24GB 的显存中,那么在 RTX 4090 或其他更经济的 GPU 上,其成本效益可能会高得多。.
如需更全面的比较,请参阅我们的
NVIDIA H100 服务器托管
指南。.
RunPod H200、B200 和 B300
RunPod 的 GPU 产品目录已扩展至 H100 级基础设施之外。.
当前的大内存选项包括:
- H200 — 141GB 显存
- B200 — 180GB 显存
- B300 — 288GB 显存
当大型模型、大型上下文窗口、训练工作负载或高吞吐量推理超出了较小GPU的实际内存容量时,这些加速器就派上用场了。.
但GPU内存仍应与模型相匹配,而不是在没有工作负载需求的情况下将其最大化。.
更大的VRAM ≠ 必然更划算。.
什么是 RunPod 无服务器?
RunPod Serverless 提供了一种与让 GPU Pod 持续在线不同的模式。.
开发人员无需维护专用的 GPU 实例,而可以在 API 端点后部署容器化的推理工作负载。.
工人人数根据需求进行调整。.
这使得无服务器架构对于流量波动较大的应用程序特别具有吸引力。.
典型用例包括:
- LLM API
- 聊天机器人
- 图像生成 API
- 语音识别
- 文本转语音
- 计算机视觉 API
- 生成式人工智能应用
RunPod 无服务器定价
无服务器定价与 Pod 定价不同,因为其基础设施包含自动的工作进程管理和扩展功能。.
目前公布的无服务器定价包括:
| GPU 课程 | 示例 GPU | 当前汇率* |
|---|---|---|
| 16GB | A4000 / 类似机型 | 从 $0.58/小时 |
| 24GB | L4 / A5000 / 3090 | $0.69/小时 |
| 24GB PRO | RTX 4090 | $1.10/小时 |
| 32GB | RTX 5090 | $1.58/小时 |
| 48GB | A6000 / A40 | $1.22/小时 |
| 48GB PRO | L40 / L40S / 6000 Ada | $1.75/小时 |
| 80GB | A100 | $2.72/小时 |
| H200 | 141GB | $5.93/小时 |
| B200 | 180GB | $8.64/小时 |
| B300 | 280GB级 | $9.98/小时 |
*价格为评审时平台公布的费率,可能会有变动。.
灵活工作者与在职工作者
RunPod Serverless 可以根据不同的 worker 行为进行配置。.
弹性员工对于工作量波动的情况非常有用,因为当需求消失时,他们可以相应地缩减规模。.
活动工作者始终可用,以减少对延迟敏感的生产应用程序的启动延迟。.
该决策可简化为:
流量波动 → 弹性员工
持续低延迟流量 → 活跃工作者
让工人保持待命状态通常会增加闲置基础设施的成本,而将待命状态降至零则可能会导致启动延迟。.
无服务器冷启动与 FlashBoot
冷启动延迟是无服务器 GPU 基础设施面临的重要问题之一。.
如果请求到达时没有正在运行的 worker,则在开始推理之前,可能需要先初始化基础设施。.
RunPod 开发了 FlashBoot 以缩短启动延迟,目前宣称在支持的条件下启动时间可低于 200 毫秒。.
实际的端到端应用延迟仍可能取决于模型大小、容器初始化、模型加载、存储、网络状况以及工作节点的可用性。.
RunPod Pods 与 无服务器架构
| 因子 | GPU 集群 | 无服务器 |
|---|---|---|
| 基础设施 | GPU实例 | 工作节点的自动扩展 |
| 控制 | 更高 | 侧重于应用程序/API |
| 闲置成本 | 取决于实例 | 可缩放至零 |
| 最适合 | 开发与培训 | 生产推断 |
| 缩放 | 基于手动操作/基础设施 | 自动 |
| 定价 | 通常 GPU 速率较低 | 费率较高,但根据工作量进行调整 |
这两种选择都没有哪一种会自动更便宜。.
一个持续繁忙的推理服务,其经济模式可能与仅偶尔接收请求的 API 不同。.
RunPod GPU 集群
RunPod 集群专为需要多张 GPU 或多个节点的工作负载而设计。.
当前的集群基础设施可扩展至数十个GPU,并支持用于分布式工作负载的共享存储。.
潜在的应用场景包括:
- 分布式大型语言模型(LLM)训练
- 大规模微调
- 多GPU推理
- 人工智能研究
- HPC
当前公开的集群定价包含 H200 SXM 和 A100 SXM 两种配置选项,如需其他高端配置,请联系销售部门。.
RunPod 模板
RunPod 的一项实用开发者功能是其模板生态系统。.
开发人员无需手动配置每个环境,而是可以利用针对常见 AI 工作负载预先配置好的软件堆栈来开始工作。.
例如,以下环境:
- PyTorch
- Jupyter
- Stable Diffusion
- vLLM
- AI推理
- 机器学习开发
当需要自定义环境时,用户也可以自带容器。.
RunPod 存储
GPU成本仅是AI基础设施定价的一部分。.
模型、数据集、检查点、输出结果和容器数据也需要存储空间。.
RunPod 提供持久性网络卷,这些卷可以独立于各个 GPU 会话而保持可用。.
在切换 GPU 时,这尤其有用,因为并非每次创建新实例都必须重新下载大型模型文件。.
在比较GPU供应商时,请计算:
GPU + 存储 + 数据传输 + 运行时 = 实际 AI 成本。.
RunPod 性能
仅凭GPU型号并不能决定AI应用的性能。.
实际结果取决于:
- GPU架构
- VRAM
- 内存带宽
- GPU数量
- 互连
- CPU
- 系统内存
- 存储性能
- 框架
- 量化
- 批次大小
- 模型架构
例如,RTX 4090 对于较小的模型而言性价比极高,但其 24GB 显存以及缺乏 NVLink 的特性,会给需要大内存或紧密耦合的多 GPU 配置的工作负载带来限制。.
随着内存需求和分布式训练复杂度的增加,A100、H100 以及更新一代的数据中心加速器变得越来越重要。.
我们是否对RunPod进行了独立的基准测试?
本评测基于 RunPod 目前公布的 GPU 规格、定价、基础设施文档及平台功能对该产品进行了评估。.
除非 GXCOM.NET 明确公布了基准测试方法和测试结果,否则不应将供应商的规格说明和公开的性能声明视为 GXCOM.NET 的独立基准测试结果。.
AI的性能因模型和配置的不同而存在显著差异。.
对于生产环境部署,请使用以下指标对实际模型进行基准测试:
- 每秒代币数
- 获得第一个代币所需的时间
- 每秒请求数
- GPU利用率
- VRAM 使用情况
- 培训吞吐量
- 每次请求的成本
- 每百万代币的成本
用于大型语言模型(LLM)训练的 RunPod
RunPod 支持多种适用于大型语言模型(LLM)训练和微调的 GPU。.
较小的微调任务在 RTX 或 A 系列 GPU 上运行可能更具成本效益,而较大的训练工作负载则可能需要 A100、H100、H200、B200、B300 或多 GPU 集群。.
正确的选择路径是:
模型规模 → 精度 → 显存 → GPU 数量 → 互连 → 训练时间 → 总成本。.
请参阅我们的
最适合大型语言模型(LLM)训练的GPU服务器
用于更全面的基础设施比较的指南。.
适用于 AI 推理的 RunPod
推理与模型训练的优先级不同。.
训练通常优先考虑原始计算能力、内存容量、内存带宽以及多GPU通信。.
推理通常会优先考虑:
- 延迟
- 吞吐量
- VRAM
- 并发
- 自动缩放
- 每次请求的成本
正因如此,RunPod Serverless 才显得尤为重要,因为工作进程可以根据应用程序的流量进行扩展。.
适用于生成式人工智能的 RunPod
RunPod 能够支持广泛的生成式人工智能应用。.
例如:
- 大型语言模型
- 图像生成
- 文本转图像
- 语音识别
- 文本转语音
- 视频人工智能
- AI代理
- 计算机视觉
丰富的GPU产品线意味着开发者能够更精准地根据工作负载选择硬件,而无需为每个AI应用都支付H100级别的价格。.
RunPod 与专用 GPU 服务器对比
| 因子 | RunPod GPU 云 | 专用GPU服务器 |
|---|---|---|
| 前期硬件成本 | 无 | 每月承诺或购买 |
| 部署 | 快 | 通常较慢 |
| GPU 切换 | 简单 | 取决于硬件 |
| 缩放 | 灵活的 | 受物理服务器限制 |
| 短工作负载 | 紧身 | 通常不太经济 |
| 高连续利用率 | 按使用量计费 | 可以实现成本效益 |
| 硬件控制 | 较低 | 更高 |
当利用率频繁变化时,GPU云服务尤其具有吸引力。.
当同一套硬件以高利用率持续运行时,专用 GPU 基础设施会变得更有吸引力。.
请参阅我们的
NVIDIA GPU 服务器与 GPU 云的对比
比较。.
RunPod 的优缺点
| 优点 | 缺点 |
|---|---|
| 30多种GPU型号 | GPU的供应情况可能会有所不同 |
| 通过 B300 实现 RTX 的方案 | GPU 和云服务等级的定价有所不同 |
| 社区与安全云 | 存储会增加总成本 |
| 按秒计费 | 高端显卡的价格依然居高不下 |
| 无服务器 GPU 平台 | 无服务器冷启动需要加以考虑 |
| 多GPU集群 | 人工智能基础设施仍然需要技术知识 |
| 持久性网络存储 | 社区的能力可能较难预测 |
| AI模板 | 并非作为传统网站托管服务而设计 |
| 31个全球地区 | 各地区的具体GPU库存情况因地区而异 |
哪些人应该考虑使用RunPod?
RunPod 特别适合以下人群:
- 人工智能开发者
- 机器学习工程师
- LLM开发者
- 人工智能初创企业
- 研究人员
- 生成式人工智能应用
- 工作负载的微调
- AI 推理 API
- 图像生成
- 计算机视觉
- GPU开发
当你希望使用多代GPU,却又无需购买硬件时,这一点尤其具有吸引力。.
哪些人可能会更倾向于选择其他方案?
对于传统网站、WordPress、小型数据库或无法从 GPU 加速中获益的应用程序而言,RunPod 可能并非必需。.
对于需要完全控制物理 GPU 硬件的组织而言,专用 GPU 服务器可能是更合适的选择。.
同样,对于连续数月保持极高利用率运行的工作负载,应将 GPU 云服务成本与每月专用的 GPU 基础设施成本进行比较,而不是一味认为按小时计费的云服务价格总是更便宜。.
RunPod 对 AI 开发者来说好用吗?
RunPod 融合了低成本的 RTX GPU、高内存数据中心加速器、模板、持久化存储、无服务器端点以及多 GPU 基础设施,因此特别适合人工智能开发。.
由于人工智能工作负载差异巨大,因此丰富的 GPU 产品线非常有用。.
开发人员在测试小型模型时,可能只需一块RTX级别的GPU;而生产环境中的大型语言模型(LLM)工作负载则可能需要80GB、141GB、180GB或更大的GPU内存。.
因此,无需购买新硬件即可更改基础设施的能力,是该平台的主要优势之一。.
RunPod 便宜吗?
对于某些 GPU 工作负载而言,RunPod 的成本可能较低,特别是当 Community Cloud 的计算资源或低成本的 RTX 硬件能够满足项目需求时。.
但“便宜的GPU”不应仅以每小时价格来衡量。.
一款速度较慢的 GPU,如果完成同一项工作负载需要两倍的时间,其成本可能比每小时费率更高的快速加速器还要高。.
同样地,对于那些能轻松在RTX 4090上运行的工作负载而言,配置过高的H100可能性价比不高。.
有用的指标是:
已完成工程量 ÷ 基础设施总成本。.
如需了解多家供应商的最新优惠,请参阅我们的
超值GPU租赁优惠
比较。.
RunPod 评测:最终总结
RunPod 是面向开发人工智能和机器学习应用程序的开发者的、较为专业的 GPU 云平台之一。.
其主要优势在于GPU的选择和部署灵活性。随着工作负载需求的增加,用户可以从经济实惠的RTX级硬件逐步升级至A100和H100加速器、大内存H200和Blackwell GPU、无服务器推理,或是多GPU集群。.
按秒计费的模式也使得该平台特别适合用于实验和可变工作负载,因为开发人员不必一直维持成本高昂的 GPU 基础设施。.
主要挑战在于选择合适的 GPU 和部署模式。Community Cloud、Secure Cloud、Pods、Serverless 和 Clusters 分别满足不同的需求,而每小时价格最低的方案并不一定能带来每项完成的工作负载的最低成本。.
部署前,请按照以下决策流程操作:
AI 工作负载 → 训练/推理 → 模型大小 → 显存 → GPU → Pod/无服务器/集群 → 存储 → 运行时 → 总成本。.