

GPU PCIe 与 SXM 服务器对比:NVLink、内存带宽及 AI 集群成本
当模型跨多个设备运行时,两台 GPU 服务器即使宣称属于同一加速器系列,其运行结果也可能大相径庭。这种差异可能涉及 GPU 的外形尺寸、互连拓扑、功耗限制以及……
FP8 与 FP4 推理:GPU 内存节省、模型精度及服务成本
当 GPU 内存限制了批量大小、模型部署位置和并发请求数量时,运行大型语言模型的成本会很高。采用低精度推理可以缓解这些限制,但选择更小的数值格式又会带来新的问题……
GPU MIG 与时间切片:VRAM 隔离、多租户 AI 与性能
让多个AI应用程序共享一块昂贵的GPU,听起来似乎是降低基础设施成本的显而易见的方法。然而,让多个工作负载访问同一块加速器可能会导致不可预测的延迟、内存耗尽以及“噪音邻居”问题……
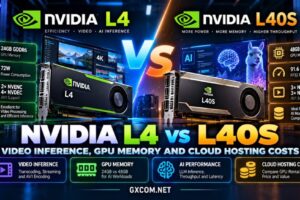
NVIDIA L4 与 L40S 对比:视频推理、GPU 内存及云托管成本
在 NVIDIA L4 和 L40S 之间做出选择,不仅仅是为了获得更强的 GPU 性能。选择合适的加速器取决于模型规模、视频处理要求、推理并发度以及完成任务的实际成本……
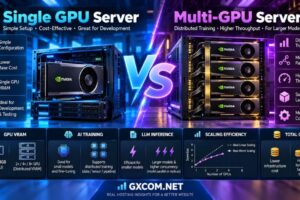
单GPU与多GPU服务器:AI训练、推理扩展及基础设施成本
增加更多GPU似乎是加速人工智能工作负载的显而易见的方法。如果一个GPU能够训练或部署一个模型,那么四个GPU的速度应该快四倍——至少人们是这么认为的。现实中的AI……
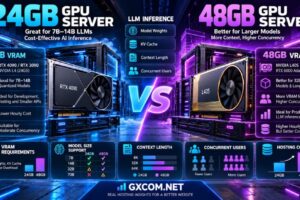
24GB 与 48GB GPU 服务器:VRAM 需求、LLM 推理及托管成本
选择24GB还是48GB的GPU服务器,将决定您的大型语言模型是能流畅运行、受限于内存而运行不畅,还是导致托管成本不必要地高昂。不过,这一决策远比单纯比较……要复杂得多。
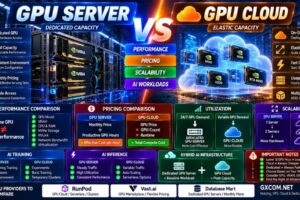
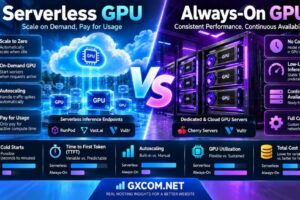
GPU服务器与GPU云:性能、定价及哪种更适合AI?
AI 基础设施可以通过两种截然不同的方式进行部署:租用专用 GPU 服务器以实现对硬件的持续访问,或者使用 GPU 云基础设施,该基础设施可在工作负载需要时进行配置。这两种方式……
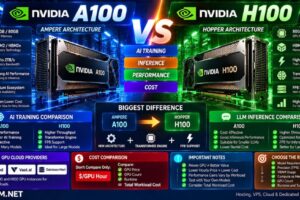
NVIDIA A100 与 H100 对比:AI 训练、推理、性能与成本对比
NVIDIA A100 和 H100 是目前在人工智能、机器学习、大型语言模型以及高性能计算领域最广为人知的数据中心 GPU 中的两款。但它们属于不同的代。A100 基于……
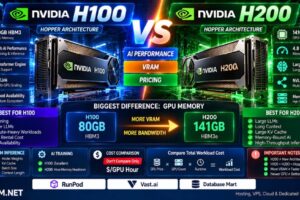
NVIDIA H100 与 H200 对比:AI 性能、VRAM、价格以及该选择哪款 GPU?
NVIDIA H100 和 H200 是面向生成式人工智能、大型语言模型、机器学习以及高性能计算领域的两款最重要的数据中心 GPU。它们之间也密切相关。这两款产品均基于 NVIDIA 的 Hopper…
NVIDIA GPU 与 AMD GPU 服务器:哪种 GPU 托管方案更胜一筹?
对于开发 GPU 加速应用程序的企业、开发人员和 AI 团队而言,在 NVIDIA GPU 服务器和 AMD GPU 服务器之间做出选择是一项重要决策。NVIDIA 和 AMD 均提供专为高性能计算、人工智能……设计的强大图形处理器。
GPU服务器与云GPU:您应该选择哪种AI基础设施?
对于构建现代计算工作负载的企业、开发人员和人工智能团队而言,在 GPU 服务器与云 GPU 之间做出选择是一项重要决策。这两种解决方案都能提供强大的 GPU 加速能力,但在……方面存在显著差异。
GPU 服务器与 CPU 服务器:哪种服务器更适合您的工作负载?
在GPU服务器和CPU服务器之间做出选择,取决于您需要运行的工作负载类型。虽然CPU服务器仍是传统计算的基础,但GPU服务器在人工智能领域的重要性日益凸显……