NVIDIA H100 和 H200 是面向生成式人工智能、大型语言模型、机器学习以及高性能计算领域的两款最重要的数据中心 GPU。.
它们之间也密切相关。.
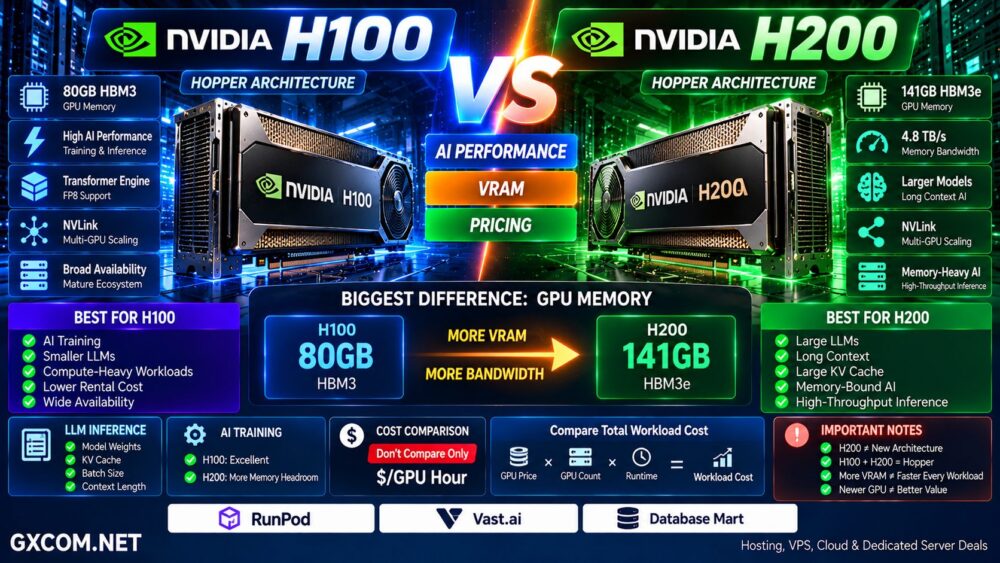
两者均基于英伟达的Hopper架构,但H200通过引入HBM3e,显著提升了GPU内存容量和内存带宽。.
这使得真正的 NVIDIA H100 与 H200 对比 这一决定比单纯询问哪款显卡更新要复杂得多。.
对于某些 AI 工作负载,H200 更大的内存可以显著提高模型部署和推理效率。对于其他工作负载,H100 仍能以更具吸引力的租赁价格提供出色的性能。.
本对比分析了AI性能、VRAM、内存带宽、大型语言模型(LLM)推理、训练、功耗、多GPU扩展性、GPU云服务定价,以及针对不同工作负载应选择哪款GPU。.
NVIDIA H100 与 H200:快速对比
| 功能 | NVIDIA H100 | NVIDIA H200 |
|---|---|---|
| 建筑 | 霍珀 | 霍珀 |
| GPU 内存 | 常见 H100 SXM 配置中最高支持 80GB HBM3 | 141GB HBM3e |
| 内存带宽 | 低于H200 | 4.8TB/s |
| NVLink | 已支持 | 已支持 |
| 人工智能培训 | 非常棒 | 非常棒 |
| LLM 推理 | 非常棒 | 在内存密集型工作负载方面表现更强 |
| 大型模型 | 可能需要更多的GPU | 每块GPU的内存更大 |
| 云可用性 | 非常广泛 | 生长 / 宽广 |
| 租金 | 通常较低 | 通常较高 |
| 最超值 | 取决于工作量 | 取决于工作量 |
什么是 NVIDIA H100?
NVIDIA H100 Tensor Core GPU 基于 NVIDIA 的 Hopper 架构,专为数据中心人工智能、高性能计算(HPC)、推理以及大规模加速计算而设计。.
H100 引入了适用于现代 AI 工作负载的重要技术,包括:
- 第四代张量核心
- Transformer Engine
- FP8 支持
- 高带宽内存
- NVLink
- 多实例GPU(MIG)
- 机密计算功能
H100 迅速成为用于训练和部署大型语言模型的主要 GPU。.
它仍可通过 GPU 云平台、专用 GPU 服务器和企业级 AI 基础设施广泛获取。.
什么是 NVIDIA H200?
NVIDIA H200 同样基于 Hopper 架构。.
其最重要的改进在于内存子系统。.
H200 提供:
- 141GB HBM3e GPU内存
- 4.8TB/s 内存带宽
- Hopper 张量核心架构
- NVLink 连接
- 多实例 GPU 支持
- 企业级人工智能和高性能计算能力
对于大型语言模型而言,额外的内存容量尤为重要,因为模型权重、KV缓存、激活值以及推理工作负载可能会消耗海量的显存。.
H100 → 数据缓冲区 + 高性能 AI 计算
H200 → 进料斗 + 容量更大、速度更快的内存
H100 与 H200:最大的区别在于内存
人们很容易将H200视为一个全新的GPU世代。.
这并不是理解它的最佳方式。.
这两款GPU均采用Hopper架构。.
H200的主要升级内容是:
更大的VRAM + 更高的内存带宽。.
NVIDIA H200 配备 141GB 的 HBM3e 内存,带宽达 4.8TB/s。.
与目前广泛部署的 80GB H100 SXM 配置相比,这极大地增加了可直接保存在 GPU 内存中的 AI 模型数据量。.
对于受内存限制的工作负载而言,这一点可能至关重要。.
为什么VRAM对人工智能很重要
在部署大型人工智能模型时,GPU内存是最重要的规格之一。.
VRAM 可能需要存储:
- 模型权重
- KV缓存
- 激活
- 训练状态
- 批次数据
- 临时张量
当模型无法在单个 GPU 上高效训练时,可能需要将其分配到多个 GPU 上。.
这带来了额外的沟通要求。.
模型 → GPU 1 + GPU 2 + GPU 3 + GPU 4
如果内存更大的 GPU 能让相同的工作负载使用更少的 GPU,那么该架构可能会变得更简单,并且可能更高效。.
H100 与 H200 在大语言模型推理中的对比
LLM推理是H200最强大的应用场景之一。.
大型语言模型的部署可能会在很大程度上依赖于内存容量和带宽。.
H200 配备的 141GB HBM3e 内存,使得更大的模型、更大的批处理规模以及更大的 KV 缓存能够保留在 GPU 内存中。.
与 H100 相比,NVIDIA 在部分大型语言模型(LLM)工作负载上展示了 H200 在推理性能方面的显著提升,特别是在更大容量的内存系统能够减少通信开销或消除内存瓶颈的情况下。.
然而,性能差异取决于以下因素:
- 型号
- 精度
- 量化
- 批次大小
- 上下文长度
- 推理框架
- GPU 数量
更大的VRAM ≠ 所有机型都能获得相同的性能提升。.
H100 和 H200 的 GPU 云平台对比
对于大多数开发人员和小型人工智能团队而言,购买 H100 或 H200 系统并没有必要。租用 GPU 计算资源可以使基础设施与工作负载的持续时间和规模相匹配。.
诸如以下平台: RunPod 以及 Vast.ai 在比较按需 GPU 基础设施时,这些因素尤为重要,而 数据库集市 在评估运行时间较长的 GPU 服务器配置时,以 GPU 为导向的服务器提供商可能会派上用场。.
| 服务提供商 | 最佳对比点 |
|---|---|
| RunPod | 按需 GPU 云、部署和 AI 工作负载 |
| Vast.ai | Marketplace 上的 GPU 价格及可用配置 |
| 数据库集市 | GPU 服务器配置和运行时间较长的工作负载 |
GPU 的库存和价格可能迅速变化,因此在部署前,请务必比较具体的 GPU 型号、显存、CPU、系统内存、存储、网络配置、计费模式以及可用性。.
不要仅凭GPU名称来比较不同厂商的产品。.
H100 + 低速存储 + 网络性能差 ≠ 优化的人工智能基础设施。.
H100 与 H200 在 AI 训练中的对比
这两款GPU都是功能强大的训练加速器。.
H200 更大的内存容量在训练或微调需要大量显存的模型时,能够带来优势。.
更大的GPU内存可以实现:
- 更大尺寸的型号
- 更大的批量
- 内存冲突更少
- 简化模型划分
- 更灵活的微调
但训练效果并不完全取决于VRAM。.
对于分布式训练而言,网络通信和GPU间通信同样至关重要。.
因此,应将多GPU集群作为一个完整的系统进行评估。.
H100 与 H200 在微调方面的对比
微调的要求差异极大。.
与全模型训练相比,LoRA 和 QLoRA 等技术可以显著降低内存需求。.
这意味着对于许多微调项目而言,H100 可能已经提供了绰绰有余的内存。.
在以下情况下,H200更具吸引力:
- 这个模型非常大
- 批处理规模需要扩大
- 上下文窗口很大
- 内存已经成为瓶颈
- 主要由于VRAM的原因,需要多块H100 GPU
H100 与 H200 的内存带宽对比
容量只是内存故事的一半。.
带宽决定了GPU在内存与其计算资源之间传输数据的速度。.
H200 的内存带宽达到 4.8TB/s。.
对于受内存带宽限制的工作负载而言,这一点尤为重要。.
一个简化的性能模型如下:
计算密集型工作负载 → GPU 计算的重要性日益凸显
内存密集型工作负载 → VRAM 带宽更为关键
在为 H200 支付更多费用之前,了解您的工作负载存在哪些瓶颈至关重要。.
大型语言模型中的 H100 与 H200 对比
大型语言模型是考虑采用 H200 的最明显理由之一。.
随着模型规模和上下文长度的增加,对GPU内存的需求也会迅速上升。.
每块GPU配备更多的内存,可以减少仅为容纳一个模型而所需的加速器数量。.
这并不一定意味着H200的总成本总是更低。.
你必须进行比较:
GPU 价格 × GPU 数量 × 运行时间
而不是:
单张GPU的每小时价格。.
RAG中的H100与H200对比
检索增强生成系统将模型推理与检索、嵌入、向量搜索以及应用逻辑相结合。.
GPU的要求在很大程度上取决于哪些组件在加速器上运行。.
对于大规模生产环境中的大型语言模型(LLM)推理,H200的内存容量将大有裨益。.
对于规模较小的 RAG 应用,H100——甚至更便宜的 GPU——可能就足以满足性能需求。.
不要仅仅因为该应用程序使用了生成式人工智能就选择 H200。.
HPC 领域的 H100 与 H200 对比
H100 和 H200 均支持高性能计算工作负载。.
对于受内存容量或内存带宽限制的应用而言,H200 尤其具有吸引力。.
示例包括:
- 科学模拟
- 计算化学
- 基因组学
- 物理学
- 工程
- 数据分析
对于能够轻松容纳在H100内存中的计算密集型工作负载,迁移到H200所带来的效益可能较小。.
H100 与 H200 的功耗对比
应从整个系统层面来考虑电源问题。.
H200 SXM 配置的 TDP 最高可达 700W(具体数值取决于平台),且可进行配置。.
但仅凭瓦数并不能决定效率。.
更有参考价值的指标是:
有效AI功 / 消耗能量。.
如果某块 GPU 能更快地完成工作负载,或者减少了所需的 GPU 数量,那么单块 GPU 功耗的增加并不一定意味着总能耗成本会随之增加。.
H100 与 H200 的多 GPU 扩展性对比
大型人工智能模型通常需要多块GPU。.
在适当的服务器配置下,H100 和 H200 均支持高速 NVIDIA NVLink 连接。.
一台典型的大型人工智能服务器可能使用:
8 个 GPU → NVLink / NVSwitch → 高速 GPU 互连架构
对于分布式工作负载,还应评估:
- NVLink 拓扑结构
- NVSwitch
- InfiniBand 或 以太网
- 网络带宽
- CPU
- 系统内存
- NVMe 存储
如果通过网络连接不佳的方式连接八块昂贵的GPU,可能会造成一个代价高昂的瓶颈。.
H100 与 H200 的价格对比
H100或H200并没有统一的租赁价格。.
GPU 云服务的定价取决于:
- 服务提供商
- 地区
- SXM 与 PCIe 配置对比
- 专用 GPU 与共享 GPU
- CPU
- 系统内存
- 存储
- 网络
- 按需计费与预留计费
- 市场供应
H100的基础设施通常更为成熟且广泛可用,因此当其与H200的价格差距较大时,便具有较高的吸引力。.
当 H200 凭借其更大的显存使工作负载能够使用更少的 GPU 或提供显著更高的吞吐量时,其溢价便有其合理性。.
如何比较真实的GPU云服务成本
请不要仅比较:
$ / GPU 小时
请改算如下:
GPU 每小时成本 × 所需 GPU 数量 × 所需小时数 = 工作负载成本
对于推理而言,一个更合适的度量标准可能是:
总成本 / 发放的代币数量
用于培训:
总成本 / 已完成的培训任务
更昂贵的 GPU 有时能降低工作负载成本,因为它能更快地完成任务,或者所需的加速器数量更少。.
何时H100能提供更高的性价比
在以下情况下,H100 仍具备很强的性能,且可能带来更优的经济效益:
- 您的模型可以轻松容纳在可用显存中
- 您的工作负载主要受计算能力限制
- H100的租赁价格明显更低
- 您需要广泛的供应商覆盖范围
- 您已经部署了经过优化的 H100 基础设施
- 您的软件堆栈已针对 H100 进行了优化
对于许多人工智能工作负载而言,仅仅因为出现了更新款的硬件就进行升级是没有必要的。.
先找出瓶颈。.
何时选择H200更明智
在以下情况下,H200 尤其具有吸引力:
- 80GB的显存限制了您的工作负载
- 您提供的是超大规模语言模型
- 你需要更大的 KV 缓存
- 您使用了较长的上下文窗口
- 您的工作负载受内存带宽的限制
- 运行一个模型所需的GPU数量更少
- 额外的内存有助于提高推理吞吐量
从 H100 升级到 H200 的最大理由通常应该是可量化的工作负载优势,而不是型号本身。.
初创企业该选 H100 还是 H200?
在能够预测利用率之前,大多数人工智能初创企业应避免购买昂贵的GPU基础设施。.
诸如以下平台: RunPod 以及 Vast.ai 允许团队比较 GPU 的可用性,并根据工作负载需求租用计算资源。.
一个合理的进展过程可以是:
实验 → 租用 GPU → 测量利用率 → 优化 → 扩展
只有当工作负载变得持续且可预测时,评估长期专用的GPU基础设施才变得更为重要。.
是否应该从 H100 升级到 H200?
请勿自动升级。.
第一项措施:
- 当前 VRAM 使用率
- 内存带宽利用率
- GPU 计算利用率
- 批次大小
- 模型并行性
- 通信开销
- 每秒代币数
- 每次推理请求的成本
如果您的 H100 工作负载受限于 GPU 内存容量或内存带宽,那么 H200 是一个极具吸引力的升级选择。.
如果工作负载已经是计算密集型且能轻松容纳在 H100 内存中,那么经济效益可能会较小。.
H100 与 H200:优缺点对比
| NVIDIA H100 | NVIDIA H200 | |
|---|---|---|
| 建筑 | 霍珀 | 霍珀 |
| VRAM | 较低 | 141GB HBM3e |
| 内存带宽 | 高 | 4.8TB/s |
| LLM 推理 | 非常棒 | 非常适合内存密集型工作负载 |
| 培训 | 非常棒 | 非常棒 |
| 可用性 | 非常广泛 | 拓宽 |
| 租赁价格 | 通常更实惠 | 通常是高级版 |
| 主要优势 | 成熟的性价比 | 内存容量和带宽 |
如果……,请选择 NVIDIA H100
- 您的工作负载完全可以在 H100 的显存内轻松运行
- 您更看重较低的GPU租赁成本
- 您需要广泛的云服务可用性
- 您运行计算密集型工作负载
- 您已经拥有了经过优化的 H100 部署
- H200 并未实质性地降低工作量成本
如果……,请选择 NVIDIA H200
- 您需要的内存容量必须超过 H100 通常配备的 80GB
- 您为大型语言模型(LLM)提供服务
- 每块GPU需要141GB的HBM3e
- 4.8TB/s 的内存带宽可有效提升您的工作负载性能
- 您使用的是大批量处理或键值缓存
- 您希望减少模型在各GPU之间的划分
- 性能提升抵消了较高的租金
租用 H100 或 H200 之前应考虑的问题
- 该模型需要多少显存?
- 该工作负载是计算密集型还是内存密集型?
- 你会采用什么精度?
- 该模型会进行量化吗?
- 需要多长的上下文长度?
- 您打算运行多大的批次?
- 需要多少个GPU?
- 是否支持 NVLink?
- 哪种网络架构可连接多个GPU节点?
- 系统自带多少内存?
- 包含哪些 NVMe 存储设备?
- 这块显卡是独立显卡吗?
- 带宽是如何计费的?
- 每小时的价格是多少?
- 完成这项工作所需的总成本是多少?
NVIDIA H100 与 H200 对比:该选择哪款 GPU?
NVIDIA H100 和 H200 都是性能强劲的 Hopper 架构数据中心 GPU。.
H200 的显著优势在于其容量更大、速度更快的 HBM3e 内存子系统。.
这使得 H200 在大型语言模型推理、长上下文工作负载、大型键值对缓存、内存密集型人工智能,以及主要因内存限制而通常需要额外 GPU 的工作负载方面,具有特别显著的优势。.
H100 依然是一款性能极其强大的加速器,当工作负载能够轻松容纳在其内存中,且云租用价格较低时,它能提供极高的性价比。.
因此,正确的答案不是:
H200 是更新款 → 请选择 H200。.
应改为:
模型 → VRAM → 内存带宽 → 计算能力 → GPU 数量 → 运行时间 → 租赁价格 → 总工作负载成本。.
就人工智能基础设施而言,速度最快的GPU未必是性价比最高的GPU。.
请先评估您的工作负载对计算资源和内存的使用情况,然后在部署前对比各GPU供应商当前的H100和H200定价。.