

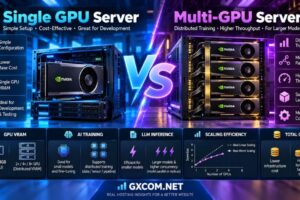
单GPU与多GPU服务器:AI训练、推理扩展及基础设施成本
增加更多GPU似乎是加速人工智能工作负载的显而易见的方法。如果一个GPU能够训练或部署一个模型,那么四个GPU的速度应该快四倍——至少人们是这么认为的。现实中的AI……
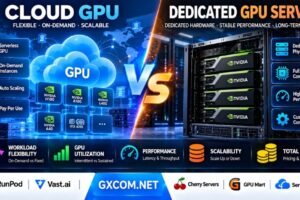
云GPU与专用GPU服务器:AI工作负载的灵活性、利用率及总成本
进行人工智能应用时,是应该从云平台租用GPU,还是选择专用GPU服务器?答案不仅取决于GPU的规格或宣传的每小时价格。人工智能工作负载对资源的需求差异很大……
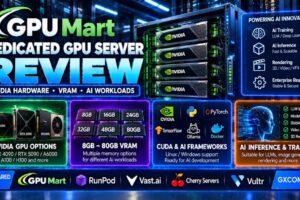
GPU Mart 专用 GPU 服务器评测:NVIDIA 硬件、VRAM 及 AI 工作负载适用性
本篇由 GPU Mart 撰写的专用 GPU 服务器评测,重点探讨了 NVIDIA 硬件选项、GPU 内存容量、CPU 和存储配置、CUDA 兼容性,以及专用 GPU 基础设施在 AI 训练、推理、渲染和生产工作负载中的适用性……
NVIDIA Blackwell GPU 云服务评测:B200、GB200 及 AI 基础设施采购考量
本篇关于 NVIDIA Blackwell GPU 云服务的评测,从 AI 基础设施采购的角度出发,对 B200、GB200 Grace Blackwell 超级芯片以及 GB200 NVL72 进行了分析。对于部署大型语言模型、推理系统、生成式 AI 应用以及分布式……
NVIDIA H200 GPU 租赁方案:大内存 AI 服务器对比
当AI工作负载需要大容量GPU内存、高内存带宽,以及无需在GPU和系统内存之间不断传输数据即可处理高要求模型时,H200 GPU租赁方案值得考虑。不过,租赁……
AMD Instinct 与 NVIDIA GPU 服务器对比:AI 训练成本、软件支持与基础设施价值
对于正在选择人工智能训练服务器、云GPU实例和专用基础设施的企业而言,AMD Instinct 与 NVIDIA GPU 之间的对比正变得越来越重要。AMD Instinct 加速器提供了高内存计算方案和 ROCm 软件生态系统,而……
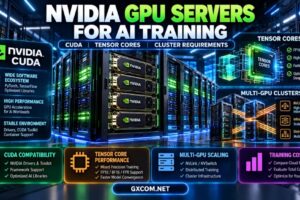
用于人工智能训练的 NVIDIA GPU 服务器:CUDA、张量核和集群要求
用于人工智能训练的 NVIDIA GPU 服务器为许多机器学习实验、大型语言模型微调项目以及分布式深度学习工作负载提供了计算基础设施。然而,选择训练服务器不仅仅只是选择……
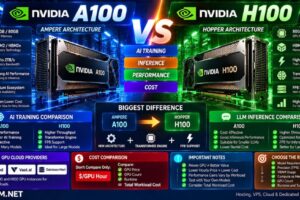
NVIDIA A100 与 H100 对比:AI 训练、推理、性能与成本对比
NVIDIA A100 和 H100 是目前在人工智能、机器学习、大型语言模型以及高性能计算领域最广为人知的数据中心 GPU 中的两款。但它们属于不同的代。A100 基于……
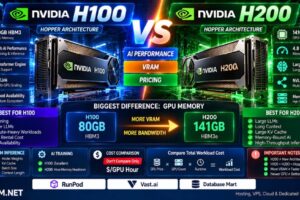
NVIDIA H100 与 H200 对比:AI 性能、VRAM、价格以及该选择哪款 GPU?
NVIDIA H100 和 H200 是面向生成式人工智能、大型语言模型、机器学习以及高性能计算领域的两款最重要的数据中心 GPU。它们之间也密切相关。这两款产品均基于 NVIDIA 的 Hopper…