AI 基础设施可以通过两种截然不同的方式进行部署:租用专用 GPU 服务器以持续访问硬件,或者使用 GPU 云基础设施,该基础设施可在工作负载需要时进行配置。.
这两种方案都能提供性能强劲的 NVIDIA GPU,例如 A100、H100、H200、RTX 4090 以及更新一代的加速器。真正的区别并不仅仅在于 GPU 性能。.
这取决于你如何使用该基础设施。.
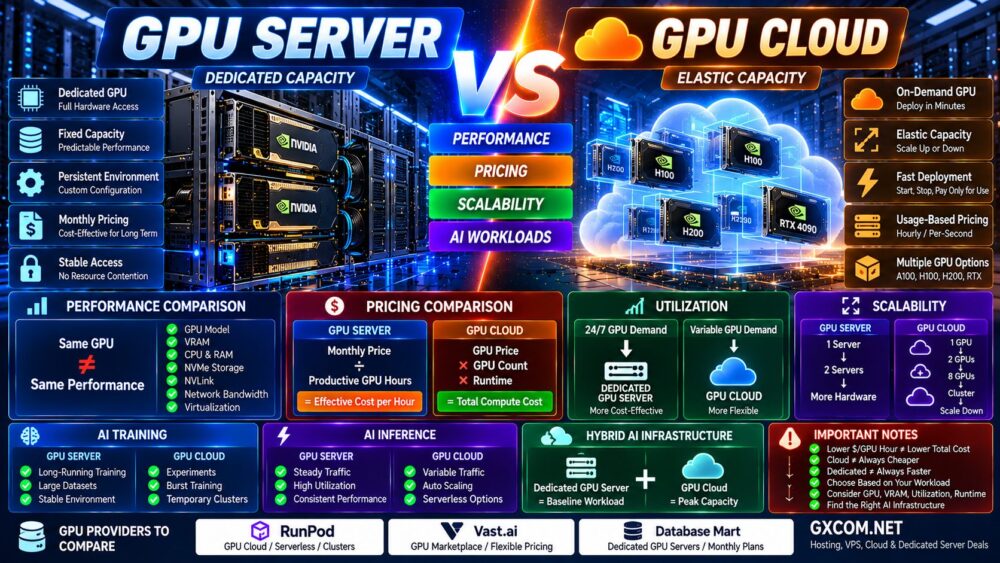
GPU 服务器 → 专用算力 → 长期工作负载
GPU 云 → 按需容量 → 灵活的工作负载
在这篇 GPU服务器与GPU云的对比 为了进行比较,我们将考察性能、定价、利用率、可扩展性、存储、网络、AI 训练、推理、大型语言模型(LLM)工作负载,以及如何计算 GPU 基础设施的实际成本。.
GPU服务器与GPU云:快速对比
| 功能 | 专用GPU服务器 | GPU 云 |
|---|---|---|
| GPU 访问 | 专属 | 取决于实例 |
| 定价 | 通常是每月一次 | 按小时 / 按秒 / 按使用量计费 |
| 部署 | 取决于提供商 | 通常很快 |
| 缩放 | 增加物理容量 | 高度灵活 |
| 长期工作负荷 | 可能具有成本效益 | 可能会很贵 |
| 短期工作 | 潜在闲置产能 | 版型极佳 |
| 硬件控制 | 高 | 取决于平台 |
| 人工智能培训 | 非常棒 | 非常棒 |
| 推论 | 非常适合需求稳定的情况 | 非常适合需求波动的情况 |
| 最适合 | 可预测的GPU利用率 | 动态 GPU 利用率 |
什么是专用GPU服务器?
专用 GPU 服务器是指为客户分配了一块或多块 GPU 的物理服务器。.
典型的配置可能包括:
- NVIDIA 图形处理器
- 专用 CPU 核心
- 大容量系统内存
- NVMe 存储
- 专用网络接口
- Linux 还是 Windows
- CUDA 环境
- root 或管理员权限
客户通常不会根据需要随时启动或停止计算服务,而是会租用整台服务器,租期为预先确定的计费周期。.
这使得在需要持续使用GPU的情况下,专用GPU服务器显得尤为有吸引力。.
什么是 GPU 云?
GPU 云通过云基础设施提供加速器资源,而无需客户维护长期租用的物理 GPU 服务器。.
根据平台的不同,部署模式可能包括:
- GPU 虚拟机
- GPU 容器
- 专用 GPU 实例
- 无服务器 GPU
- 多GPU集群
- 可中断或现货 GPU 实例
其主要优势在于灵活性。.
您可以部署一台 GPU,运行工作负载,终止该实例,从而停止支付计算费用。.
部署 → 运行 → 完成 → 终止
GPU服务器与GPU云的性能对比
专用 GPU 服务器并不一定比 GPU 云更快。.
同样,GPU云服务本身并不比专用服务器慢。.
如果两个环境都配备了相同的GPU,那么性能差异可能源于系统的其他部分。.
比较:
- 确切的 GPU 型号
- GPU 外形规格
- VRAM
- CPU
- 系统内存
- NVMe 存储
- PCIe 配置
- NVLink
- 网络带宽
- 虚拟化
- 软件堆栈
对于多GPU人工智能而言,拓扑结构显得尤为重要。.
相同的 GPU ≠ 相同的 AI 服务器性能。.
最重要的指标:GPU利用率
GPU服务器与GPU云之间最大的经济差异通常在于利用率。.
设想一个正在运行的 GPU 工作负载:
24 小时 × 30 天 = 720 GPU 小时
如果整个月内 GPU 负载都很高,那么固定价格的专用 GPU 服务器就变得颇具吸引力。.
现在考虑一个开发工作负载,该工作负载在同一个月内仅使用 GPU 60 小时。.
如果租用整台专用服务器,可能会导致数百小时昂贵的GPU算力闲置。.
正是在这一点上,GPU云才能发挥出更大的效率。.
GPU的成本不仅仅体现在价格上。.
GPU 成本 = 价格 × 利用率。.
值得比较的GPU供应商
一旦了解了您的使用模式,就应根据工作负载来比较基础设施提供商,而不是仅凭 GPU 型号来选择。.
对于灵活的云端 GPU 工作负载,, RunPod 以及 Vast.ai 是进行比较的有用平台。对于运行时间较长的专用 GPU 基础设施,, 数据库集市 提供按月租用的GPU服务器配置。.
| 服务提供商 | 基础设施模型 | 适用于 |
|---|---|---|
| RunPod | GPU 云 / 无服务器 / 集群 | 训练、推理和灵活的工作负载 |
| 广阔的.ai | GPU 市场 / 云服务 | 价格敏感且灵活的 GPU 计算 |
| 数据库集市 | 专用GPU服务器 | 长期运行的 GPU 工作负载 |
GPU 的库存、可用性、价格和配置会频繁变化。部署前,请务必核实具体的 GPU、VRAM、CPU、RAM、存储、网络、计费模式和位置。.

GPU 服务器与 GPU 云的定价对比
这两款机型的价格通常不同。.
专用GPU服务器:
每月服务器费用 + 可选软件 + 附加服务
GPU 云:
GPU 运行时 + CPU/内存 + 存储 + 网络 + 其他云服务
错误在于仅将以下内容进行比较:
月费与时费的对比。.
相反,应比较完成该工作量的总成本。.
如何计算实际的GPU成本
关于 GPU 云:
每小时GPU价格 × GPU数量 × 运行时间 = 计算成本
然后添加适用内容:
- 存储
- 网络传输
- 持久卷
- 快照
- 其他平台服务
对于专用 GPU 服务器:
每月服务器费用 ÷ GPU有效运行小时数 = 每有效运行小时的实际成本
这样得出的比较结果要更有参考价值得多。.
示例:为什么利用率能改变一切
假设一台 GPU 云实例每小时的费用为 $2。.
按每月100小时计算:
$2 × 100 = $200
700小时:
$2 × 700 = $1,400
如果同等配置的独立显卡服务器的月租费用远低于后者,那么独立显卡方案在经济上可能更具吸引力。.
但如果工作负载仅需100小时,租用专用服务器可能会浪费其大部分可用容量。.
此示例仅供说明,并非当前供应商的报价。.
AI训练中的GPU服务器与GPU云对比
训练工作负载可适应这两种模型中的任何一种。.
GPU 云对以下场景尤其具有吸引力:
- 实验
- 不定期培训
- 短期的微调任务
- GPU 配置要求的变更
- 临时多GPU集群
在以下情况下,专用 GPU 服务器会变得更有吸引力:
- 训练持续进行
- GPU利用率是可以预测的
- 几个月来都需要使用同一套硬件
- 大型本地数据集被反复重复利用
- 持久化环境非常有价值
大型语言模型(LLM)推理:GPU服务器与GPU云的对比
推断经济学在很大程度上依赖于流量模式。.
考虑以下两个应用:
应用 A:全天候稳定的推理流量
专用 GPU 服务器之所以能实现高利用率,是因为 GPU 会持续处理请求。.
应用 B:不规则的流量峰值
云或无服务器 GPU 基础设施之所以具有吸引力,是因为其计算能力能够根据需求动态调整。.
某些无服务器 GPU 服务甚至可以在没有请求的期间将工作进程缩减至零。.
稳定的需求 → 专用产能
需求波动 → 弹性产能
大型语言模型(LLM)的GPU服务器与GPU云对比
大型语言模型需要的不仅仅是GPU计算能力。.
评估:
- VRAM
- 内存带宽
- 上下文长度
- KV缓存
- 量化
- GPU数量
- GPU间通信
- 存储
- 网络
如果您正在权衡特定款NVIDIA加速器之间的选择,请参阅我们的
NVIDIA A100 与 H100 对比
以及
NVIDIA H100 与 H200 对比.
GPU 服务器与 GPU 云的可扩展性对比
可扩展性是 GPU 云的最大优势之一。.
一个云工作流可能如下所示:
1 个 GPU → 2 个 GPU → 8 个 GPU → 多节点集群 → 缩容
该组织并不一定需要持续维持全部这些产能。.
专用 GPU 基础设施的扩展方式有所不同:
服务器 1 → 添加服务器 2 → 添加服务器 3
对于稳定的工作负载,这种方法效果极佳,但弹性较差。.
GPU的供应情况至关重要
云的可扩展性存在一个重要限制:所请求的 GPU 必须确实可用。.
需求量大的加速器可能会因供应商和地区不同而面临库存限制。.
预留专用服务器可确保对特定 GPU 的可预测访问。.
对于必须持续保持可用容量的生产工作负载而言,这一点至关重要。.
云的可扩展性 ≠ GPU 可用性的保证。.
GPU服务器与GPU云存储
AI数据集和模型可能会占用大量存储空间。.
专用GPU服务器通常会在服务器配置中包含本地SSD或NVMe存储。.
GPU 云平台可能会将计算与持久化存储分离。.
这虽然能提供灵活性,但也可能影响总成本。.
在比较不同服务提供商之前,请先计算:
模型存储 + 数据集存储 + 检查点 + 持久卷。.
GPU服务器与GPU云网络的对比
对于分布式人工智能而言,网络连接变得至关重要。.
单个 GPU 工作负载可能不需要复杂的网络配置。.
一个由八个GPU组成的训练集群与一个多节点训练集群可能截然不同。.
比较:
- NVLink
- NVSwitch
- InfiniBand
- 高速以太网
- 节点间带宽
- 互联网带宽
- 数据转让定价
高速GPU + 低速网络 = 昂贵的瓶颈。.
开发中的GPU服务器与GPU云对比
在开发过程中,GPU云通常特别方便。.
开发人员可以尝试不同的 GPU,而无需锁定某种服务器配置。.
例如:
RTX 4090 → A100 → H100 → H200
在决定长期基础设施之前,团队可以对工作负载进行基准测试,并确定哪种加速器最具经济效益。.
这遵循了人工智能基础设施中一条最实用的规则:
先进行基准测试,再进行提交。.
初创企业应选择 GPU 服务器还是 GPU 云服务
人工智能初创企业往往面临着快速变化的基础设施需求。.
在早期开发阶段,GPU利用率可能难以预测。.
GPU 云服务既能降低投入门槛,又能让团队测试多种类型的加速器。.
随着产品日趋成熟,且GPU需求变得可预测,或许值得考虑评估专用基础设施。.
一种常见的进展过程是:
实验 → 云 GPU → 测量利用率 → 优化 → 专用算力
混合型 GPU 基础设施
选择不必非要完全采用专用模式,也不必完全采用云模式。.
混合架构可以使用:
专用 GPU 服务器 → 基准工作负载
GPU 云 → 峰值容量
这既能提供可预测的长期容量,又能在训练高峰或流量激增期间灵活调配资源。.
对于规模较大的 AI 运算,与将所有工作负载强行部署到单一基础设施类型相比,该模型的效率更高。.
GPU服务器与GPU云:优缺点对比
| 专用GPU服务器 | GPU 云 | |
|---|---|---|
| 定价模式 | 通常是每月一次 | 按使用量计费 |
| GPU 访问 | 可预见的 | 视供应情况而定 |
| 缩放 | 身体素质 | 灵活的 |
| 短工作负载 | 可能效率低下 | 非常棒 |
| 连续工作负载 | 可能具有成本效益 | 成本取决于费率和利用率 |
| 实验 | 仅限于已安装的显卡 | 轻松更换显卡 |
| 环境 | 持久 | 灵活的 |
| 主要优势 | 专用容量 | 弹性容量 |
如果……,请选择专用GPU服务器
- 您的 GPU 持续运行
- 您的利用率可预测
- 您需要保证能够访问 GPU
- 你需要一个持久化环境
- 您将大型数据集存储在本地
- 您需要对服务器拥有完全控制权
- 每月部署一台服务器可降低总工作负载成本
如果……,请选择 GPU Cloud
- 您的 GPU 使用情况不稳定
- 您运行临时培训作业
- 你想测试不同的GPU型号
- 您需要快速部署
- 您需要临时多GPU算力
- 您的推理流量发生了显著变化
- 您希望避免为闲置的GPU付费
选择前应考虑的问题
- 该工作负载需要哪种 GPU?
- 需要多少VRAM?
- 您每月预计会使用多少GPU小时?
- 需求是稳定的还是波动的?
- 需要多少个GPU?
- 你需要 NVLink 吗?
- 您需要多节点训练吗?
- 需要多少存储空间?
- 您将产生多少网络流量?
- 是否会产生数据传输费用?
- 您需要有保障的GPU可用性吗?
- 工作负载能否承受中断?
- 每完成一项培训任务的成本是多少?
- 每次推理请求或每个令牌的费用是多少?
- 每月的总基础设施成本是多少?
GPU服务器与GPU云:哪一种更适合人工智能?
无论是GPU服务器还是GPU云,都并非在所有情况下都更适合人工智能。.

当工作负载持续运行且 GPU 利用率可预测时,专用 GPU 服务器尤其具有吸引力。如果昂贵的加速器在大部分计费周期内都能保持高效运行,那么支付固定的月费在经济上就合算。.
当需求发生变化时,GPU 云服务尤其具有吸引力。开发人员可以在需要时部署 GPU,尝试不同的加速器,扩展训练基础设施,并避免为闲置的计算资源持续付费。.
因此,决策应以工作负载的行为为出发点,而非基础设施的偏好。.
持续需求 → 评估专用 GPU 服务器
需求波动 → 评估 GPU 云服务
基线 + 流量峰值 → 评估混合 GPU 基础设施
不要仅凭GPU的每小时价格来比较基础设施。.
请按照以下决策路径操作:
AI 工作负载 → GPU → VRAM → GPU 数量 → 利用率 → 运行时间 → 存储 → 网络 → 可用性 → 总成本 → 合适的基础设施。.
最佳的AI基础设施应能在提供所需性能的同时,最大限度地减少GPU闲置容量并降低总工作负载成本。.