

GPU 服务器迁移检查清单:CUDA 驱动程序、容器、模型和停机时间
GPU 服务器迁移检查清单可帮助 AI 团队在云实例、专用服务器和托管服务提供商之间迁移工作负载,同时避免不必要的停机时间。与普通的网站迁移不同,GPU 基础设施的变更可能会导致 CUDA 驱动程序冲突、容器不兼容等问题……
NVIDIA GPU 服务器驱动程序兼容性:CUDA、容器与部署风险
NVIDIA GPU 服务器驱动程序的兼容性对于可靠的人工智能训练、推理和容器化部署至关重要。如果 GPU 的驱动程序、CUDA 运行时、容器配置或机器学习框架存在问题,即使是最强大的 GPU 也无法正确运行您的工作负载……
Cherry Servers 面向私有 AI 的 GPU 裸机服务器:隔离、存储及基础设施成本
对于希望对模型部署、敏感数据集以及长期运行的推理工作负载拥有更大控制权的企业而言,私有AI基础设施正逐渐成为一项重要考量因素。虽然共享GPU云平台具备灵活性,但专用GPU服务器则提供了……
RunPod 与 Vast.ai 对比:GPU 租赁的可靠性、部署灵活性及 AI 成本
租用GPU已不再仅仅是寻找最低的小时费率。对于AI开发者而言,不稳定的实例、存储费用、部署缓慢以及训练任务中断等问题,都可能让一台看似便宜的GPU变得出人意料地昂贵。在……
OVHcloud GPU 服务器评测:专用加速器、VRAM 及工作负载适配性
租用 GPU 服务器已不再仅仅是寻找最快的 NVIDIA 加速器。对于 AI 推理、机器学习、视频处理和图形处理等工作负载而言,做出正确决策取决于 GPU 内存、部署灵活性、CPU 资源……
Vultr 云 GPU 评测:NVIDIA 实例、存储及 AI 部署成本
在云端租用 NVIDIA GPU 可以省去购买专用硬件的初期费用。不过,选择 GPU 实例不仅仅是比较加速器型号或广告中的每小时费率。GPU 内存、存储持久性……
云GPU与专用GPU服务器:AI工作负载的灵活性、利用率及总成本
进行人工智能应用时,是应该从云平台租用GPU,还是选择专用GPU服务器?答案不仅取决于GPU的规格或宣传的每小时价格。人工智能工作负载对资源的需求差异很大……
无服务器 GPU 平台评测:冷启动、自动扩展和生产环境中的 AI 成本
本篇关于无服务器 GPU 平台的评测,对比了现代 AI 推理基础设施背后的技术、部署模式和运营成本。我们分析了 GPU 冷启动、自动扩展行为、并发性、延迟、利用率以及实际生产环境中的服务成本……
NVIDIA Blackwell GPU 云服务评测:B200、GB200 及 AI 基础设施采购考量
本篇关于 NVIDIA Blackwell GPU 云服务的评测,从 AI 基础设施采购的角度出发,对 B200、GB200 Grace Blackwell 超级芯片以及 GB200 NVL72 进行了分析。对于部署大型语言模型、推理系统、生成式 AI 应用以及分布式……
企业级AI的最佳GPU服务器:私有基础设施、安全性与可扩展性
为企业人工智能选择最佳的GPU服务器,其方法与为小型实验或短期人工智能开发选择硬件有所不同。企业必须考虑私有基础设施、敏感数据保护、GPU性能、合规义务……
最适合人工智能初创企业的GPU服务器:云服务与专用基础设施对比分析
为人工智能初创企业寻找最佳的GPU服务器,不仅仅在于选择一款性能强大的NVIDIA或AMD加速器。处于初创阶段的人工智能公司必须在模型性能、GPU内存、基础设施成本、部署速度以及……之间取得平衡。
在 GPU 服务器上对大型语言模型进行微调:LoRA、QLoRA 及硬件要求
为大型语言模型(LLM)的微调选择合适的 GPU 基础设施,需要采取与普通 LLM 推理不同的方法。训练工作负载必须考虑模型权重、梯度、优化器状态、激活值、序列长度以及批量大小。由于……
多GPU服务器托管:PCIe、NVLink及扩展成本解析
选择合适的多GPU服务器托管方案,不仅仅只是计算显卡的数量。配备四块或八块GPU的服务器虽然可能提供强大的计算能力,但实际性能还取决于GPU内存、PCIe连接、NVLink……
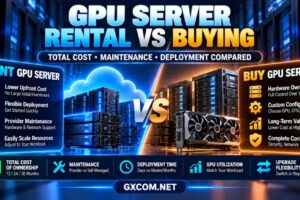
GPU服务器租赁与购买:总成本、维护及部署对比
对于开展人工智能训练、大型语言模型、3D渲染、科学计算以及GPU密集型应用的企业而言,在租赁GPU服务器与购买GPU服务器之间做出选择,是基础设施方面最重要的决策之一。购买GPU服务器可以提供……
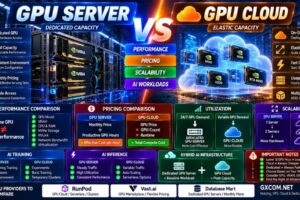
GPU服务器与GPU云:性能、定价及哪种更适合AI?
AI 基础设施可以通过两种截然不同的方式进行部署:租用专用 GPU 服务器以实现对硬件的持续访问,或者使用 GPU 云基础设施,该基础设施可在工作负载需要时进行配置。这两种方式……