
GPU服务器已成为人工智能训练、大型语言模型(LLM)推理、机器学习、生成式人工智能、渲染、科学计算以及其他高度并行工作负载不可或缺的基础设施。.
但要找到 最划算的GPU服务器优惠 这不仅需要比较每小时或每月的价格。对于某些 AI 工作负载而言,价格低廉的 RTX 4090 实例就能提供极高的性价比;而对于更大规模的模型,则可能需要 NVIDIA A100、H100、H200 或更新款 Blackwell GPU 所提供的额外显存、内存带宽、企业级功能或多 GPU 处理能力。.
本 GXCOM.NET 指南记录了当前的 GPU 云服务和专用 GPU 服务器方案, ,包括按小时计费的云端 GPU、市场实例、专用 NVIDIA 服务器以及长期运行的 AI 基础设施。.
我们不仅根据价格对服务商进行排名,还会综合比较其GPU型号、VRAM、计费模式、CPU和内存资源、存储空间、带宽、可用性以及对工作负载的适用性。.
交易进展: GPU 的价格和供货情况可能迅速变化。随着供需波动,市场价格的变化可能更为迅速。在部署工作负载之前,请务必核实当前配置和最终价格。.
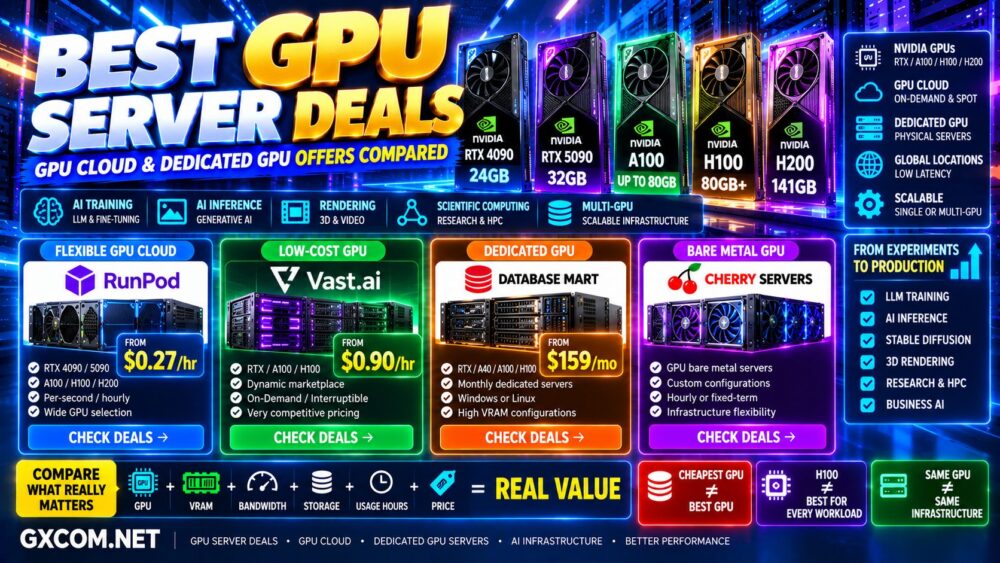
最超值的GPU服务器优惠:快速对比
| 服务提供商 | GPU 模型示例 | 定价模式 | 最适合 |
|---|---|---|---|
| RunPod | RTX 4090 / 5090 / A100 / H100 / H200 / B200 / B300 | 每秒 / 每小时 | AI 云和灵活的 GPU 工作负载 |
| Vast.ai | RTX / A100 / H100 / H200 / Blackwell | 动态市场定价 | 低成本 GPU 租赁 |
| 数据库集市 | RTX / A40 / A100 / H100 | 按月计费的专用服务器 | 长期运行的专用 GPU 工作负载 |
| Cherry 服务器 | GPU 裸机配置 | 按小时计费/固定期限的基础设施 | 裸机与基础设施灵活性 |
并不存在放之四海皆准的最便宜的GPU供应商,因为性价比主要取决于GPU型号、地区、供应情况、计费类型以及您每月实际使用该硬件的时长。.
🔥 值得立即关注的精选 GPU 服务器优惠
如果您已准备好部署 AI 工作负载,请从工作负载入手,而不是从 GPU 名称入手。.
弹性 GPU 云 → RunPod
低成本 GPU 市场 → Vast.ai
专用GPU服务器 → 数据库集市
GPU / 裸机基础设施 → Cherry Servers
然后进行比较:
工作负载 + 显存 + 内存带宽 + 计算能力 + 使用时长 + 基础设施成本 = GPU的实际价值
1. RunPod GPU 云服务优惠
RunPod 是面向 AI 开发者最有趣的 GPU 云平台之一,因为它提供了种类繁多的 NVIDIA GPU,且无需客户购买实体硬件。.
其当前的GPU产品线涵盖了从经济实惠的工作站级GPU,到现代数据中心加速器,再到NVIDIA Blackwell硬件。.
当前 Secure Cloud 的参考价格包括:
| GPU | VRAM | 当前价格* | 最佳匹配 |
|---|---|---|---|
| RTX A5000 | 24 GB | 从 $0.27/小时 | 经济型 AI 工作负载 |
| A40 | 48 GB | 从 $0.49/小时 | 推理 / 更大规模的模型 |
| RTX A6000 | 48 GB | 从 $0.53/小时 | AI / 渲染 |
| RTX 4090 | 24 GB | 从 $0.74/小时 | 高性价比的人工智能 |
| RTX 5090 | 32 GB | 从 $0.99/小时起 | 高性能消费级 GPU 工作负载 |
| H100 NVL | 94 GB | 从 $3.19/小时起 | 大型人工智能工作负载 |
| H200 | 141 GB | 每小时$4.59起 | 大型AI模型 |
| B200 | 180 GB | $ 每小时6.79 | 高级人工智能工作负载 |
*更新时的参考价格。GPU 供应情况、云类型、区域和价格可能会发生变化。.
RunPod 还提供无服务器 GPU 基础设施和多节点集群,因此最经济的部署模式取决于工作负载是持续运行,还是仅响应请求。.
为什么 RunPod 具有成本效益
当您不需要 GPU 持续运行时,按小时计费的 GPU 云基础设施尤其具有吸引力。.
例如,如果某项人工智能工作负载每月仅需100 GPU小时,按使用量租用要比为整个月维护一台专用GPU服务器经济得多。.
RunPod 特别适合以下人群:
- LLM推理
- 模型训练
- 微调
- Stable Diffusion
- 图像生成
- 人工智能开发
- 研究
- 批处理
每小时价格 × 实际使用小时数 = 更具参考价值的成本指标。.
2. Vast.ai 的 GPU 优惠活动
Vast.ai 则采取了不同的做法,它运营着一个市场,在该市场上,GPU 的价格受供需关系的影响。.
这可以带来极具竞争力的价格,特别是对于在硬件、位置、主机特性及可用性方面较为灵活的开发者而言。.
该平台目前支持数十种GPU类型,涵盖从消费级RTX硬件到A100、H100、H200以及最新的Blackwell GPU等。.
Vast.ai 定价模式
Vast.ai 目前提供三种主要定价模式:
- 点播: 专为需要可靠持续可用性的工作负载而设计。.
- 可中断: 可回收的低成本实例,适用于容错型工作负载。.
- 已预留: 长期合作协议,若工作量稳定,可享受折扣优惠。.
当您的工作流支持检查点保存和恢复时,可中断实例对于批量训练而言尤其具有吸引力。.
然而,由于市场定价机制,您想要的地点或硬件配置下,并不一定总能找到最便宜的报价。.
最低的显卡价格 ≠ 保证有货。.
哪些人应该考虑使用 Vast.ai?
Vast.ai 对于以下人群尤其具有吸引力:
- 注重预算的人工智能开发者
- 实验工作负载
- 批量训练
- Stable Diffusion
- 研究
- 灵活的推理工作负载
- 用户习惯于比较市场中的实例
在比较实例时,不要只看GPU的价格。.
主机可靠性、CPU 资源、内存、存储速度、网络性能、区域和可用性都会影响用户体验。.
3. 数据库集市专用 GPU 服务器优惠活动
当您需要物理的或长期运行的专用 GPU 环境,而非临时性的云实例时,数据库集市就显得更有吸引力了。.
其当前的GPU服务器产品目录包括NVIDIA RTX、A40、A100、H100以及多GPU配置。.
当前的参考配置包括:
| GPU | GPU 内存 | 当前价格* |
|---|---|---|
| RTX 2060 | 6 GB | 约 $159/月 |
| A40 | 48 GB | 约$439/月 |
| A100 | 40 GB | 约$639/月 |
| A100 | 80 GB | 约 $1,559/月 |
| H100 | 80 GB | 约 $2,099/月 |
*当前参考价格。硬件供应情况和促销价格可能会发生变化。.
当工作负载需要持续运行时,专用 GPU 服务器就显得更有吸引力了,因为您支付的是对物理配置的专属使用权,而不是反复启动和停止云实例。.
何时专用GPU能胜过GPU云
假设一台云端 GPU 的每小时费用为 $3。.
连续运行730小时将产生:
$3 × 730 = $2,190/月
如果同等配置的独立服务器价格远低于此,而您确实需要近乎持续的利用率,那么独立基础设施在经济性方面可能更具优势。.
但进行比较时,必须使用同等配置的硬件,并涵盖 CPU、内存、存储、带宽、管理功能和灵活性。.
每小时GPU价格 × 利用率 = 云服务与专用服务器成本对比的关键计算。.
4. Cherry Servers 的 GPU 和裸机基础设施
如果您希望基础设施更接近裸机,而非传统的共享云计算,那么Cherry Servers值得考虑。.
其更全面的平台提供了专用服务器部署、基于API的基础设施管理、固定期限和按小时计费、存储服务、私有网络以及其他有助于构建自定义计算环境的组件。.
该模型可满足以下需求的团队:
- 裸机基础设施
- AI 工作负载
- 自定义服务器配置
- 高速存储
- 私有网络
- 基础设施自动化
在评估 GPU 配置时,应比较整个系统,而不是仅考虑加速器本身。.
即使拥有强大的GPU,其性能仍可能因CPU性能不足、系统内存不足、存储吞吐量不足或网络带宽不足而受到限制。.
RTX 4090 GPU 服务器优惠活动
对于注重成本的人工智能用户而言,NVIDIA RTX 4090 依然极具吸引力,因为其 24 GB 显存和强大的计算性能足以应对许多中小规模的人工智能工作负载。.
典型用例包括:
- Stable Diffusion
- 图像生成
- 小型大语言模型(LLM)推理
- 微调
- 渲染
- 人工智能开发
对于人工智能而言,其最大的局限性往往在于内存。.
如果工作负载需要超过 24 GB 的显存,您可能需要使用量化、卸载、多张 GPU 或更高内存容量的加速器。.
高性能 GPU + VRAM 不足 = 选错了 GPU。.
RTX 5090 GPU 服务器优惠活动
RTX 5090 将 GPU 显存提升至 32 GB,并提供了新一代性能,因此对于那些比 RTX 4090 需要更大容量、但未必需要企业级加速器的 AI 工作负载而言,它正成为一个越来越有吸引力的选择。.
对于以下人群而言,它可能特别具有吸引力:
- AI推理
- 生成式人工智能
- 渲染
- 微调
- 发展
- 中型车型
然而,面向消费者的RTX显卡和面向企业数据中心的显卡所针对的运行环境各不相同。.
不要仅凭基准测试成绩来做出选择。.
NVIDIA A100 GPU 服务器优惠活动
NVIDIA A100 之所以依然具有竞争力,是因为它兼具大容量 HBM 内存选项、高内存带宽、企业级功能以及多 GPU 支持能力。.
A100 配置在以下方面尤其有用:
- 人工智能训练
- 大型模型推理
- 多GPU工作负载
- 科学计算
- 企业级人工智能
当模型规模成为限制因素时,80 GB 配置相比 24 GB 的消费级 GPU 具有显著的内存优势。.
请阅读我们的 NVIDIA A100 与 H100 对比 在决定新款 H100 是否值得多花这笔钱之前。.
NVIDIA H100 GPU 服务器优惠活动
H100 专为高要求的 AI 训练和推理工作负载而设计,在许多现代工作负载中,其 AI 专用性能远超上一代加速器。.
但H100的价格仍远高于消费级GPU。.
在以下情况下,这种做法最为合理:
- 培训时间具有巨大的经济价值
- 你需要大容量的显存
- 你需要较高的内存带宽
- 现代张量核(Tensor Core)功能可提升您的工作负载性能
- 您在相当大的AI规模上开展业务
对于较小型号,RTX 4090、RTX 5090、A40、L40 系列 GPU 或 A100 可能提供更优的性价比。.
H100 速度更快 ≠ H100 对所有工作负载都更具成本效益。.
NVIDIA H200 GPU 服务器优惠活动
对于内存密集型人工智能应用而言,H200 尤为引人关注,因为与 H100 配置相比,它大幅提升了 GPU 的内存容量。.
RunPod 目前提供配备 141 GB 显存的 H200 实例,这使得它们对于那些需要将更多权重和上下文保存在 GPU 内存中才能充分发挥性能的大型模型而言极具吸引力。.
更大的内存容量可以在某些工作负载中减少对多GPU分区的依赖。.
请参阅我们的 NVIDIA H100 与 H200 对比 以获取详细分析。.
GPU云与专用GPU服务器
| 因子 | GPU 云 | 专用GPU |
|---|---|---|
| 初始成本 | 低 | 更高的月供 |
| 账单 | 每小时 / 每秒 | 通常是每月一次 |
| 缩放 | 简单 | 取决于硬件 |
| 短期工作 | 非常棒 | 往往效率低下 |
| 持续使用 | 可能会很贵 | 能提供更高的性价比 |
| 硬件控制 | 取决于平台 | 更强的控制力 |
| 可用性 | 可能会波动 | 保留的硬件 |
如需阅读完整分析,请参阅我们的 GPU服务器与GPU云的对比.
您实际上需要多少GPU小时?
这是GPU托管领域最重要的问题之一。.
如果您的工作负载运行:
每天 2 小时 → 每月约 60 GPU 小时
每天 8 小时 → 每月约 240 GPU 小时
每天 24 小时 → 每月约 730 GPU 小时
现在将小时费率乘以您预计的实际利用率。.
这使得与专用月租服务器之间的比较更加有意义。.
GPU显存的重要性远超许多买家的预期
对于人工智能工作负载而言,GPU内存将决定模型能否运行。.
相比之下,一款速度更快但VRAM不足的GPU,可能不如一款速度较慢但拥有足够模型内存的加速器实用。.
比较:
- 模型尺寸
- 精度
- 量化
- 上下文长度
- 批次大小
- 训练与推理
先选择显存,再比较显卡的性能和价格。.
不要仅凭显卡名称来比较显卡优惠
两份宣传同一款H100的报价,其整体价值仍可能大相径庭。.
请检查:
- PCIe 与 SXM 配置对比
- GPU内存
- CPU 资源
- 系统内存
- NVMe 存储
- 网络带宽
- 地区
- 多GPU互连
- 计费粒度
- 持久化存储成本
相同的 GPU ≠ 相同的基础设施。.
现货和可中断型 GPU 交易
按需型或可中断型 GPU 实例可大幅降低 AI 基础设施成本。.
它们特别适用于:
- 批处理
- 容错训练
- 渲染
- 实验
- 包含频繁检查点的负载
当意外中断会导致生产服务中断或造成大量工作丢失时,这些方法就不太合适了。.
价格越低 → 中断风险越高。.
GPU服务器交易的警示信号
当某款显卡的报价明显比其他所有产品都低,却未对底层架构作出明确说明时,请务必谨慎。.
请检查:
- CPU 资源非常有限
- 系统内存不足
- 低速存储
- 昂贵的持久性存储
- 带宽有限
- 主机可靠性差
- 作为普通实例呈现的可中断实例
- GPU型号不明确
- 数量有限
如果周围的基础设施阻碍了廉价显卡的高效运行,那么它也就毫无用处。.
应该等到“黑色星期五”再买显卡吗?
GPU云服务的定价全年都会有所变动,因此您不必非得等到“黑色星期五”才能找到有竞争力的价格。.
不过,对于专用GPU服务器、预留基础设施以及长期合约而言,“黑色星期五”的优惠尤其值得关注。.
如果您的购买计划比较灵活,请将本页的当前价格与我们的 “黑色星期五”GPU服务器优惠活动.
GXCOM.NET 如何评估 GPU 服务器优惠活动
GXCOM.NET 并非仅根据每小时或每月的最低价格来对 GPU 基础设施进行排名。.
我们考虑:
- GPU 型号
- VRAM
- 内存带宽
- GPU架构
- CPU 资源
- 系统内存
- 存储
- 带宽
- 地区
- 计费粒度
- 可用性
- 专用基础设施与共享基础设施
- 长期成本
- 工作负荷的适宜性
目标是:
工作负载 → 显存 → GPU → 基础设施 → 利用率 → 总成本 → 最优GPU方案。.
最佳 GPU 服务器优惠常见问题解答
哪家GPU云服务最便宜?
答案经常变化,因为市场和云端 GPU 的价格会因型号、地区、可用性和计费类型而异。Vast.ai 能提供极具竞争力的市场价格,而 RunPod 则提供种类繁多的按需 GPU 选项,且定价透明。.
RTX 4090 适合用于人工智能吗?
是的。它配备了 24 GB 的显存,并具备强大的计算性能,因此对于许多 AI 推理、图像生成、开发以及小型训练工作负载而言都极具吸引力。较大的模型可能需要更多的 GPU 内存。.
我应该租A100还是H100?
对于许多现代 AI 工作负载而言,H100 能提供显著更强的性能;而在无需 H100 最大性能的情况下,A100 则能提供更高的性价比。模型规模、精度、内存需求、训练时间以及每小时价格应作为选择的依据。.
H200 比 H100 更好吗?
H200 提供了显著更多的 GPU 内存,对于内存密集型的大型模型工作负载而言尤其具有吸引力。当不需要额外内存时,H100 可能仍能提供更优的性价比。.
GPU云服务比专用GPU服务器更便宜吗?
对于间歇性工作负载而言,GPU 云通常更具成本效益,因为您只需在使用加速器时付费。当利用率持续较高时,专用 GPU 服务器则可能更具成本效益。.
选择AI GPU时,最重要的是什么?
首先考虑VRAM需求,然后比较内存带宽、计算性能、模型兼容性、多GPU需求、基础设施以及总成本。.
最佳 GPU 服务器优惠:最终结论
该 最划算的GPU服务器优惠 这更多取决于你的工作负载,而不是取决于标价最低的显卡。.
RunPod 对于灵活的 GPU 云工作负载尤其具有吸引力,并可访问种类繁多的 NVIDIA 硬件。对于愿意仔细比较主机和可用性的买家而言,Vast.ai 能够提供极具竞争力的市场价格。.
如果您希望为持续运行的工作负载配备专用 GPU 硬件,Database Mart 会更具吸引力;而若需可定制的裸机基础设施,Cherry Servers 则值得作为对比参考。.
在租用任何 GPU 服务器之前,请按照以下流程操作:
工作负载 → VRAM → 内存带宽 → GPU → 使用时长 → 基础设施 → 总成本。.
不要仅仅因为H100速度更快就直接租用它,也不要仅仅因为每小时费率看起来很诱人就直接租用最便宜的RTX实例。.
最划算的GPU方案,就是能够高效运行您工作负载且成本最低的GPU基础设施。.