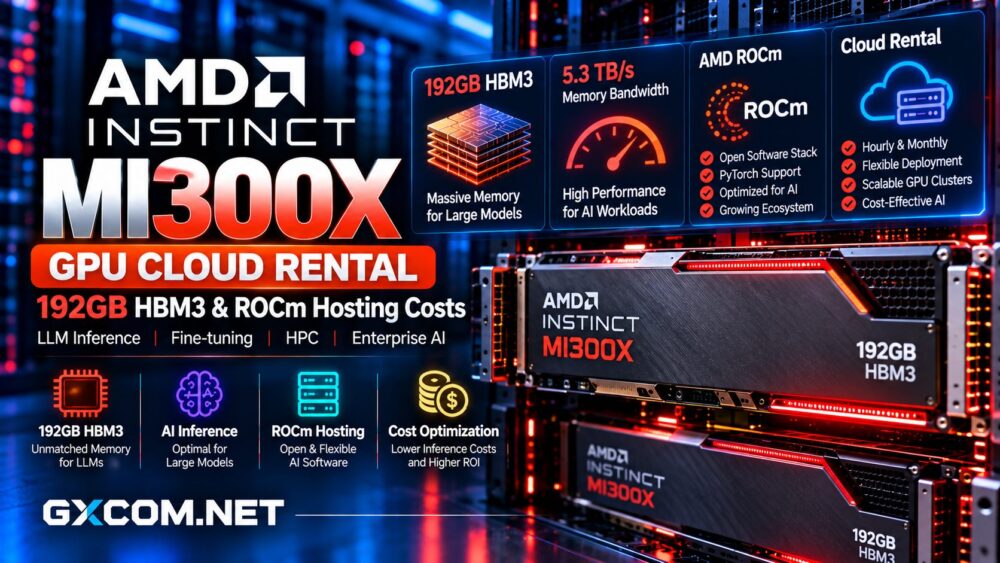
租赁 AMD Instinct MI300X GPU 可让 AI 团队无需购买企业级加速器,即可使用 192GB 的高带宽内存。对于大型语言模型的推理、微调以及内存密集型计算而言,这一容量可减少将模型分布到多块较小 GPU 上的需求。.
不过,最好的 AMD MI300X GPU 云租赁 该选项不仅取决于内存规格。ROCm 兼容性、实例可用性、网络、存储以及实际工作负载吞吐量,这些因素共同决定了该租赁方案是否物有所值。.
本指南将探讨来自 Vultr 以及 RunPod, ,探讨了专用基础设施的替代方案,并阐述了如何评估总体部署成本。.
为什么要租用 AMD MI300X 显卡?
MI300X 采用 AMD CDNA 3 架构,配备 192GB HBM3 内存,理论内存带宽高达 5.3TB/s。它通过 AMD 的 ROCm 软件生态系统支持 FP8、BF16 和 FP16 工作负载。.
其超大内存容量对于推理部署而言尤为具有吸引力,因为在这些场景中,模型权重和键值缓存会占用大量GPU内存。.
| 规格 | AMD MI300X |
|---|---|
| 建筑 | AMD CDNA 3 |
| 记忆 | 192GB HBM3 |
| 峰值内存带宽 | 5.3TB/s |
| 软件平台 | AMD ROCm |
| 八路GPU平台内存 | 约1.5TB HBM3 |
这些是硬件性能指标,并非保证的应用程序基准测试结果。实际性能取决于型号架构、软件优化以及部署设置。.
有关基础设施基础知识,请参阅我们的 AI 服务器指南.
最佳 MI300X GPU 云租用服务商
Vultr:企业级 AMD GPU 云服务
Vultr 提供由 AMD Instinct MI300X 加速器驱动的云 GPU 基础设施。其公开资料介绍了 MI300X 实例以及面向高要求的人工智能和高性能计算工作负载的自助式 GPU 集群。.
Vultr 特别适合需要可扩展基础设施、云网络以及生产级 AI 服务支持的企业。.
下单前,请确认可用区域、GPU 分配、实例类型、存储配置以及适用的商业条款。.
考虑部署多GPU的团队还应了解互连拓扑和集群网络的详细信息,而不仅仅是比较GPU的数量。.
RunPod:用于 ROCm 工作负载的 MI300X 租赁服务
RunPod 推出了配备192GB HBM3内存并支持ROCm的MI300X GPU租赁服务。.
对于需要测试大型模型推理、PyTorch 应用程序以及兼容 AI 框架的开发者而言,其云环境值得评估。.
然而,已发布的 GPU 列表并不能保证客户尝试部署时该容量一定可用。.

在为生产项目制定预算之前,请先查看实时库存、相应的云层级、存储费用以及支持的软件镜像。.
我们的 RunPod GPU 云服务评测 提供了有关其部署和计费方式的更多背景信息。.
Cherry Servers:专用 GPU 基础设施的替代方案
Cherry 服务器 提供专用的裸机基础设施,这可能对需要服务器级控制和可预测资源分配的团队具有吸引力。.
此处将其列出仅作为基础设施的备选方案,并非已确认的MI300X租赁信息。.
在考虑与 MI300X 云服务方案相当的报价之前,买家应先确认具体的加速器型号、内存配置、部署时间表、网络配置以及月度承诺额度。.
MI300X 租赁价格:哪些因素决定了费用?
按小时计费的 GPU 费率虽然有助于初步比较,但很少能全面反映部署成本。.
请使用以下公式:
每月计算成本 = GPU 每小时费率 × GPU 数量 × 计费小时数
例如,假设每GPU小时的费用为$2.50,运行一台MI300X 200个计费小时所需的计算费用为$500。同期部署8个GPU所需的计算费用则为$4,000。.
这些数字仅供参考,并非服务提供商的实时价格。持久存储、网络、预留资源以及其他附加服务可能会增加账单金额。.
请将完整的报价与我们的 经济实惠的 GPU 服务器选项 而不是仅凭每小时费率来选择基础设施。.
192GB HBM3 对于大型语言模型来说够用吗?
一个以BF16精度存储的700亿参数模型,仅权重部分就约需140GB存储空间,这还不包括运行时开销和其他内存需求。.
这使得 MI300X 的 192GB 容量对于某些单 GPU 部署而言颇具吸引力。.
尽管如此,KV缓存、上下文长度、并发请求、临时缓冲区以及框架开销都可能显著影响实际内存使用情况。.
量化虽然可以降低内存需求,但应根据输出质量和吞吐量目标进行验证。.
请务必测试目标模型和服务配置,而不是假设宣传中的 GPU 内存能够保证生产环境中的容量。.
ROCm 托管:兼容性优先于成本
MI300X 使用 AMD ROCm 而非 NVIDIA CUDA。这一区别可能会影响部署时间和工程成本。.
PyTorch 以及 vLLM 等流行的推理框架均支持 ROCm,但必须确认其支持的版本、内核、容器及优化功能。.
依赖自定义 CUDA 扩展的应用程序可能需要进行额外开发或更换库。.
在租用长期算力之前,请先进行一次具有代表性的概念验证,内容应涵盖模型加载、推理吞吐量、内存使用情况以及应用程序的稳定性。.
如果迁移工作或软件兼容性问题导致部署延迟,那么较低的GPU使用率带来的成本节约将十分有限。.
MI300X 与 NVIDIA H100 的租赁经济性对比
MI300X 配备 192GB HBM3,而 NVIDIA H100 SXM 加速器仅配备 80GB HBM3。.
其更大的内存容量可以简化那些原本需要在多块GPU之间进行模型分割的工作负载。.
然而,H100 基础设施得益于成熟的 CUDA 生态系统,其性能对比在很大程度上取决于软件实现。.
对于能够轻松适配这两款加速器的工作负载,应以每次完成的推理请求或训练任务的成本为基准进行评估,而不是将内存容量作为性能排名的依据。.
请参阅我们的 NVIDIA H100 GPU 租赁优惠 对其他采购途径的比较。.
在什么情况下,部署一个配备8块GPU的MI300X集群才是明智之举?
AMD的MI300X平台配备8个加速器,集成了约1.5TB的HBM3内存,并采用了高速Infinity Fabric互连技术。.
此类基础设施能够支持分布式推理、大型模型训练以及要求严苛的科学计算工作负载。.
尽管如此,八个独立的云GPU实例不应自动被视为等同于一台由八个GPU相互连接的服务器。.
在采购多GPU算力之前,请先验证网络拓扑、通信带宽、集群操作以及工作负载扩展效率。.
在可能的情况下,先从较小的基准测试开始,只有当测得的吞吐量足以证明额外开销是合理的时,才进行扩展。.

计算 Real MI300X 的推理成本
对于生产推断而言,每百万个输出代币的成本可能比每小时的租赁费率更有参考价值。.
每百万产出代币的成本 = 基础设施总成本 ÷ 产出代币 × 1,000,000
假设在测试期间,一次部署的成本为 $25,并产生了 500 万个输出令牌。其测得的基础设施成本为每 100 万个输出令牌 $5。.
此示例未包含测试中未记录的费用。实际对比还应记录延迟、并发数、GPU利用率以及请求失败的情况。.
各团队应在真实的流量模式下重复进行测量,而不是仅依赖理论上的峰值性能。.
MI300X 租赁检查清单
- 请确认 MI300X GPU 的具体分配情况及可用区域。.
- 检查 ROCm、框架、驱动程序和容器的兼容性。.
- 测量模型的实际内存需求和吞吐量。.
- 请查阅按小时计费、存储和终止服务的相关政策。.
- 验证集群的网络和Infinity Fabric拓扑结构。.
- 在切合实际的产能利用率水平下比较生产成本。.
最终结论:哪种 MI300X 租赁方案最优?
对于企业级 MI300X 云部署和 GPU 集群而言,Vultr 是一个极具竞争力的选择。. RunPod 为正在评估基于 ROCm 的工作负载的团队提供了另一条有记录的 MI300X 租赁方案,具体视可用容量而定。.
如果买家愿意核实硬件的可用性并索取定制报价,可以考虑将Cherry Servers作为专用GPU基础设施的选项。.
最好的 AMD MI300X GPU 云租赁 它并非仅仅是广告中宣传的最便宜的实例。而是能够可靠地运行您的工作负载、支持您的软件堆栈,并以最低的可持续成本提供每个有效结果的配置。.