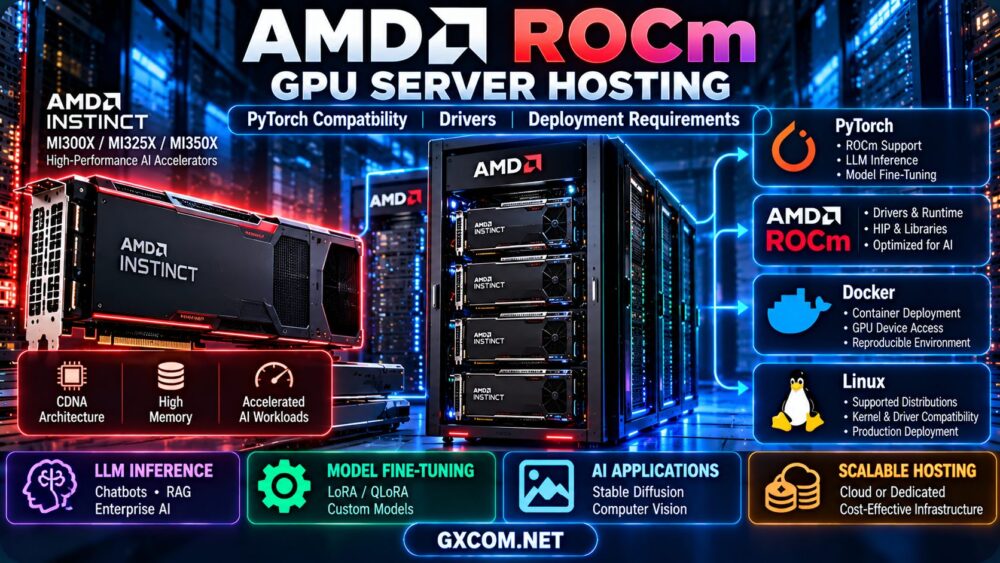
AMD ROCm GPU 服务器托管 对于在 AMD 加速器上部署 AI 工作负载的开发人员和企业而言,这正成为一个重要的考量因素。然而,选择 AMD GPU 服务器不仅仅涉及比较 GPU 内存、理论性能和租赁成本。操作系统、AMDGPU 驱动程序、ROCm 软件栈、PyTorch 构建、容器运行时以及应用程序库必须能够协同工作。.
如果软件环境无法识别这款强大的 AMD Instinct GPU,或者所需的框架不支持其架构,那么该 GPU 就无法提供有用的 AI 性能。.
本指南介绍了 ROCm 的工作原理、哪些兼容性检查至关重要、如何验证 PyTorch 的 GPU 访问权限,以及在租用 AMD GPU 服务器前应向托管服务商咨询哪些问题。此外,本指南还探讨了云 GPU 环境、专用服务器以及生产级 AI 工作负载在基础设施方面的注意事项。.
什么是 AMD ROCm GPU 服务器托管?
AMD ROCm 是一个用于 GPU 加速计算的开放式软件平台。它包含编程工具、运行时组件、库以及集成组件,这些组件被受支持的机器学习和高性能计算应用程序所采用。.
在基于 AMD GPU 的托管环境中,ROCm 提供了软件基础,使兼容的框架能够在 AMD 加速器上执行受支持的操作。.
对于人工智能开发者而言,最重要的组件通常包括:
- AMDGPU 内核驱动程序: 为受支持的 AMD 图形和计算硬件提供操作系统接口。.
- ROCm 运行时: 提供 GPU 计算运行时功能及配套软件组件。.
- HIP: AMD 用于 GPU 计算的编程接口和可移植性框架。.
- rocBLAS 及相关库: 加速受支持的数学运算和机器学习运算。.
- 支持 ROCm 的 PyTorch: 使兼容的 PyTorch 工作负载能够使用 AMD GPU 加速。.
- 集装箱工装: 有助于打包和重现应用程序环境。.
ROCm 并非仅仅是 AMD 版显卡驱动的安装过程。它是一个协调一致的软件环境,其组件必须与所选的硬件和操作系统相匹配。.
AMD ROCm GPU 服务器托管:兼容性检查清单
在订购 AMD ROCm GPU 服务器托管服务之前,请验证完整的硬件和软件堆栈。.
| 组件 | 需要核实的内容 | 为何这很重要 |
|---|---|---|
| GPU 型号 | 确切的 AMD Instinct 或 Radeon 加速器 | ROCm 对不同 GPU 的支持情况各不相同 |
| GPU架构 | 支持的目标,例如 gfx942 或 gfx950 | 编译后的内核可能需要架构支持 |
| 操作系统 | 支持的 Linux 发行版及版本 | 驱动程序与 ROCm 的兼容性 |
| 内核和驱动程序 | 兼容的 AMDGPU 驱动程序堆栈 | 硬件访问与运行时稳定性 |
| ROCm 发布 | 支持的 GPU 和操作系统版本 | 库与框架的集成 |
| PyTorch 构建 | 支持 ROCm 的轮子或容器 | PyTorch 中的 GPU 加速 |
| 容器访问 | 所需的设备节点和权限 | 容器内的 GPU 可见性 |
| 人工智能应用 | 支持的内核、扩展和库 | 推断或训练成功 |
正确的操作顺序是:选择受支持的 GPU 与操作系统组合,确认驱动程序兼容性,选择匹配的 ROCm 版本,然后安装相应的 AI 框架。.
有关官方要求,请查阅 AMD ROCm 兼容性对照表 部署之前。.
哪些 AMD GPU 支持用于 AI 服务器的 ROCm?
AMD Instinct 加速器是企业级人工智能、大型语言模型和高性能计算领域的重要选择。.
不过,购买者必须区分对 ROCm 的常规支持与对特定软件版本的支持。.
| AMD 显卡 | 建筑 | GPU 目标 | 部署注意事项 |
|---|---|---|---|
| Instinct MI210 | CDNA 2 | gfx90a | 查看支持的 ROCm 与操作系统组合 |
| Instinct MI250X | CDNA 2 | gfx90a | 验证多GPU和框架要求 |
| Instinct MI300X | CDNA 3 | gfx942 | 适用于大内存AI工作负载 |
| Instinct MI325X | CDNA 3 | gfx942 | 验证特定版本对操作系统和驱动程序的支持情况 |
| Instinct MI350X | CDNA 4 | gfx950 | 需要兼容的较新版本 ROCm 软件栈 |
| Instinct MI355X | CDNA 4 | gfx950 | 验证框架及优化内核的支持情况 |
本表列出了架构系列,并不构成普遍的兼容性保证。请查阅最新的官方兼容性列表,以确认具体的 GPU、ROCm 版本和操作系统。.
AMD Radeon GPU 需要额外注意。一款适用于图形处理的 Radeon 显卡,并不一定自动支持所有的 ROCm 计算工作流或企业部署。.
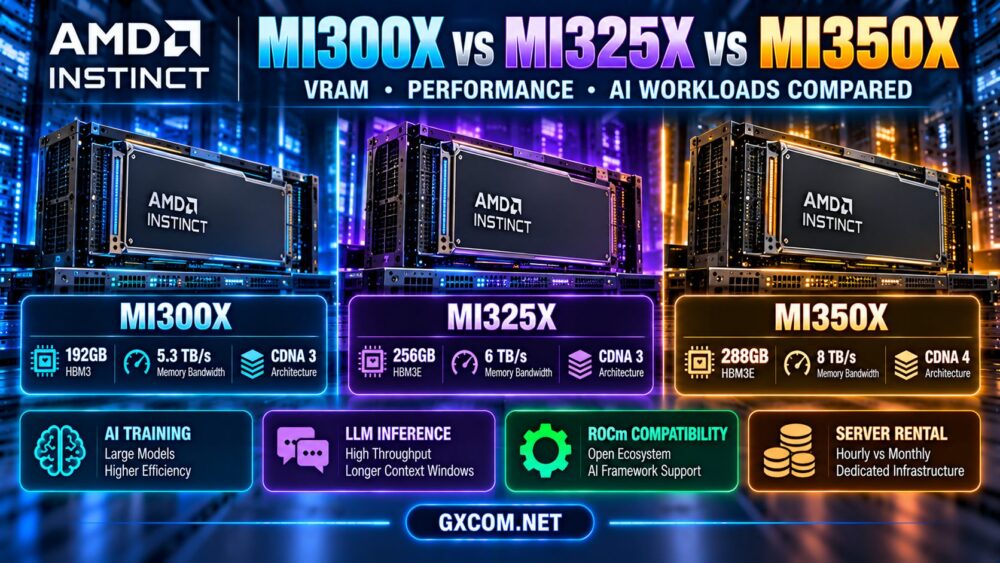
如需了解高内存 AMD 加速器的对比分析,请阅读我们的 AMD Instinct MI300X、MI325X 与 MI350X 服务器对比.
ROCm 操作系统和驱动程序要求
Linux 是基于 ROCm 的 AI 基础设施的核心部署环境。支持的发行版和内核版本取决于所选的 ROCm 版本和加速器。.
选择一个受支持的 Linux 发行版
AMD 文档中提供了对 Ubuntu、Red Hat Enterprise Linux 等发行版特定版本以及其他 Linux 环境的支持,具体取决于硬件和 ROCm 版本。.
请不要仅仅因为发行版的名称出现在 ROCm 文档中,就认为每个 Ubuntu、Debian、Rocky Linux 或 RHEL 版本都受到支持。.
在配置服务器之前,请记录:
- 具体的 Linux 发行版和版本。.
- 已安装的内核版本。.
- AMDGPU 驱动程序的版本。.
- 目标 ROCm 版本。.
- 加速器模型与GPU架构。.
了解驱动程序与 ROCm 版本的兼容性
AMDGPU 内核驱动程序和 ROCm 用户空间组件虽然相关,但各自采用独立的版本管理。.
某些组合在不同版本之间具有受支持的兼容性,但具体的可接受范围必须在 AMD 发布的驱动程序兼容性文档中予以确认。.
如果安装较新的 ROCm 运行时而未检查主机驱动程序,可能会导致初始化错误或出现不受支持的配置。.
有用的 Linux 检查命令
cat /etc/os-release
uname -r
lspci | grep -i amd
ls -l /dev/kfd /dev/dri
这些命令有助于识别操作系统、内核、已检测到的硬件以及相关的 GPU 设备节点。但它们并不能单独证明完整的 ROCm 堆栈正在正常运行。.
基于 AMD ROCm GPU 服务器托管与 PyTorch
在 AMD ROCm GPU 服务器托管中,一个最重要的问题是:PyTorch 能否在所选的 AMD GPU 上成功执行预期的负载。.
PyTorch 支持针对兼容的硬件和软件环境构建 ROCm 版本。.
不过,普通的仅使用 CPU 的安装,或者针对其他加速平台构建的版本,可能无法访问 AMD GPU。.

安装兼容的 PyTorch 构建版本
请按照 PyTorch 的官方安装说明操作,或使用与所选 ROCm 版本对应的、受 AMD 支持的容器。.
请不要认为一般的 pip 安装会自动安装正确的、支持 ROCm 的构建版本。.
随着 ROCm 和 PyTorch 版本的更新,具体的安装命令可能会发生变化。请先选择受支持的组合,然后按照其发布的说明进行操作。.
在 PyTorch 中验证 GPU 访问权限
安装完成后,运行一个基本的 Python 测试:
import torch

print("PyTorch:", torch.__version__)
print("ROCm/HIP:", torch.version.hip)
print("GPU 可用:", torch.cuda.is_available())

if torch.cuda.is_available():
    print("GPU:", torch.cuda.get_device_name(0))
    x = torch.randn(1024, 1024, device="cuda")
    y = torch.matmul(x, x)
    print("结果:", y.shape)
PyTorch 使用 torch.cuda 支持的 ROCm 后端以及 CUDA 的接口。在支持 ROCm 的 PyTorch 中看到此接口是正常的,并不意味着该应用程序一定是在 NVIDIA GPU 上运行的。.
测试成功时,应显示 ROCm/HIP 版本,检测到 GPU,并能无错误地完成矩阵乘法运算。.
即便如此,要达到生产就绪状态,仍需对实际模型和应用程序库进行测试。.
为什么 PyTorch 能检测到 GPU,但应用程序仍然无法运行
基本的 GPU 检测只能确认环境的一部分。.
应用程序故障可能由以下原因导致:未受支持的自定义内核、不兼容的编译扩展、缺少优化的库,或者错误地认为某些操作是 CUDA 特有的。.
因此,团队应验证完整的训练或推理管道,而不是在设备检测测试成功后就停止验证。.
ROCm GPU 服务器的 Docker 和容器部署
容器可以简化依赖项管理,并提高人工智能部署的可重复性。.
不过,ROCm 容器仍然依赖于兼容的主机硬件、驱动程序和设备访问权限。.
集装箱要求
典型的 Linux ROCm 容器部署需要访问相关的 GPU 设备节点,包括:
/dev/kfd用于计算访问。./dev/dri用于 GPU 设备接口。.
容器权限和安全策略还必须允许执行所需的 GPU 操作。.
Docker 配置示例
docker run --rm -it \
  --device=/dev/kfd \
  --device=/dev/dri \
  --group-add video \
  --group-add render \
这是一条示例命令,并非完整的生产环境部署。请将镜像占位符替换为合适的官方镜像,并验证设备权限、组映射、驱动程序兼容性以及安全要求。组名称和 ID 在不同系统中可能有所不同。.
仅靠引入更新的 ROCm 库,容器无法解决不支持的 GPU 架构或不兼容的主机驱动程序的问题。.
生产环境中的容器化实践
- 将容器图像固定到已测试的版本上。.
- 仅使用设备所需的最低权限。.
- 确保应用程序的依赖关系可重现。.
- 在容器更新后验证 GPU 访问权限。.
- 监控内存使用情况和应用程序故障。.
- 在生产环境升级前,请测试回滚流程。.
GPU 服务器上常见的 ROCm 和 PyTorch 错误
兼容性问题是导致 AMD GPU 托管部署延迟的主要原因之一。.
| 问题 | 可能的原因 | 推荐检查 |
|---|---|---|
| PyTorch 无法找到 GPU | 仅CPU构建、驱动程序问题或设备访问缺失 | 检查 PyTorch 构建、ROCm 和设备节点 |
| 不支持的 GPU 架构 | 框架或内核不支持该目标平台 | 检查 GPU 目标和支持的版本 |
| ROCm 初始化失败 | 驱动程序/运行时不匹配或权限问题 | 检查主机驱动程序与 ROCm 的兼容性 |
| 容器在某台服务器上可以运行,但在另一台服务器上却无法运行 | 不同的 GPU、驱动程序或主机配置 | 比较完整的环境版本 |
| 模型加载成功,但推理失败 | 不支持的操作或扩展 | 测试框架内核和模型依赖关系 |
| 内存不足错误 | 模型或运行时占用的显存超过了可用显存 | 检查模型大小、精度和内存使用情况 |
| 吞吐量出乎意料地低 | 未优化的内核或系统瓶颈 | 分析整个应用程序 |
使用 ROCm 工具检查 GPU
根据已安装的 ROCm 环境,有用的工具可能包括:
rocminfo
amd-smi list
amd-smi monitor
工具的可用性和命令语法可能会因软件版本而异。请查阅已安装版本的文档。.
如果操作系统检测到了 GPU,但 ROCm 工具无法访问它,请在修改应用程序代码之前,先检查驱动程序支持情况、权限以及所选的 ROCm 版本。.
用于大型语言模型(LLM)推理和微调的ROCm
当所需的框架、库和加速器架构得到支持时,AMD GPU服务器可用于语言模型的推理和训练。.
LLM 推理
生产推理需要比模型权重所需的GPU内存容量还要大。.
应用程序还需要运行时内存来支持注意力缓存、批处理、临时缓冲区以及并发请求。.
应针对具体的运行引擎和模型架构检查 ROCm 的兼容性。支持 PyTorch 并不自动保证所有推理优化功能均可使用。.
我们的 AI推理服务器托管指南 涵盖了内存、延迟、吞吐量和成本方面的考虑因素。.
LoRA 和 QLoRA 的微调
与全参数训练相比,参数高效的微调方法可以降低部分训练内存需求。.
然而,完整的软件栈必须支持所选的量化方法、优化器以及训练库。.
某些工作流依赖于某些扩展,而这些扩展在 ROCm 和 CUDA 环境中的 GPU 支持情况有所不同。.
如需了解实用的内存规划,请阅读我们的 LLM 微调 GPU 配置指南.
框架支持与模型支持并不相同
在评估 AMD GPU 基础设施时,应区分以下几点:
- 对物理GPU的官方支持。.
- 与 ROCm 版本的兼容性。.
- 在已安装的 PyTorch 构建版本中提供支持。.
- 与推理或训练框架的兼容性。.
- 该特定模型是否提供优化内核。.
每一层都会影响部署的成功与否以及实际性能。.
云端与专用 AMD ROCm GPU 服务器托管对比
只要所选产品提供兼容的硬件和软件支持,云端 GPU 基础设施和专用 GPU 服务器均可支持基于 AMD 的 AI 工作负载。.
| 因子 | 云端 GPU 托管 | 专用GPU托管 |
|---|---|---|
| 配置 | 可能提供灵活的部署方案 | 通常,相关条款会定义硬件 |
| 驾驶员控制 | 取决于服务提供商和实例类型 | 通常在主机层面上具有更大的控制权 |
| GPU访问 | 因虚拟化和分配方式而异 | 已定义的物理资源,受相关条款约束 |
| ROCm 环境 | 可以使用预定义的图像或容器 | 可能允许自定义安装 |
| 账单 | 通常基于使用情况 | 通常为定期或基于合同的 |
| 最合适的入门搭配 | 实验与需求波动 | 稳定的工作负载和定制化环境 |
最关键的问题在于,托管环境能否为客户提供部署和维护受支持的 ROCm 堆栈所需的访问权限。.
对于正在比较基础设施模型的初创企业,请参阅我们的 AI初创企业:云端与专用GPU服务器的对比分析.
AMD ROCm GPU 托管服务提供商:比较要点
在评估 AMD ROCm GPU 服务器托管服务时,应根据工作负载的具体硬件和软件要求来选择服务商,而不是仅凭服务商对 GPU 托管服务的笼统宣传。.
以下提供商代表了待研究的不同基础设施模型。将其列入此列表并不意味着当前已有特定的 AMD Instinct 模型或支持 ROCm 的镜像可用。.
Cherry Servers:专用基础设施评估
Cherry 服务器 对于正在考虑部署专用 GPU 基础设施并希望对服务器配置拥有更大控制权的组织而言,这一点尤为重要。.
请确认所需的 AMD 加速器是否可用,以及操作系统、驱动程序安装和管理员权限是否符合该应用程序的要求。.
RunPod:云端 GPU 开发环境
RunPod 这对正在评估灵活的 GPU 云环境和基于容器的 AI 工作流的开发人员具有参考价值。.
在选择部署方案之前,请确认具体的 AMD GPU 型号、当前可用性、ROCm 兼容性以及支持的软件镜像。云端 GPU 的普遍可用性并不意味着 AMD 硬件的可用性。.
GPU Mart:GPU 服务器配置要求
GPU Mart 可作为满足GPU导向型服务器托管需求的选择。.
请确认具体的 AMD 加速器型号、Linux 发行版、驱动程序支持情况,以及客户是否能够管理必要的 ROCm 软件组件。.
Vast.ai:市场平台 GPU 基础设施
Vast.ai 提供基于市场平台的 GPU 计算服务,其中各硬件列表和主机环境可能有所不同。.
对于 ROCm 工作负载,请确认确实存在合适的 AMD GPU 列表,并且主机环境提供了所需的驱动程序和设备访问权限。.
重要提示: 在服务提供商确认物理加速器、兼容的操作系统、驱动程序环境以及所需的管理或容器访问权限之前,请勿为 ROCm 工作负载购买 GPU 服务器。.
AMD ROCm GPU 服务器托管成本及隐藏要求
AMD ROCm GPU 服务器托管的总费用不仅包括广告中标明的租赁价格。.
兼容性问题、部署延迟、不受支持的库以及效率低下的内核,都会增加完成人工智能工作负载的实际成本。.
需要考虑的成本因素
- GPU 计算租用费或服务器月费。.
- 持久化存储和数据集传输。.
- 操作系统与软件管理。.
- 框架兼容性测试。.
- 模型优化和工程设计时间。.
- 监控、恢复和运营支持。.
- GPU利用率和应用实际吞吐量。.
计算每个已完成工作负载的成本
每个完成的工作负载的成本 = 总归属基础设施和运营成本 / 成功完成的工作负载数量
对于大型语言模型(LLM)的推理,这可以表示为在既定的延迟和质量目标下,每百万个输出令牌的成本。.

在训练过程中,各团队可以比较完成一次可重复训练所需的总成本。.
如果兼容性问题或应用程序吞吐量降低导致总执行时间增加,那么较低的每小时GPU租赁价格并不一定更好。.
AMD ROCm 服务器生产环境部署检查清单
- 确认 GPU 型号: 确定具体的 AMD Instinct 或受支持的 Radeon 加速器。.
- 验证 GPU 目标: 请对照 ROCm 支持文档核对架构标识符。.
- 请选择支持的操作系统: 与确切的发行和发布版本完全一致。.
- 检查 AMDGPU 驱动程序: 请确认与所选 ROCm 软件栈的兼容性。.
- 请选择一个受支持的 ROCm 版本: 避免随意组合版本。.
- 安装一个匹配的 PyTorch 构建版本: 请按照官方说明操作,或使用兼容的容器。.
- 验证 GPU 访问权限: 测试设备可见性并执行一项基本的GPU操作。.
- 验证应用程序库: 检查推理引擎、自定义内核和扩展。.
- 对实际工作负载进行基准测试: 测量吞吐量、延迟、内存使用情况和错误。.
- 审查安全与运营情况: 固定版本、限制设备权限并测试回滚流程。.
常见问题解答
什么是 AMD ROCm GPU 服务器托管?
AMD ROCm GPU 服务器托管服务可提供受支持的 AMD GPU 硬件,用户可在该环境中部署兼容的驱动程序、ROCm 组件和 AI 框架,以实现加速计算。.
PyTorch 能否与 AMD ROCm 配合使用?
是的。PyTorch 支持针对兼容的 AMD 硬件和软件环境构建的 ROCm 版本。具体的 GPU、ROCm 版本、PyTorch 构建版本和操作系统必须在支持范围内。.
为什么 PyTorch 在 AMD GPU 上使用 torch.cuda?
对于支持 ROCm 的构建,PyTorch 采用其成熟的 CUDA 风格设备接口。应用程序在受支持的 AMD GPU 上运行时,可以使用 torch.cuda 函数。.
所有的AMD显卡都支持ROCm吗?
不。官方支持取决于 GPU 型号、架构、ROCm 版本以及操作系统。请务必参考 AMD 的兼容性列表。.
ROCm 能在 Docker 中运行吗?
是的,在支持的 Linux 环境中,只要主机驱动程序、设备访问、权限和容器镜像兼容,即可实现。容器并不能消除主机层面的兼容性要求。.
AMD ROCm 适合用于 LLM 推理吗?
ROCm 可在受支持的 AMD 加速器上支持兼容的大型语言模型(LLM)推理工作负载。性能和应用程序兼容性取决于服务引擎、模型、内核以及软件版本。.
我可以使用 ROCm 进行 LoRA 和 QLoRA 的微调吗?
某些 LoRA 和 QLoRA 工作流可在受支持的 ROCm 环境中运行。不过,量化库、优化器以及自定义扩展必须逐一进行验证。.
AMD Instinct 服务器是否总是比 NVIDIA GPU 服务器更便宜?
不。租赁价格、工作负载表现、软件兼容性、工程时间以及利用率共同决定了总体价值。请根据等效的应用程序需求,比较每项完成任务的成本。.
我应该选择云端还是独立的AMD GPU主机?
云基础设施可能适合用于实验和需求波动较大的场景。对于持续性工作负载或定制化软件环境,专用服务器可能更具吸引力。应首先核实所需的 ROCm 访问权限和兼容性。.
最终结论:AMD ROCm GPU 服务器托管
AMD ROCm GPU 服务器托管 当完整的软件环境兼容时,它可以成为人工智能推理、模型开发和GPU加速计算的宝贵基础设施选项。.
最重要的决定不仅仅在于哪款 AMD 加速器提供最大的 GPU 内存或计算性能。购买者必须确认硬件支持、操作系统兼容性、AMDGPU 驱动程序要求、ROCm 版本、PyTorch 集成以及应用层功能。.
Cherry Servers、RunPod、, GPU Mart, 以及 Vast.ai 提供了值得探索的不同基础设施选项,但必须针对每款具体产品确认当前 AMD GPU 的供应情况以及 ROCm 的就绪状态。.
在确定采用某项托管方案之前,请先在目标 GPU 和软件堆栈上测试实际工作负载。经过验证且可重现的部署方案,比那些看似前景光明却无法支持所需应用程序的硬件规格更有价值。.
AMD GPU → 支持的操作系统 → AMDGPU 驱动程序 → ROCm → PyTorch → 应用程序验证 → 每项工作负载的成本
最佳的 AMD GPU 服务器,应能可靠地运行您的 AI 应用程序,提供所需的性能,并带来可持续的基础设施总体价值。.