人工智能基础设施已不再局限于单一的GPU生态系统。AMD通过Instinct系列扩展了其数据中心加速器产品组合,为企业和研究人员、云平台以及AI开发者提供了在机器学习、大型语言模型、高性能计算和AI推理领域的另一种选择。.
该 最佳 AMD GPU 服务器 将功能强大的 AMD Instinct 加速器与充足的系统内存、高速存储、高带宽网络以及针对高要求 AI 和 HPC 工作负载的软件支持相结合。.
AMD Instinct MI300X 在生成式人工智能和大型语言模型工作负载方面备受瞩目,而其他 Instinct 加速器在高性能计算(HPC)、机器学习以及成熟的 GPU 计算环境中依然发挥着重要作用。.
本指南对比了主要的 AMD Instinct 服务器选项,介绍了 ROCm 软件生态系统,并帮助您判断何时应选择 AMD GPU 服务器 这对您的 AI 基础设施来说是合理的。.
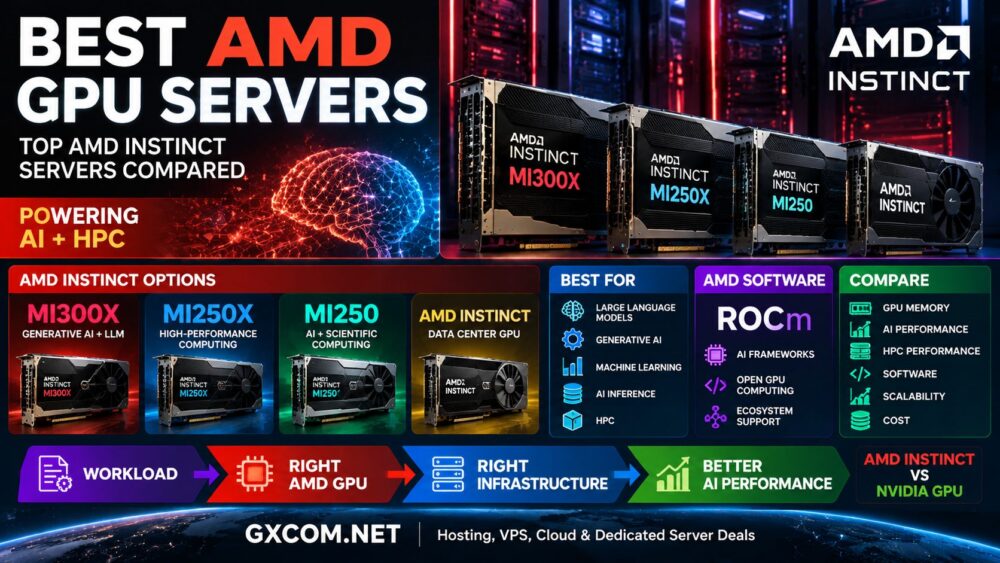
AMD GPU 服务器精选一览
| AMD 显卡 | 最适合 | 职位 | 典型工作负载 |
|---|---|---|---|
| Instinct MI300X | 生成式人工智能和大型语言模型 | 高端人工智能 | LLM推理、AI训练、生成式AI |
| Instinct MI250X | HPC | 高性能 | 科学计算、研究、高性能计算 |
| Instinct MI250 | 人工智能与高性能计算 | 高性能 | 机器学习、仿真、计算 |
| 之前的 Instinct GPU | 预算 / 现有工作量 | 变量 | 研究、开发、专用计算 |
什么是 AMD GPU 服务器?
AMD GPU服务器是指配备一个或多个AMD图形或计算加速器的服务器。在数据中心和人工智能市场中,最重要的产品系列是AMD Instinct。.
这些加速器专为能够从大规模并行处理中获益的工作负载而设计,包括:
- 人工智能
- 机器学习
- 大型语言模型
- 生成式人工智能
- AI推理
- 高性能计算
- 科学模拟
- 数据分析
对于人工智能采购方而言,硬件只是其中的一部分。软件兼容性、框架支持、内存容量、互连技术、存储、网络以及供应商的专业能力,其重要性可能与GPU的原始性能不相上下。.
AMD Instinct MI300X 服务器
AMD Instinct MI300X 是 AMD 面向现代人工智能基础设施最重要的加速器之一。它专为内存密集型人工智能工作负载而设计,特别适用于大型语言模型和生成式人工智能。.
MI300X 服务器适用于:
- 大型语言模型
- 生成式人工智能
- AI推理
- 机器学习
- 企业级人工智能平台
- 内存密集型人工智能工作负载
在大规模模型计算中,GPU内存是一个重要考量因素。AI模型可能需要大量的加速器内存,而增加内存容量有助于减少将工作负载分散到更多设备上的需求。.
这使得在评估大型AI模型的基础设施时,MI300X显得尤为引人注目,而不仅仅是在比较GPU的理论性能。.
AMD Instinct MI250X 服务器
AMD Instinct MI250X 与高性能计算和科学计算工作负载有着密切的关联。.
这可能适用于:
- 科学研究
- 模拟
- HPC 集群
- 工程工作负载
- 大规模数据处理
对于已建立 MI250X 环境的组织而言,即使新一代 Instinct 产品陆续上市,这些系统仍可能继续发挥作用。.
AMD Instinct MI250 服务器
MI250 是 Instinct 加速器系列的又一成员,专为计算密集型数据中心工作负载而设计。.
其潜在应用领域包括机器学习、高性能计算(HPC)、科研以及基于GPU的加速计算。.
在评估上一代 AMD GPU 基础设施时,价格和供货情况显得尤为重要。当工作负载对架构的要求不高时,较旧的加速器有时能提供更优的整体性价比。.
AMD Instinct MI300X 与 MI250X 对比
| 功能 | MI300X | MI250X |
|---|---|---|
| 主要重点 | 人工智能 / 生成式人工智能 | 高性能计算 / 科学计算 |
| LLM 工作负载 | 完美贴合 | 取决于工作量 |
| AI推理 | 强 | 有能力 |
| HPC | 强 | 强 |
| 世代 | 较新的 | 上一代 |
因此,选择时应基于工作负载,而不是单纯选择最新的GPU。.
什么是 AMD ROCm?
ROCm 是 AMD 面向 GPU 计算的开源软件平台,也是 AMD AI 服务器生态系统的重要组成部分。.
它提供了工具、库、编译器以及框架集成,使开发人员能够利用 AMD GPU 进行加速计算。.
对于人工智能项目,在选择硬件之前应先检查软件兼容性。需要考虑的重要因素包括:
- 操作系统支持
- ROCm 版本
- AI 框架兼容性
- 模型要求
- 容器支持
- 必需的库
在迁移最初基于 NVIDIA CUDA 开发的工作负载时,这一点尤为重要。.
AMD GPU服务器与NVIDIA GPU服务器对比
在人工智能基础设施市场中,AMD和NVIDIA的定位各不相同。NVIDIA拥有成熟的CUDA生态系统并得到了广泛应用,而AMD Instinct则为人工智能和高性能计算(HPC)工作负载提供了日益重要的替代方案。.
| 因子 | AMD Instinct | NVIDIA 图形处理器 |
|---|---|---|
| 软件平台 | ROCm | CUDA |
| 人工智能基础设施 | 成长 | 非常广泛 |
| HPC | 强 | 强 |
| LLM 选项 | MI300X 及更新版本的 Instinct 平台 | H100 及其他 AI 加速器 |
| 服务提供商可用性 | 更有限 | 更广泛地普及 |
如果您也在评估 NVIDIA 基础设施,请参阅我们的
最佳 NVIDIA GPU 服务器
指南。.
AMD MI300X 与 NVIDIA H100 对比
在关于企业级人工智能基础设施的讨论中,MI300X 和 H100 经常被提及,因为这两款产品都面向要求严苛的人工智能工作负载。.
然而,在二者之间做出选择不应仅以单一基准为依据。.
比较:
- 模型要求
- GPU 内存要求
- 训练与推理
- 框架兼容性
- ROCm 与 CUDA 的依赖关系
- 多GPU扩展
- 服务提供商可用性
- 基础设施总成本
对于采用依赖 CUDA 的软件栈的组织而言,NVIDIA 的兼容性可能更具价值;而对于已通过 ROCm 验证的工作负载,AMD Instinct 基础设施则更具吸引力。.
适用于大型语言模型的 AMD GPU 服务器
大型语言模型(LLM)需要的不仅仅是原始计算性能。GPU内存是最重要的因素之一,因为大型模型、上下文窗口、批量大小以及推理配置都会消耗大量加速器内存。.
生产环境中的大型语言模型(LLM)还可能需要:
- 多张GPU
- 大容量系统内存
- 高速 NVMe 存储
- 高速网络
- 高效的模型部署软件
MI300X 对于这一市场尤为重要,因为 AMD 将其定位于生成式人工智能和大型模型工作负载。.
用于人工智能推理的 AMD GPU 服务器
推理可能是 AMD GPU 基础设施的一个极具吸引力的应用场景,因为生产环境中的应用程序通常更重视内存容量、吞吐量、效率和总成本,而非最大的训练性能。.
常见应用包括:
- AI聊天服务
- LLM API
- 企业助理
- 内容生成
- 计算机视觉
- 人工智能自动化
各组织应针对其实际模型进行基准测试,因为人工智能的性能会因框架、精度、优化和软件配置的不同而存在显著差异。.
适用于高性能计算(HPC)的 AMD GPU 服务器
AMD Instinct 在高性能计算领域占据着重要地位。.
HPC 工作负载可能包括:
- 天气建模
- 科学模拟
- 计算研究
- 工程
- 物理学
- 大规模数值计算
对于此类环境,在评估GPU选型时,应综合考虑CPU架构、内存带宽、网络、存储以及集群设计等因素。.
在哪里可以租用 AMD GPU 服务器?
AMD GPU托管服务通常不如NVIDIA GPU托管服务普及,因此在选择平台之前,应直接向服务提供商核实其可用性。.
AMD Instinct 基础设施可通过主要云平台、专业 AI 基础设施提供商、数据中心运营商以及专用服务器公司获得。.
在比较服务提供商时,请关注以下几点:
- 确切的 AMD Instinct 型号
- GPU 数量
- GPU内存
- ROCm 环境
- 存储性能
- 网络配置
- 按小时或按月计费
- 技术支持
如需了解租赁模式的更详细说明,请参阅我们的
GPU服务器租赁
指南。.
AMD GPU 服务器的成本
AMD GPU服务器的定价在很大程度上取决于加速器、GPU数量、服务器架构、计费模式以及配套基础设施。.
重要的成本构成包括:
- GPU加速器
- CPU 资源
- 系统内存
- NVMe 存储
- 网络流量
- 多GPU配置
- 软件与支持
- 按小时或按月付费
不要仅比较GPU的价格。一款价格较低但完成工作负载所需时间明显更长的加速器,可能会导致总计算成本更高。.
如需了解有关预算编制的更多信息,请阅读我们的
AI 服务器成本指南.
AMD GPU 服务器与 GPU 云的对比
| 功能 | 专用 AMD GPU 服务器 | AMD GPU 云 |
|---|---|---|
| 硬件访问 | 专属 | 取决于平台 |
| 部署 | 通常较慢 | 快 |
| 缩放 | 取决于硬件 | 灵活的 |
| 账单 | 通常每月一次 | 通常基于使用情况 |
| 最适合 | 连续工作负载 | 可变的工作量 |
云基础设施在进行实验时可能更为实用,而专用的 AMD GPU 服务器则可能更适合拥有稳定、持续工作负载的企业。.
如何选择最佳的AMD GPU服务器
在选择加速器之前,请先明确工作负载。.
| 工作量 | AMD GPU的发展方向 |
|---|---|
| 大型语言模型 | MI300X级基础设施 |
| 生成式人工智能 | MI300X / 更新版的 Instinct 平台 |
| AI推理 | 针对工作负载优化的 Instinct GPU |
| HPC | MI300X / MI250X(视环境而定) |
| 研究 | 基于软件需求的Instinct平台 |
购买AMD GPU服务器时常见的误区
忽略 ROCm 兼容性
请不要认为为其他 GPU 生态系统设计的软件无需修改即可运行。在部署生产环境基础设施之前,请先验证您的操作系统、框架、库、容器和应用程序。.
仅比较 GPU 性能
CPU 资源、内存、存储、网络、GPU 内存以及软件优化都会对实际性能产生显著影响。.
忽略服务提供商的可用性
AMD Instinct 服务器的供应范围不如许多 NVIDIA GPU 配置那么广泛。在围绕特定加速器设计基础设施之前,请确认硬件的可用性和部署位置。.
在定义工作负载之前选择硬件
最昂贵的GPU并不一定就是性价比最高的GPU。.
从以下内容开始:
工作负载 → 内存 → 软件 → 性能 → 成本
AMD GPU 服务器值得购买吗?
对于那些人工智能或高性能计算(HPC)工作负载与 ROCm 生态系统兼容的企业而言,AMD GPU 服务器可能是一个极具吸引力的选择。.
MI300X 特别适用于大型语言模型、生成式人工智能和内存密集型工作负载,而其他 Instinct 加速器在高性能计算(HPC)、研究以及成熟的计算环境中依然大有可为。.
不过,NVIDIA 的供应商覆盖范围更广,且拥有成熟的 CUDA 生态系统,因此软件兼容性仍应是决策的核心考量因素。.
结语
最佳的AMD GPU服务器应该是能够匹配工作负载的那款,而不是仅仅提供最新的加速器。.
AMD Instinct MI300X 是现代人工智能和大型模型基础设施的重要选择,而 MI250 系列系统则继续满足高要求的 HPC 和科学计算工作负载的需求。.
在选择 AMD GPU 服务器之前,请评估 GPU 内存、ROCm 兼容性、框架支持、供应商可用性、网络、存储、可扩展性以及总计算成本。.
随着人工智能基础设施领域的竞争日益激烈,AMD Instinct 为企业提供了一条超越单一 GPU 生态系统、构建高性能人工智能系统的另一条途径。.