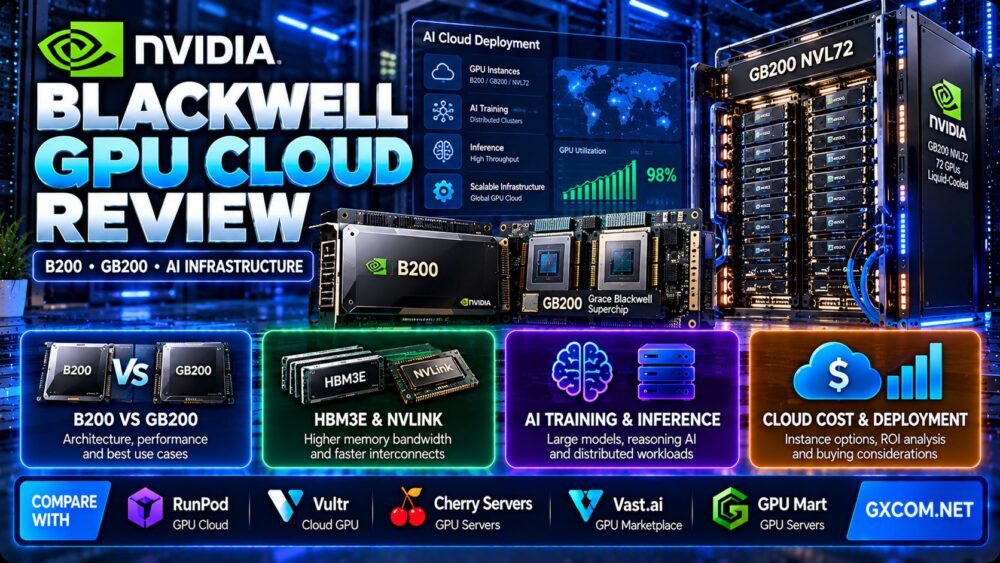
这个 NVIDIA Blackwell GPU 云服务评测 从人工智能基础设施采购的角度,对 B200、GB200 Grace Blackwell Superchip 以及 GB200 NVL72 进行了分析。对于部署大型语言模型、推理系统、生成式人工智能应用以及分布式训练集群的组织而言,选择 Blackwell 云基础设施不仅需要比较理论上的 GPU 性能。.
真正的采购考量涉及GPU内存、互连拓扑、CPU架构、软件兼容性、云端可用性、网络、工作负载利用率,以及完成有价值的AI工作的总成本。.
Blackwell 标志着 NVIDIA 数据中心架构的一次重大飞跃,但单个 B200 GPU 实例、基于 GB200 的节点以及机架级 GB200 NVL72 部署在根本上是截然不同的产品。.
在本篇评测中,我们将阐明这些差异,探讨人工智能的训练和推理需求,比较部署模型,并概述如何评估 GPU 基础设施提供商,包括 RunPod, Vultr, Cherry 服务器, Vast.ai, ,以及 GPU Mart.
编辑方法:本文参考了已发布的 NVIDIA 架构文档和云基础设施采购原则。GXCOM.NET 并未对 B200 或 GB200 系统进行独立基准测试,也未测试服务商的运行时间,或核实实时 GPU 库存情况。归因于 NVIDIA 的性能声明不应被视为经独立验证的结果。.
NVIDIA Blackwell GPU 云服务评测:简评
对于那些能够从高内存带宽、先进的低精度计算以及高速 GPU 互连中获益的高要求 AI 工作负载,NVIDIA Blackwell 云基础设施值得评估。.
基于 B200 的云实例可能适合那些需要强大 GPU 计算能力但又无需购买物理硬件的组织。GB200 系统采用了高度集成的 Grace CPU 和 Blackwell GPU 架构,而 GB200 NVL72 则面向需要大量 GPU 间通信的大规模 AI 系统。.
然而,对于较小型号、使用频率较低的应用,或者无法从其架构中获益的工作负载而言,Blackwell 并不一定就是最经济的选择。.
| 评估领域 | 布莱克韦尔云评估 |
|---|---|
| GPU架构 | NVIDIA Blackwell |
| 主要产品 | B200、GB200 和 GB200 NVL72 |
| 主要工作负载 | AI训练、推理、推理与高性能计算 |
| 存储技术 | 评估系统中的高带宽 HBM3E |
| 互连 | 取决于配置的 NVLink 及相关技术 |
| 部署 | GPU实例、集成系统和机架级基础设施 |
| 主要优势 | 高计算密度和先进的人工智能加速 |
| 主要局限性 | 基础设施的复杂性、可用性以及与工作负载相关的成本 |
| 购买优先权 | 在满足所需服务质量的前提下,每个完成的人工智能工作负载的成本 |
什么是 NVIDIA Blackwell GPU 云基础设施?
NVIDIA Blackwell 是一种专为加速计算而设计的 GPU 架构,涵盖 AI 训练、推理、数据处理以及高性能计算等领域。.
云服务提供商可以通过不同的服务模式提供 Blackwell 硬件,包括专用 GPU 实例、多 GPU 服务器、托管集群以及更大规模的集成式 AI 基础设施部署。.
这些服务在客户访问 GPU、管理软件、分配资源以及支付基础设施费用方面存在差异。.
标榜为 Blackwell GPU 的云实例,并不一定能提供对整个 GB200 系统或 NVL72 机架的访问权限。.
如需更全面地比较各代加速器,请参阅我们的 NVIDIA H100、H200 与 B200 对比.
NVIDIA B200 与 GB200 与 GB200 NVL72 对比
在评估 Blackwell 的云服务方案时,区分这些产品至关重要。.
NVIDIA B200 图形处理器
NVIDIA B200 是一款专为高负载数据中心工作负载设计的 Blackwell 张量核心 GPU。.
它提供了高带宽的GPU内存以及与现代AI框架相关的加速功能。.
云客户应核实 B200 的具体配置、分配的 GPU 数量、内存容量、主机 CPU、存储以及互连拓扑。.
对于能够在一块加速器上运行且无需大量多GPU通信的工作负载,租用单GPU可能是合适的选择。.
NVIDIA GB200 Grace Blackwell 超级芯片
GB200 Grace Blackwell Superchip 通过 NVIDIA 的 NVLink-C2C 技术,将一颗 NVIDIA Grace CPU 与两颗 Blackwell GPU 集成在一起。.
该架构旨在改善 CPU 与 GPU 资源之间的通信,并支持要求苛刻的加速计算工作负载。.
不过,Grace CPU 采用基于 Arm 的架构。客户应核实操作系统镜像、容器依赖项、编译后的库以及应用程序的兼容性。.
NVIDIA GB200 NVL72
GB200 NVL72 是一款液冷式机架级系统,内置 36 颗 Grace CPU 和 72 颗 Blackwell GPU。.
NVIDIA 规定,机架级配置的 HBM3E GPU 总内存约为 13.4TB,NVLink 总通信带宽为 130TB/s。.
这些是系统级规格,而非分配给单个 GPU 实例的资源。.
NVL72 专为超大规模 AI 模型和工作负载而设计,这些模型和工作负载能够从 GPU 之间的广泛通信中获益。.
Blackwell 产品对比
| 产品 | 建筑 | 典型的评估重点 |
|---|---|---|
| B200 | 单个 Blackwell GPU | 每块GPU的性能、内存及租赁配置 |
| GB200 | Grace CPU 加两块 Blackwell GPU | CPU-GPU集成与软件兼容性 |
| GB200 NVL72 | 72-GPU液冷机架级系统 | 分布式人工智能、高速互连与集群经济性 |
Blackwell GPU 内存:为何容量和带宽至关重要
GPU内存决定了AI工作负载能否在特定的加速器配置上高效运行。.
对于大型语言模型的推理,内存消耗包括模型权重、运行时开销、激活值以及键值缓存。.
更长的上下文窗口和更高的并发度可能会大幅增加内存需求。.
模型权重
模型权重所需的内存大小取决于参数个数和数值精度。.
低精度格式可以减少内存占用,但必须评估其兼容性和模型质量。.
KV缓存
Transformer 推理通常会使用键值缓存,以避免重复进行某些计算。.
缓存需求可能会随着序列长度、批量大小和模型架构的变化而增加。.
一种在低并发情况下运行良好的模型,当大量用户提交长请求时,可能会出现内存不足的情况。.
内存带宽
较高的内存带宽可以提升那些需要频繁在内存与计算单元之间传输模型数据的工作负载的性能。.
不过,实际的推理速度还取决于内核、批处理、精度以及计算利用率。.
多GPU内存
多张 GPU 不会自动像一个不受限制的内存池那样工作。.
应用程序必须使用适当的模型并行技术、通信库以及受支持的互连技术。.
在租用多块 Blackwell GPU 之前,请确认这些 GPU 之间的通信方式,以及所需的框架是否支持该拓扑结构。.
Blackwell AI 推理性能
Blackwell 引入了与现代 AI 推理相关的架构功能,包括低精度加速和高带宽通信。.
然而,理论性能并不能直接转化为应用程序的吞吐量。.
获得首个代币所需时间
对于交互式大型语言模型(LLM)应用而言,“首次令牌生成时间”衡量的是模型开始生成输出所需的时间。.
它可能会受到队列、即时处理、模型执行和网络延迟的影响。.
每秒输出令牌数
生成速度对于聊天机器人、编码助手和推理应用程序而言至关重要。.
基准测试结果应明确说明模型、精度、输入长度、输出长度、批量大小以及服务端软件。.
并发请求
生产推理服务必须能够在不产生过高延迟的情况下处理多个用户。.

更高的并发性虽然可以提高硬件利用率,但也会增加内存压力和尾部延迟。.
低精度计算
Blackwell 支持先进的低精度计算功能,包括 NVIDIA 的 NVFP4 相关加速功能。.
实际效益取决于软件支持、量化方法以及可接受的模型质量。.
客户不应认为每个模型都会自动从较低的数值精度中获益。.
推理模型
推理密集型应用生成的令牌数量可能远多于传统的短响应工作负载。.
这使得持续的推理吞吐量、内存效率以及每个生成的令牌的成本变得尤为重要。.
Blackwell 在 AI 训练和微调中的应用
Blackwell 基础设施能够支持要求苛刻的人工智能训练工作负载,但硬件的选择应遵循模型要求和分布式训练架构。.
全模型训练
大规模训练可能需要多台加速器协同工作。.
GPU 数量、内存、网络、检查点存储以及软件并行性都会影响训练效率。.
微调
对较小的模型进行微调时,可能不需要整个GB200系统。.
参数高效的方法可以降低内存和计算需求。.
在选择昂贵的基础设施之前,请对比不同代适用的GPU在实际训练时间和总成本方面的差异。.
分布式培训
分布式工作负载可能会受到通信开销的限制。.
NVLink、InfiniBand、以太网设计以及NCCL等软件库都是需要重点考虑的因素。.
当通信和同步成为工作负载的主要部分时,增加更多GPU可能带来边际效益递减。.
检查点存储
训练检查点可能规模较大,因此必须确保其编写可靠。.
存储速度慢或检查点调度设计不佳都会降低有效的训练吞吐量。.
如需了解更全面的采购考虑因素,请浏览我们的 NVIDIA GPU 服务器供应商指南.
为什么 NVLink 和网络对 GB200 至关重要
高速GPU通信是GB200系统的一项主要架构特性。.
不过,购买者应区分系统内部的GPU间通信与不同云节点之间的通信。.
系统内通信
NVLink 和 NVSwitch 支持受支持的 GPU 之间进行高带宽通信。.
当模型参数或激活值需要在设备之间传输时,这些技术尤为重要。.
节点间网络
大型集群还依赖于高性能网络架构,例如InfiniBand或设计合理的以太网网络。.
网络拥塞、延迟、拓扑结构以及整体通信性能都会影响训练吞吐量。.
云资源分配边界
租用多块 GPU 并不能保证它们属于同一个 NVLink 域。.
客户应要求提供关于 GPU 拓扑结构、互连带宽以及布局保证的明确文档。.
存储网络
数据集导入和检查点生成可能需要相当大的存储吞吐量。.
如果存储系统无法高效地提供数据,那么强大的GPU性能可能会被白白浪费。.
Blackwell 云部署模式
组织可以通过不同的服务模式访问 GPU 基础设施。.
单GPU云实例
单GPU实例可能适用于推理、开发、测试以及规模较小的训练工作负载。.
它们更容易评估,而且通常对分布式系统工程的要求较低。.
多GPU云服务器
多GPU服务器支持那些对内存或计算能力的需求超过单个GPU所能提供的工作负载。.
客户应确认 GPU 拓扑、CPU 资源、内存、本地存储和网络配置。.
托管式 GPU 集群
托管集群可以减少大规模训练和推理中的一些编排工作。.
不过,客户仍需验证工作负载的性能、调度行为、数据迁移以及成本。.
机架级 GB200 系统
GB200 NVL72 与传统的 GPU 虚拟机属于不同的采购类别。.
机架级基础设施可能涉及专用容量配置、专用制冷、网络连接以及企业采购流程。.
并非每家云服务提供商都允许客户直接访问完整的 NVL72 系统。.
Blackwell GPU 云服务的可用性:买家应核实哪些内容?
NVIDIA 宣布,基于 GB200 NVL72 的实例将于 2025 年 2 月通过 CoreWeave 正式在云端全面上线。.
然而,不同提供商、不同区域以及不同服务模式之间的云可用性并不一致。.
客户应核实所提供的具体硬件和配置,而不是认为所有标有“Blackwell”的产品都是一样的。.
GPU 型号
请确认该服务是否提供基于 B200、GB200 的基础设施,还是其他 Blackwell 系列加速器。.
GPU 分配
请确认该方案包含的是完整的物理 GPU、多块 GPU 还是分区资源。.
地理区域
不同地区之间的GPU库存量可能存在显著差异。.
地理位置还会影响网络延迟、数据驻留以及应用程序架构。.
容量预留
大型训练任务可能需要在较长时间内保证对多块GPU的访问权限。.
请确认预订条款,以及若名额已满时将如何处理。.
软件环境
验证驱动程序版本、CUDA 兼容性、容器镜像、框架支持以及 CPU 架构。.
Blackwell GPU 云服务成本:超越按小时计费
Blackwell 基础设施可能涉及高昂的运营成本,尤其是在需要多台加速器及高性能网络的情况下。.
然而,最低的小时租金并不一定意味着每完成一项工作任务的成本最低。.
计算费用
GPU 的计费可能取决于已分配的设备、租赁时长、预订条款以及服务类型。.
应比较等效的资源分配情况,而不是仅凭产品名称来判断。.
闲置产能
根据计费条款,专用 GPU 实例在空闲时仍可能产生费用。.
组织应监控资源利用率,并在工作负载准备就绪之前避免分配昂贵的资源。.
存储
大型数据集、模型检查点和推理生成文件可能需要大量存储空间。.
审查持久存储、临时存储、快照和备份策略。.
人际网络
数据传输费用和网络性能可能会对总成本产生重大影响。.
对于分布式训练而言,通信效率低下也会增加计费的 GPU 时间。.
软件与运营
包括部署工程、监控、编排、安全、故障排除和恢复流程。.
总成本计算公式
AI 工作负载总成本 = GPU 计算 + 存储 + 数据传输 + 预留容量 + 运维服务 + 恢复开销 + 适用税费。.
然后计算:
每个已完成工作负载的成本 = 总归属成本 / 成功完成的工作负载数量。.
用于推理:
每百万输出代币的成本 = 应计推断成本总额 / 成功生成的输出代币数量 × 1,000,000。.
在比较服务系统时,应分别报告输入令牌、输出令牌、延迟目标和批处理行为。.
B200 与 H200:何时值得升级?
从Hopper架构的GPU升级到Blackwell架构,可能会提升兼容工作负载的性能,但这一决定应基于实际测试结果。.
较新的 GPU 可能提供更高的吞吐量或更强的内存性能,但租赁成本也会有所不同。.
当性能提升、运营效益或内存需求所带来的收益超过额外支出时,此次升级在经济上就是合理的。.
比较等效工作量
在可能的情况下,请使用相同的模型、数值精度、批量大小、输入长度、输出长度以及框架配置。.
测量实际吞吐量
按每秒令牌数、已完成的训练步骤或成功的推理请求进行评估。.
查看软件支持
旧版本的框架可能无法充分利用新版加速器的功能。.
计算实际成本
比较在满足所需质量和延迟要求的情况下,完成相同工作负载所需的总成本。.
如果完成任务所需的时间明显更长,那么每小时费用较低的 GPU 反而可能更贵。.
RunPod 与 Vultr 与 Cherry Servers 与 Vast.ai 与 GPU Mart 对比
在评估 Blackwell 的云部署策略时,有几家 GPU 基础设施提供商值得关注。.
不过,以下比较仅涉及各家运营商的一般服务模式。这并不意味着目前每家运营商都提供 B200 或 GB200 的带宽。.
| 服务提供商 | 基础设施方法 | 购买注意事项 |
|---|---|---|
| RunPod | GPU 云实例和无服务器服务 | GPU部署的灵活性与AI工作流 |
| Vultr | 云GPU基础设施 | 云实例、区域和基础设施管理 |
| Cherry 服务器 | 专用和云基础设施 | 物理硬件的分配与定制 |
| Vast.ai | GPU 市场 | 单台设备的可用性与主机的可靠性 |
| GPU Mart | GPU服务器托管 | 固定的硬件配置和服务器控制 |
RunPod
RunPod 为人工智能工作负载提供 GPU 云和无服务器基础设施。.
这对于正在评估模型部署、推理端点和可配置 GPU 环境的开发者而言可能具有参考价值。.
有关无服务器部署的注意事项,请阅读我们的 RunPod 无服务器 GPU 评测.
Vultr
Vultr 提供用于人工智能和加速计算的云 GPU 基础设施。.
购买者应比较支持的显卡型号、各地区的库存情况、网络配置以及软件要求。.
请参阅我们的 Vultr 云 GPU 评测 出于更广泛的基础设施方面的考虑。.
Cherry 服务器
Cherry Servers 提供专用基础设施以及精选的具备 GPU 功能的服务器产品。.
这可能对那些优先考虑专用硬件控制和定制化服务器配置的组织具有参考价值。.
客户应核实具体加速器的库存情况,而不是一概认为所有Blackwell产品都有货。.
Vast.ai
Vast.ai 提供了一个 GPU 交易平台,该平台上的各项服务在硬件配置、价格、可靠性和租赁条件等方面可能各不相同。.
这可能适合具备技术能力的团队,它们能够评估具体的GPU方案,并能适应基础设施的差异。.
GPU Mart
GPU Mart 提供 GPU 服务器产品和托管方案。.
这可能对寻求传统GPU服务器租赁方案的客户具有参考价值。.
Verify GPU model, memory, system resources, network characteristics, and current availability before comparing with Blackwell cloud offers.
Blackwell Cloud Security and Operational Requirements
AI infrastructure procurement should include security, reliability, and data governance considerations.
Data Protection
Verify where datasets and model artifacts are stored and processed.
Organizations handling sensitive data should review contractual and technical controls.
Access Management
Use appropriate identity controls, least-privilege permissions, and credential management.
Checkpoint and Recovery Strategy
Large training jobs should have reliable checkpoint procedures and independent storage.
监测
Track GPU utilization, memory usage, network throughput, errors, job completion rates, and total spending.
Availability Planning
Production systems should account for infrastructure maintenance, hardware faults, and regional service disruptions.
Who Should Choose NVIDIA Blackwell GPU Cloud?
优秀的候选人
- Organizations deploying large language models.
- AI teams operating reasoning-intensive inference systems.
- Researchers training or fine-tuning demanding models.
- Businesses requiring high-memory GPU configurations.
- Infrastructure teams building multi-GPU AI services.
- Organizations evaluating high-throughput production inference.
哪些人应该考虑其他选择?
- Developers running small models that fit on lower-cost GPUs.
- Teams with low and unpredictable utilization.
- Applications without software support for Blackwell features.
- Organizations without the engineering resources to manage complex GPU clusters.
- Workloads where storage or network performance is the primary bottleneck.
NVIDIA Blackwell GPU Cloud Pros and Cons
优点
- Advanced GPU architecture for modern AI workloads.
- High-bandwidth GPU memory.
- Low-precision acceleration capabilities.
- Strong potential for demanding AI inference.
- High-speed interconnect options in integrated systems.
- Architecture suitable for large-scale distributed AI.
- Multiple cloud deployment models.
限制
- Higher infrastructure complexity for large deployments.
- Cloud availability varies by provider and region.
- Software compatibility must be verified.
- GB200 introduces Arm CPU considerations.
- Large clusters require specialized networking and orchestration.
- Actual performance depends on model and software configuration.
- High hourly costs can become inefficient under low utilization.
- Published benchmark claims may not represent customer workloads.
Blackwell GPU Cloud Buying Checklist
- Define the AI workload and target model.
- 计算所需的GPU内存。.
- Determine whether B200, GB200 or rack-scale infrastructure is necessary.
- Check CUDA, framework and container compatibility.
- Confirm CPU architecture requirements.
- Verify actual GPU allocation and interconnect topology.
- Review available regions and inventory.
- Evaluate storage and checkpoint requirements.
- Confirm network bandwidth and data transfer policies.
- Measure realistic training or inference throughput.
- Test latency under expected concurrency.
- Review capacity reservation and cancellation terms.
- 计算总工作量成本。.
- Compare with suitable Hopper-generation alternatives.
- Plan security, monitoring and recovery.
常见问题解答
What is NVIDIA Blackwell GPU cloud?
It refers to cloud infrastructure built on NVIDIA Blackwell-family accelerators, offered through GPU instances, integrated systems, managed clusters or larger AI infrastructure deployments.

What is the difference between B200 and GB200?
B200 is a Blackwell GPU. GB200 Grace Blackwell Superchip integrates one Grace CPU and two Blackwell GPUs through a high-speed CPU-GPU interconnect.
What is GB200 NVL72?
GB200 NVL72 is a liquid-cooled rack-scale system containing 36 Grace CPUs and 72 Blackwell GPUs connected through high-speed NVLink infrastructure.
Is GB200 faster than B200?
They are not directly equivalent products. GB200 combines CPUs and GPUs in an integrated architecture, while NVL72 is a much larger system. Performance comparisons require matching workloads and allocated resources.
Is Blackwell good for AI inference?
Blackwell is designed for demanding AI inference workloads, but actual performance depends on model architecture, precision, software, memory requirements and deployment configuration.
Can I rent a single B200 GPU?
Availability depends on the cloud provider, region and current inventory. Confirm whether the advertised service provides a full B200 GPU or another allocation model.
Does GB200 use an Arm CPU?
Yes. The Grace CPU in GB200 is Arm-based, so software compatibility should be checked before deployment.
Is Blackwell cheaper than H200?
Not universally. Compare actual rental terms and the cost of completing equivalent workloads rather than assuming newer hardware is automatically more economical.
Do all GPU cloud providers offer GB200?
No. GPU availability and service models vary. Customers should verify current hardware listings and allocation terms with each provider.
Should I choose Blackwell for a small AI model?
Not necessarily. Smaller models may run economically on other GPU generations. The best choice depends on memory, throughput, latency and total cost.
Final Verdict: Is NVIDIA Blackwell GPU Cloud Worth It?
我们的 NVIDIA Blackwell GPU 云服务评测 finds that B200 and GB200 infrastructure deserves consideration for demanding AI training, inference, and reasoning workloads.
The key is choosing the correct deployment scale. A single B200 instance, an integrated GB200 system, and a GB200 NVL72 rack serve different infrastructure requirements.
Organizations should prioritize software compatibility, GPU memory, interconnect topology, workload throughput, availability and total operating cost.
Before committing to a deployment, compare suitable cloud and dedicated infrastructure options, test representative workloads, and calculate the cost of completing useful AI work.
MODEL REQUIREMENTS → GPU ARCHITECTURE → MEMORY → INTERCONNECT → SOFTWARE → CLOUD AVAILABILITY → THROUGHPUT → TOTAL COST → DEPLOYMENT DECISION