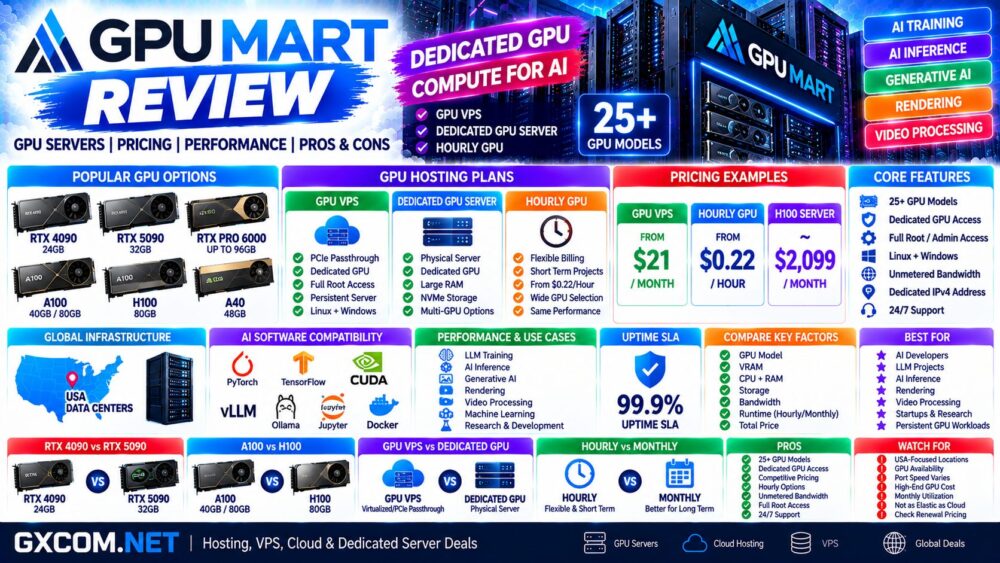
GPU Mart 是一家专门提供GPU托管服务的供应商,专为人工智能、机器学习、大型语言模型(LLM)推理、深度学习、渲染、视频处理及其他对GPU资源需求较高的任务而设计。.
与主要围绕短期共享或按需实例构建的 GPU 市场不同,, GPU Mart 该平台主要专注于长期GPU托管服务。其平台涵盖GPU虚拟专用服务器(VPS)、专用GPU服务器、多GPU系统以及部分按小时计费的GPU租赁服务。.
GPU 产品线涵盖从价格实惠的入门级 NVIDIA 显卡,到 RTX 4090、RTX 5090、RTX Pro 6000、A100 以及 H100 基础设施等各类产品。GPU Mart 还为许多套餐提供完全的 root 或管理员权限、持久化存储、专用 IPv4 地址以及不限流量的带宽。.
在这篇 GPU Mart 评测, 本文将探讨 GPU 服务器的定价、GPU VPS、专用 GPU 服务器、NVIDIA H100 和 A100 托管服务、RTX 选项、性能考量、带宽、操作系统、AI 兼容性、技术支持,以及在租用 GPU 服务器前需要考虑的主要优缺点。.
GPU Mart 评测:快速概览
| 功能 | GPU Mart |
|---|---|
| 公司 | GPU Mart / Database Mart 有限责任公司 |
| GPU Mart 品牌 | 于2021年推出 |
| GPU 虚拟专用服务器 | 是的 |
| 专用GPU服务器 | 是的 |
| 每小时 GPU | 仅限部分套餐 |
| GPU 型号 | 25+ |
| RTX 4090 | 是的 |
| RTX 5090 | 是的 |
| RTX Pro 6000 | 是的 |
| NVIDIA A100 | 是的 |
| NVIDIA H100 | 是的 |
| 多GPU | 有货 |
| GPU VPS 起始价格 | 每月$21起 |
| 每小时 GPU | 当前促销套餐的资费约为 $0.22/小时 |
| 完全root权限 | 是的 |
| Linux | 是的 |
| Windows | 可在适用服务器上使用 |
| 带宽 | 许多套餐均不限流量 |
| 正常运行时间服务水平协议(SLA) | 99.9% |
| 支持 | 24/7 |
| 主要工作地点 | 美国 |
| 最适合 | AI、大型语言模型(LLMs)、渲染、推理、开发以及持续性的GPU工作负载 |
什么是 GPU Mart?
GPU Mart 是隶属于 数据库集市 LLC是一家成立于2005年的美国主机服务公司。GPU Mart品牌于2021年推出,专注于专用GPU基础设施。.
其当前的产品系列可分为三大类:
- GPU 虚拟专用服务器
- 专用GPU服务器
- 按小时计费的 GPU 服务器
这一点至关重要,因为 GPU Mart 并非仅仅是又一个传统的 GPU 云市场。.
其基础设施侧重于专用 GPU 访问以及能够为长期运行的工作负载保持在线状态的持久化服务器。.
GPU Mart GPU VPS
GPU Mart 的 GPU VPS 平台将虚拟化技术与物理专用的 NVIDIA GPU 相结合。.
据GPU Mart称,GPU是通过PCIe直通方式分配的,而非通过GPU切片技术在多个客户之间进行分配。.
这意味着虚拟机可以访问独立的物理GPU,而CPU、内存、存储以及其他服务器资源则通过VPS环境进行分配。.
当前的 GPU VPS 套餐支持从经济实惠的入门级显卡到最新的 RTX 和 RTX Pro 硬件等各类 GPU。.
可能的工作内容包括:
- 人工智能开发
- LLM推理
- 微调
- Stable Diffusion
- 机器学习
- 视频处理
- 3D渲染
- 开发环境
GPU Mart GPU VPS 价格
入门级 GPU 配置的 GPU VPS 价格为每月 $21 起。.
不过,最便宜的套餐采用的是较旧的、内存较小的GPU硬件,不应将其与现代的AI训练服务器混为一谈。.
当前的例子包括:
| GPU 计划 | VRAM | 示例当前价格* |
|---|---|---|
| 入门级 GPU VPS | 2GB | 从 $21/月起 |
| RTX A4000 | 16GB | 根据套餐不同,每月约为$89起 |
| RTX Pro 5000 | 48GB | 在当前的VPS配置下,大约为$359/月 |
| RTX 5090 | 32GB | 当前促销版VPS套餐每月费用约为$292 |
| RTX Pro 6000 | 最高 96GB | 取决于计划 |
*GPU Mart 的价格和促销活动经常变动。下单前请务必确认当前配置、合约期限及续约价格。.
GPU Mart 专用 GPU 服务器
专用GPU服务器省去了VPS层,直接提供完整的物理服务器访问权限。.
GPU Mart 目前提供采用以下 GPU 的专用配置:
- NVIDIA RTX 系列
- RTX A4000
- RTX A5000
- RTX A6000
- RTX 4090
- RTX 5090
- NVIDIA A40
- NVIDIA A100
- NVIDIA H100
- V100 及其他传统数据中心 GPU
当工作负载需要持续的GPU利用率、大量CPU和内存分配、持久化本地存储、多GPU配置,或者对整个系统拥有更大的控制权时,专用GPU服务器就显得尤为重要。.
专用 GPU 服务器定价示例
| GPU | VRAM | 示例当前价格* |
|---|---|---|
| P600 | 2GB | $49/月 |
| V100 | 16GB | $229/月 |
| RTX A5000 | 24GB | 每月约$164的促销活动 |
| RTX 4090 | 24GB | 约$409/月 |
| RTX A6000 | 48GB | 根据当前的AI服务器列表,每月约为$409 |
| NVIDIA A100 | 40GB / 80GB 两种规格 | 根据当前的租房信息,月租金约为$639 |
| NVIDIA H100 | 80GB | 约 $2,099/月 |
*所示价格仅为当前GPU Mart上架商品的示例价格,可能会因促销活动、硬件供应情况、服务器配置及计费周期而有所变动。.
GPU Mart RTX 4090 服务器
对于那些希望获得强劲AI性能,但又不想立即转向企业级H100价格区间的用户而言,RTX 4090仍然是较为值得关注的选择之一。.
其 24GB GDDR6X 显存可支持以下工作负载:
- LLM推理
- LoRA 微调
- Stable Diffusion
- 生成式人工智能
- 计算机视觉
- 渲染
- 视频处理
GPU Mart 目前提供的 RTX 4090 专用服务器,根据配置不同,月租价格约为 $409。.
主要限制在于显存。.
对于较小和经过量化处理的模型而言,24千兆字节的容量可能非常理想,但随着模型规模、上下文长度、批量大小和训练要求的增加,这一容量就会显得不够用。.
GPU Mart RTX 5090 服务器
RTX 5090 将 GPU 内存提升至 32GB GDDR7,并将 NVIDIA 的 Blackwell 架构引入了 GPU Mart 的最新主机产品线。.
这可以成为RTX 4090级硬件与价格高得多的企业级加速器之间一个有趣的中间选择。.
GPU Mart 当前的促销 VPS 配置中,RTX 5090 机型每月价格约为 $291.85,配备 32 个 CPU 核心、84GB 内存、400GB SSD 以及 500Mbps 无流量限制的带宽。.

价格和具体配置可能会发生变化,因此请比较整台服务器的价格,而不是仅看GPU的价格。.
GPU Mart A100 服务器
NVIDIA A100 专为数据中心的 AI 和 HPC 工作负载而设计,其 GPU 内存容量远超消费级 RTX 显卡。.
GPU Mart 目前提供配备 40GB 和 80GB 内存的 A100 配置,其中包括多 GPU 系统。.
典型的工作负载包括:
- LLM 训练
- 微调
- AI推理
- 机器学习
- 科学计算
- HPC
- 多GPU工作负载
当24GB或32GB的消费级GPU内存不足时,A100就显得尤为重要。.
GPU Mart H100 服务器
GPU Mart 还提供配备 NVIDIA H100 的专用服务器,以满足高要求的 AI 工作负载需求。.
当前的 H100 服务器配置包括:80GB H100 显卡、双至强 CPU 平台、256GB 系统内存、SSD 以及 NVMe 和 SATA 存储,并提供不限流量的网络连接。.
目前公布的月费约为 $2,099。.
H100 最适合能够充分发挥其 Hopper 架构和高内存带宽设计优势的工作负载,包括:
- 大型语言模型
- 生成式人工智能
- LLM 训练
- 大型模型推理
- 深度学习
- HPC
如需更全面的比较,请参阅我们的
NVIDIA H100 服务器托管
指南。.
GPU Mart 多GPU服务器
GPU Mart 支持针对超出单个加速器处理能力的工作负载所选定的多 GPU 配置。.
根据库存情况,配置可包含多块 RTX、A 系列或数据中心级 GPU。.
多GPU基础设施可帮助实现:
- 分布式人工智能训练
- 大型模型推理
- 渲染
- 并行计算
- HPC
然而,多张GPU并不能自动实现线性性能扩展。.
实际结果取决于应用程序、框架、GPU 互连、CPU、内存、存储,以及工作负载分配计算任务的效率。.
GPU Mart 每小时GPU价格
尽管按月计费的托管服务仍是GPU Mart商业模式的重要组成部分,但该服务商现在还提供部分按小时计费的GPU基础设施。.
在相关促销活动期间,当前的按小时计费套餐起价约为每小时 $0.22。.
例如 RTX 级专用服务器和 GPU VPS 配置。.
对于以下情况,按小时计费可能更合适:
- 测试
- 简短的AI实验
- 临时渲染
- 发展
- 偶发模型推断
当服务器持续运行时,月费方案会更具吸引力。.
短工作负载 → 按小时计费的 GPU
持续工作负载 → 比较每月GPU托管服务
按月与按小时计费的GPU托管服务
| 因子 | 每小时 | 每月 |
|---|---|---|
| 承诺 | 低 | 更高 |
| 简短实验 | 紧身 | 通常没有必要 |
| 全天候工作负载 | 可能会很贵 | 通常更容易预测 |
| 预算规划 | 取决于使用情况 | 可预见的 |
| 持久化服务器 | 取决于计划 | 紧身 |
正确的计算方法是:
每小时费率 × 预计运行时间 与 每月服务器费用。.
专用GPU资源
GPU Mart 的主要卖点之一是提供专用 GPU 访问权限。.
其GPU VPS产品利用PCIe直通技术,将物理GPU分配给单个虚拟机,而专用GPU服务器则提供完整的物理硬件。.
这与基础设施不同,在基础设施中,多个客户共享同一块GPU的切片。.
专用 GPU 访问可提供更可预测的 VRAM 可用性,并减少 GPU 资源竞争。.
CPU 和其他 VPS 资源仍应分别进行评估,因为 GPU VPS 仍然是一种虚拟服务器环境。.
GPU Mart 带宽
GPU Mart 的许多套餐都包含不限流量的带宽。.
端口速度因套餐而异,当前配置通常提供100Mbps、500Mbps或1Gbps级别的网络连接。.
对于需要传输大型数据集或生成内容的工作负载而言,这可能很有帮助,因为带宽超额费用可能会显著增加其他场景下的 GPU 云服务成本。.
不过:
不限流量 ≠ 无限网速。.
请务必比较端口速度、流量策略、网络位置和工作负载要求。.
GPU Mart 存储
GPU Mart 的定价通常是将存储与 GPU 服务器捆绑在一起,而不是对每项资源单独收费。.
专用服务器的配置可以包括以下组合:
- SSD
- NVMe
- 大容量 SATA 存储设备
对于需要持久化模型、数据集、检查点、生成的文件和容器镜像的 AI 工作负载而言,这非常有用。.
存储性能依然很重要。.
大容量并不一定意味着高IOPS,因此训练和数据处理工作负载应确认活跃数据集的存储位置。.
Linux 和 Windows GPU 服务器
GPU Mart 支持相关产品在 Linux 和 Windows 环境下的运行。.
对于以下情况,Linux 通常是理所当然的选择:
- PyTorch
- TensorFlow
- CUDA 开发
- Docker
- vLLM
- LLM推理
- 人工智能训练
Windows GPU 托管可用于以下场景:
- 远程 GPU 桌面
- 渲染软件
- 视频应用
- Windows 平台专属开发
- 直播
在选择操作系统之前,请先确认软件和显卡驱动程序的要求。.
AI 软件兼容性
GPU Mart 提供完整的 root 或管理员权限,允许客户安装自己的 AI 软件栈。.
该平台目前重点强调了与以下工具的兼容性:
- PyTorch
- TensorFlow
- Keras
- Hugging Face 变压器模型
- 奥拉马
- vLLM
- Docker
- NVIDIA CUDA
- Jupyter Notebook
兼容性最终取决于所选的 GPU 架构、操作系统、NVIDIA 驱动程序、CUDA 版本以及框架版本。.
用于大型语言模型(LLM)训练的GPU市场
GPU Mart 能够支持多个硬件层级的 LLM 工作负载。.
较小的开发和推理工作负载可能适合使用 RTX 级 GPU,而较大的微调和训练任务则可能需要 A100 或 H100 基础设施。.
一个有用的选择路径是:
模型大小 → 精度 → 显存 → GPU → GPU 数量 → 运行时间 → 总成本。.
如需了解其他选项,请参阅我们的
最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器
指南。.
面向人工智能推理的GPU市场
推理并不总是需要使用市面上最昂贵的GPU。.
对于较小的量化模型,与利用率较低的 H100 相比,RTX 硬件能提供更高的成本效益。.
潜在买家应进行以下比较:
- 各型号的显存要求
- 每秒代币数
- 获得第一个代币所需的时间
- 并发用户数
- 批次大小
- GPU利用率
- 每月运行时间
- 每次请求的总成本
这比单纯比较GPU型号名称更有用。.
GPU Mart 性能
GPU Mart 提供从较旧的入门级加速器到现代 Blackwell 和 Hopper GPU 等各类硬件。.
这意味着并不存在一个单一的“GPU Mart性能”数值。.
性能取决于:
- GPU架构
- VRAM
- 内存带宽
- 张量的性能
- CPU
- 系统内存
- 存储
- 网络
- GPU数量
- 软件优化
一款 $21 入门级 GPU 虚拟私有服务器(VPS)和一款 H100 服务器面向的工作负载截然不同,不应将其视为等同的产品进行比较。.
我们是否对GPU Mart进行了独立的基准测试?
本评测基于GPU Mart目前公布的硬件规格、定价、基础设施信息及平台文档对其进行了评估。.
除非 GXCOM.NET 明确公布了基准测试方法和测试结果,否则不应将供应商的规格说明和性能声明视为 GXCOM.NET 的独立基准测试结果。.
对于严肃的AI部署,在签订长期计费合约之前,请先对您自己的模型进行基准测试。.
有用的测量数据包括:
- 每秒代币数
- 获得第一个代币所需的时间
- 培训吞吐量
- VRAM利用率
- GPU利用率
- 存储吞吐量
- 网络性能
- 每个已完成工作负载的成本
GPU Mart 与 GPU Cloud
| 因子 | GPU Mart 托管服务 | 典型的弹性 GPU 云 |
|---|---|---|
| GPU 访问 | 专注于专用GPU | 取决于平台 |
| 按月计费 | 高度关注 | 较少见 |
| 按小时计费 | 精选方案 | 常见 |
| 按秒计费 | 非主要型号 | 在某些平台上很常见 |
| 持久性工作负载 | 紧身 | 因情况而异 |
| 快速弹性扩展 | 更有限 | 强 |
| 全部服务器资源 | 与许多套餐捆绑提供 | 资源通常单独计费 |
| 最适合 | 长期运行的 GPU 工作负载 | 可变和突发型工作负载 |
这两种基础设施模式都没有哪一种天生就更便宜。.
对于持续运行的 GPU,按月托管服务可以提供可预测的成本。对于每周仅运行几小时的任务,弹性云基础设施可能更经济。.
请参阅我们的
NVIDIA GPU 服务器与 GPU 云的对比
请参阅对比表以获取更多详细信息。.
GPU Mart 与 RunPod 对比
GPU Mart 和 RunPod 以不同的方式构建 GPU 基础设施。.
| 因子 | GPU Mart | RunPod |
|---|---|---|
| 主要模型 | GPU托管 | GPU云 |
| 月度服务器 | 高度关注 | 以应用为导向 |
| 每小时 GPU | 选定的配置 | 核心模型 |
| GPU 虚拟专用服务器 | 是的 | 不同的云实例模型 |
| 专用裸机 | 是的 | 非主要产品 |
| 无服务器 | 并非核心产品 | 是的 |
| 全天候持续的工作负载 | 紧身 | 虽然可用,但使用成本各不相同 |
| Elastic AI 推理 | 传统持久化基础设施 | 提供无服务器选项 |
如需详细了解 RunPod,请阅读我们的
RunPod 评测.

GPU Mart 的优缺点
| 优点 | 缺点 |
|---|---|
| 25+ 种 GPU 型号 | 主要面向美国的基础设施 |
| GPU 虚拟专用服务器和独立服务器 | 高端显卡的价格依然居高不下 |
| 专用物理 GPU 访问 | 不如超大规模GPU云那么灵活 |
| RTX、A100 和 H100 选项 | 入门级方案采用较旧的GPU |
| Blackwell 系列的新款 GPU 选项 | GPU库存可能会发生变化 |
| 月费 | 某些促销活动在续订时可能会发生变化 |
| 精选的按小时计费套餐 | 并非每款 GPU 的计费选项都相同 |
| 许多套餐提供不限流量的带宽 | 不同套餐的端口速度差异很大 |
| 完全的root/管理员权限 | 用户需要具备技术知识才能管理人工智能技术栈 |
| Linux 和 Windows 选项 | — |
| 全天候支持 | — |
哪些人应该考虑使用GPU Mart?
GPU Mart 特别适合以下人群:
- 人工智能开发者
- LLM开发者
- 机器学习工程师
- 人工智能初创企业
- 研究人员
- Stable Diffusion 用户
- 3D渲染
- 视频处理
- 远程 GPU 工作站
- 长时间的推理
- 连续的 GPU 工作负载
当GPU需要长期保持可用状态,而不是为了处理短期任务而反复创建和销毁时,其按月计费的托管模式就显得尤为有吸引力。.
哪些人可能会更倾向于选择其他方案?
对于运行非常短暂的AI实验的用户而言,他们可能更倾向于选择弹性极高的GPU云平台,该平台支持按秒计费或完全基于使用量的计费方式。.
对于需要全球范围内靠近用户的GPU区域的项目,还应仔细比较各地区的可用性,因为GPU Mart目前主要侧重于美国的基础设施。.
同样,对于需要自动无服务器扩展的应用程序而言,可能更适合采用专门针对无服务器推理设计的基础设施。.
GPU Mart 适合长期使用 GPU 托管服务吗?
长期运行的工作负载是 GPU Mart 较为有趣的应用场景之一。.
当 GPU 服务器持续在线时,固定月费模式可以使基础设施成本更易于预测。.
与将每项资源分别计费的平台相比,捆绑提供的 CPU、内存、存储、带宽和 GPU 资源也能简化成本核算。.
不过,买家应将月费与实际的GPU利用率进行对比。.
一台每月大部分时间处于闲置状态的服务器,其成本仍可能高于按需使用的 GPU 基础设施。.
GPU Mart 物有所值吗?
GPU Mart 的价值在很大程度上取决于其利用率。.
如果持续使用,专用的月租型 GPU 可能颇具吸引力;而对于短期实验性工作负载,采用按小时计费或无服务器基础设施可能实现更低的总成本。.
GPU的选择同样重要。.
虽然 H100 处理高负载任务的速度可能远快于廉价的 RTX 显卡,但为了一个能轻松容纳在 24GB 显存中的小型模型而支付 H100 的价格,可能并不必要。.
有用的计算公式是:
GPU + VRAM + CPU + 内存 + 存储 + 带宽 + 运行时 = 实际 GPU 托管成本。.
如需了解更多的服务提供商和最新优惠,请参阅我们的
超值GPU租赁优惠
比较。.
GPU Mart 评测:最终总结
GPU Mart 在传统专用服务器托管与高度弹性的 GPU 云平台之间占据了一个得天独厚的地位。.
其当前的基础设施涵盖经济实惠的 GPU VPS 套餐、先进的 RTX 和 RTX Pro 硬件、专用 GPU 服务器、A100 和 H100 系统、多 GPU 配置以及部分按小时计费的租赁服务。.
其主要差异化优势之一是专用的 GPU 访问权限。GPU VPS 客户可获得物理 GPU 直通,而非共享的 GPU 切片;而专用服务器客户则可获得整台物理服务器。.
该平台特别适用于持久性人工智能、大型语言模型(LLM)推理、渲染、开发以及其他需要在较长时间内可预测地访问同一基础设施的 GPU 工作负载。.
其中的权衡在于弹性。对于仅偶尔运行的工作负载而言,长期租用的月度GPU服务器并不一定就是最经济的選擇,而且像H100这样的高端加速器价格依然高昂。.
下单前,请参考以下决策流程:
工作负载 → 训练/推理 → 模型大小 → 显存 → GPU → 虚拟私有服务器/专用服务器 → 按小时计费/按月计费 → 总成本。.