

用于大型语言模型(LLM)推理的 AMD GPU 服务器:ROCm 兼容性、内存及托管成本
对于正在评估替代基于英伟达(NVIDIA)的人工智能基础设施的团队而言,用于大型语言模型(LLM)推理的AMD GPU服务器正变得越来越重要。AMD Instinct加速器能够提供巨大的内存容量和计算资源,但硬件的选择仅仅是……
适用于 TensorRT-LLM 的 NVIDIA GPU 服务器:吞吐量、批处理和托管成本
为 TensorRT-LLM 选择 NVIDIA GPU 服务器,不仅需要比较 GPU 内存和每小时租赁价格。大型语言模型的推理取决于吞吐量、请求并发数、批处理效率、内存管理以及延迟目标。一款强大的加速器……
NVIDIA GPU 用于 LLM 推理的 VRAM 需求:量化、上下文和 KV 缓存
在租用 AI 服务器之前,了解 NVIDIA GPU 针对 LLM 推理的 VRAM 要求至关重要。即使某个语言模型在加载时能够完全容纳在 GPU 内存中,当用户提交较长的提示词或多个……时,该模型仍可能出现故障。
AI推理服务器规格规划:并发用户数、每秒令牌数和GPU内存
AI推理服务器的规格规划应以用户期望的体验为出发点,而非您想要租用的GPU型号。一个仅需处理偶尔咨询的聊天机器人,其配置需求与一个需要同时处理数百个请求的API截然不同……
AMD Instinct MI300X GPU 服务器评测:HBM、ROCm 及大型语言模型(LLM)部署成本
部署大型语言模型需要在GPU内存、推理吞吐量、软件兼容性以及基础设施成本之间取得精妙的平衡。一款强大的加速器可以降低硬件需求,但前提是其性能必须与应用相匹配。AMD……
NVIDIA L4 与 L40S 对比:视频推理、GPU 内存及云托管成本
在 NVIDIA L4 和 L40S 之间做出选择,不仅仅是为了获得更强的 GPU 性能。选择合适的加速器取决于模型规模、视频处理要求、推理并发度以及完成任务的实际成本……
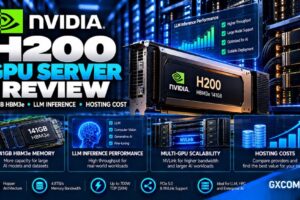
NVIDIA H200 GPU 服务器评测:HBM 内存、大型语言模型推理及托管成本
大型语言模型改变了企业评估GPU服务器的方式。虽然原始计算性能依然重要,但GPU内存容量、内存带宽、互连技术以及基础设施成本在决定部署是否可行方面发挥着越来越重要的作用。这款NVIDIA H200……
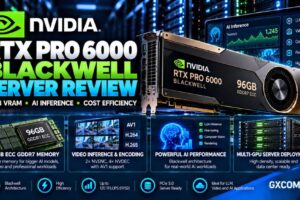
NVIDIA RTX PRO 6000 Blackwell 服务器评测:96GB 显存与 AI 工作负载
运行大型AI模型已不再仅仅取决于原始计算能力。GPU内存容量、推理吞吐量、软件兼容性以及长期运营成本,在很大程度上决定了部署能否成功。这款NVIDIA RTX PRO 6000 Blackwell……
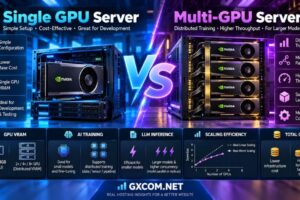
单GPU与多GPU服务器:AI训练、推理扩展及基础设施成本
增加更多GPU似乎是加速人工智能工作负载的显而易见的方法。如果一个GPU能够训练或部署一个模型,那么四个GPU的速度应该快四倍——至少人们是这么认为的。现实中的AI……
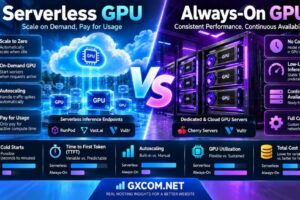
无服务器 GPU 与常驻 GPU:冷启动、大语言模型推理延迟及成本
部署大型语言模型已不再仅仅是选择合适的GPU的问题。GPU的配置、可用性维护、扩展以及计费方式,对应用程序的影响同样重要……
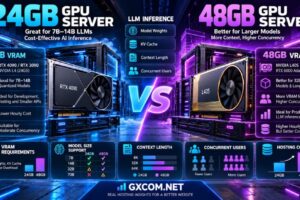
24GB 与 48GB GPU 服务器:VRAM 需求、LLM 推理及托管成本
选择24GB还是48GB的GPU服务器,将决定您的大型语言模型是能流畅运行、受限于内存而运行不畅,还是导致托管成本不必要地高昂。不过,这一决策远比单纯比较……要复杂得多。
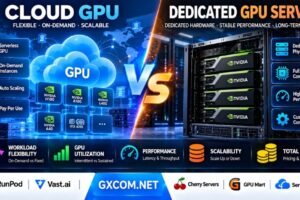
云GPU与专用GPU服务器:AI工作负载的灵活性、利用率及总成本
进行人工智能应用时,是应该从云平台租用GPU,还是选择专用GPU服务器?答案不仅取决于GPU的规格或宣传的每小时价格。人工智能工作负载对资源的需求差异很大……
RunPod 无服务器 GPU 评测:冷启动、AI 推理及每次请求成本
本篇关于 RunPod 无服务器 GPU 的评测,将探讨 RunPod 在 AI 推理、冷启动、自动扩展、GPU 工作节点利用率以及每次请求成本方面的表现。对于正在构建 LLM API、图像生成服务、AI 代理或生产级推理管道的开发者来说……
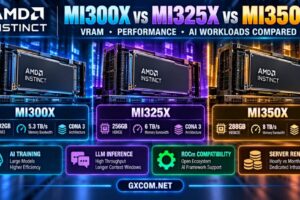
AMD Instinct MI300X、MI325X 与 MI350X 服务器对比:显存、性能与 AI 工作负载
在 AMD Instinct MI300X、MI325X 和 MI350X 之间进行选择,将对 AI 服务器部署的成本、性能和可扩展性产生重大影响。这些数据中心加速器专为高要求的工作负载而设计,例如大型语言模型……
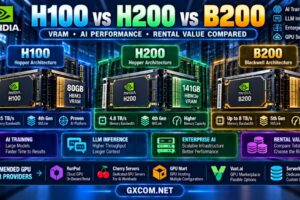
NVIDIA H100、H200 与 B200 服务器对比:VRAM、AI 性能及租赁价值分析
对于运行大型语言模型、AI 训练管道和高吞吐量推理服务的组织而言,在 NVIDIA H100、H200 和 B200 GPU 服务器之间做出选择是一项重要的基础设施决策。尽管这三款加速器均面向要求严苛的数据中心……