选择一个 多GPU服务器租赁 这不仅仅是一个购买更多图形处理器的简单问题。一台配备两块GPU的机器可能高效地完成推理任务,而一台配备八块GPU的服务器只有在软件、内存和互连技术能够支持有效扩展的情况下,才对大型模型的训练具有价值。最便宜的每小时GPU使用费率往往无法全面反映实际情况。.
本指南对比了2-GPU、4-GPU和8-GPU托管方案的成本,解释了影响性能的硬件细节,并分析了来自 RunPod, GPU Mart, Cherry 服务器, ,以及Vultr。其目标是帮助AI团队为有用的吞吐量付费,而不是为闲置的硬件付费。.
2-GPU、4-GPU 与 8-GPU 服务器:主要区别
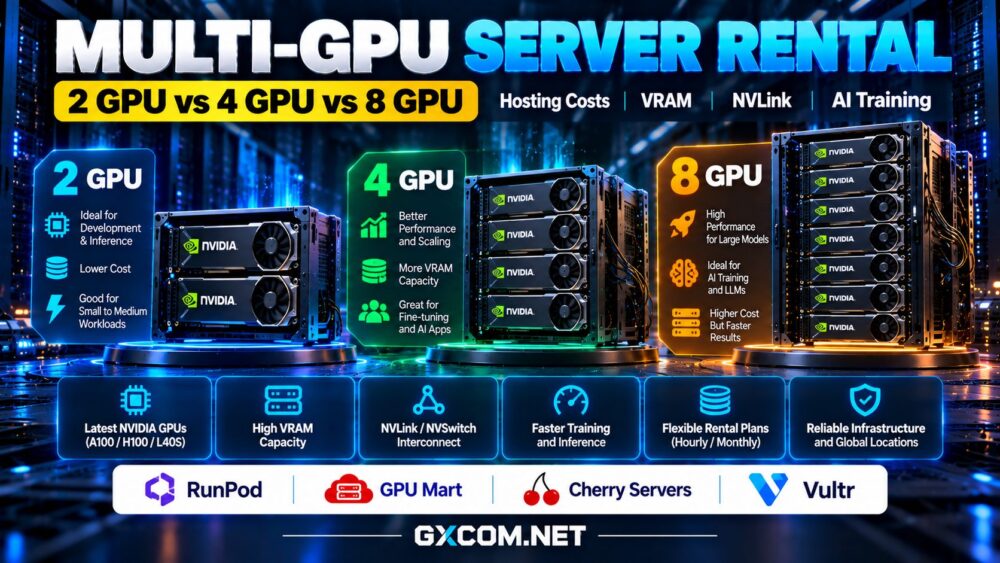
两个GPU 对于并行推理工作节点、规模较小的分布式训练实验以及能够将批次在设备间进行分配的工作负载而言,这些配置通常已足够。此外,它们还提供了一种切实可行的方法,用于测试应用程序是否能从多个加速器中获益。.
四块GPU 提供更大的总计算能力和内存容量。它们适合处理规模更大的微调任务、多个推理服务,以及同时进行实验的团队。不过,四个独立的内存池并不会自动合并为一个共享池。.
八个GPU 通常被用于高强度训练、高吞吐量推理以及模型并行计算。其价值在很大程度上取决于快速的GPU间通信、充足的CPU资源、系统内存、存储吞吐量以及网络带宽。.
在选择配置之前,请确认列表中描述的是同一台物理主机上的 GPU,还是通过网络连接的独立实例。在通信密集型工作负载下,这两种配置的行为方式不同。.
GPU内存和互连的重要性远超核心数量本身
八个低内存GPU不能与数量较少的高内存加速器互换使用。即使总VRAM看似足够,一个需要在单个设备上消耗大量内存的模型,可能仍然需要张量并行或流水线并行。.
基于 PCIe 的配置在处理独立任务时表现良好,但对于通信密集型训练任务,如果特定 GPU 型号和服务器架构支持,使用 NVLink 或 NVSwitch 可能会带来更好的效果。请不要认为每台配备 8 个 GPU 的机器都具备全对全的高带宽互连架构。.
请查看我们的 PCIe 与 SXM GPU 服务器的对比 了解物理形态和连接性如何影响工作负载的部署。.
多GPU租赁费用的计算方式
服务提供商可能会按每GPU小时、每台完整实例或通过月度专用服务器合同进行计费。按每GPU计费的价格并不一定包含您的项目所需的CPU、内存、本地存储、网络或管理功能。.

为了简单说明,假设每台GPU每小时的费用为$2,且服务商不收取额外的平台费。两台GPU每小时的费用为$4,四台为$8,八台为$16。 一个连续的30天月份包含720小时,因此相应的理论总费用分别为$2,880、$5,760和$11,520。.
这些只是假设性的计算示例,并非任何供应商的广告价格。实际成本取决于 GPU 代数、地区、可用性、最低采购量、存储、数据传输以及计费政策。.
比较每项完成工作的成本,而不仅仅是每小时的成本
假设一个训练任务在两块GPU上需要20小时。 如果使用四块GPU仅需12小时(而非10小时)即可完成,则新增的设备并未实现完美的线性扩展。以每GPU小时$2为例,这两种配置的成本分别为$80和$96。.
现在假设八个GPU在八小时内完成了相同的工作。尽管耗时更短,但成本仍为$128。当更快的交付速度、实验周转时间或截止期限限制成为关键因素时,配置更高的服务器可能仍然物有所值。.
度量 每次完成培训的单次成本, ,每美元处理的样本数,或每美元处理的推理请求数。在决定使用更强大的服务器之前,请先对实际模型、批量大小、精度和框架进行基准测试。.
多GPU托管服务商对比
RunPod:支持灵活实验的GPU云平台
RunPod 对于希望构建 GPU 云环境并采用灵活部署工作流的团队而言,该方案值得评估。请查看当前列出的多 GPU 实例规格、加速器型号、区域可用性、持久存储费用,以及您的工作负载是否需要特定的互连技术。.
其适用性取决于具体的部署配置,而不仅仅取决于显示的GPU数量。如需更详细地了解该平台,请参阅我们的 RunPod GPU 云服务评测.
GPU Mart:评估专用硬件选项
GPU Mart 在比较 GPU 托管和专用基础设施时,这也是值得考察的另一家服务商。请确认其目前是否提供合适的 2、4 或 8 GPU 系统,并核实具体的 GPU 型号、主机规格、互连方式以及合同条款。.
专用硬件虽能提供可预测的资源访问,但对于间歇性的训练而言,较长的使用期限可能导致效率低下。我们的 GPU Mart 评测 为供应商评估提供了起点。.
Cherry Servers:专用基础设施规划
Cherry 服务器 这对正在评估专用基础设施和可配置服务器环境的买家具有参考价值。请询问有哪些配备GPU的配置可供选择,以及是否能在单台机器上提供所需数量的GPU。.
比较部署周期、CPU 和内存分配、存储性能、网络传输以及管理要求。对于持续性工作负载,当利用率始终保持较高水平时,专用方案可能更具吸引力。.
Vultr:查看 GPU 云配置详情
Vultr 提供云基础设施和基于GPU的计算选项。购买者应确认当前的加速器产品线、可用GPU数量、支持的区域以及每种具体实例的计费规则。.
云部署虽然能提供运营灵活性,但不同区域之间的 GPU 可用性和实例规格可能存在显著差异。请勿假设每款 GPU 产品都支持八个设备或专用高速互连。.
何时应该选择 2、4 或 8 个 GPU?
在测试分布式执行、为独立推理工作节点提供服务或控制实验成本时,请选择两块 GPU。当测得的吞吐量提升足以抵消额外的小时费用,或者模型需要更大的分布式处理能力时,可将数量增加到四块。.
对于能够有效扩展、需要大量并行计算或有严格完成时限的工作负载,建议考虑使用八个 GPU。请确保您的框架支持预期的拓扑结构,并且通信开销不会抵消预期的效益。.

我们的 GPU 与 CPU 服务器指南 有助于判断在增加GPU数量之前是否需要进行加速。.
租房前的隐性成本与注意事项
请咨询有关存储容量、检查点、数据输入和输出、预留容量、操作系统访问权限、技术支持响应以及服务器停止运行时的情况。即使计算资源已关闭,持久性存储仍可能继续计费。.
请确认 GPU 内存是否为专用内存、主机是否为共享主机,以及服务商是否保证特定的拓扑结构。请将用于调整分布式训练代码和恢复中断任务所花费的工程时间计入其中。.
如需进行更全面的供应商调研,请浏览我们的 NVIDIA GPU服务器供应商对比 在最终确定租赁事宜之前。.
最终结论:仅在工作负载增加时才进行扩展
对于小型实验和并行推理而言,配备两块GPU的服务器可能是一种经济实惠的选择。四块GPU可为不断增长的工作负载提供折中方案,而当内存布局和互连条件合适时,八块GPU则能缩短高负载训练任务的运行时间。.
请根据确切的可用配置(而非笼统的“GPU数量”标签)来比较 RunPod、GPU Mart、Cherry Servers 和 Vultr。最佳选择是 多GPU托管方案 在满足您的性能、可靠性和交付要求的同时,将有效结果的总成本降至最低。.