进行人工智能计算时,是应该从云平台租用GPU,还是选择专用GPU服务器?答案不仅取决于GPU的规格或宣传的每小时价格。.
AI 工作负载对资源的需求各不相同。一位正在尝试开源语言模型的开发者可能只需使用高性能 GPU 几小时;而一个生产环境中的推理服务则可能全天候处理请求;训练团队可能需要在固定时间内使用多块互联的 GPU,而创意工作室则可能需要在每个工作日都拥有可预测的渲染能力。.
在这篇 云GPU 与 专用GPU服务器 为了进行比较,我们将考察工作负载灵活性、GPU利用率、部署速度、硬件控制、性能一致性、可扩展性以及总体拥有成本。.
我们还探讨了 RunPod 提供的基础设施方案,, Vast.ai, Cherry 服务器, GPU Mart, ,以及 ServerMania, ,帮助买家了解哪种类型的服务提供商可能适合他们的工作负载。.
编辑方法:本文基于服务商的文档资料、技术特性及示例性成本计算,对各类基础设施模型进行了比较。GXCOM.NET 并未对同类云系统和专用 GPU 系统进行独立基准测试。价格、硬件库存、可用性及合同条款均可能发生变化。成本示例均为假设情况,不应被视为服务商的实际报价。.
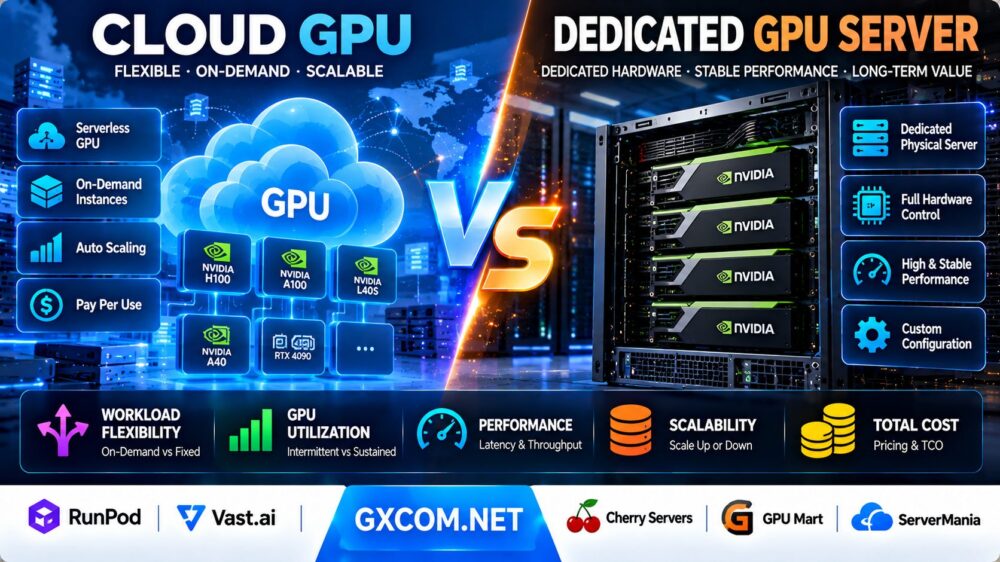
云GPU与专用GPU服务器:快速评测
当工作负载具有临时性、不可预测性、实验性,或者需要快速访问不同的 GPU 型号时,请选择云 GPU 托管服务。.
当工作负载持续存在、利用率始终较高,且需要直接控制硬件、存储、网络和运行环境时,请选择专用 GPU 服务器。.
云GPU服务可以降低预留昂贵硬件所带来的财务风险,因为这些硬件在每个月的大部分时间里都处于闲置状态。.
当工作负载持续使用加速器,且所租用的服务器能够以具有竞争力的实际每小时成本提供足够性能时,专用 GPU 服务器在经济上就具有吸引力。.
然而,这两种方法并不总是更便宜。有些云产品提供预留容量,而有些裸机服务商则提供按小时计费。正确的比较必须基于具体的产品,而不能仅凭服务商类别来判断。.
| 比较因素 | 云端 GPU | 专用GPU服务器 |
|---|---|---|
| 主要资源模型 | 按需或按量计费的 GPU 计算 | 专用物理服务器或租用硬件 |
| 典型部署 | GPU 实例、容器、无服务器端点 | 配备专用硬件的物理服务器 |
| 缩放 | 根据库存情况启动或发布实例 | 增加或替换物理容量,具体视资源分配情况而定 |
| 硬件控制 | 取决于平台 | 通常具有更强的系统级控制能力 |
| 闲置产能 | 某些产品支持缩减计算规模 | 已预留的硬件在闲置期间仍可能产生费用 |
| 账单 | 按使用量计费、预留或无服务器 | 按小时、按月或按合同计费 |
| GPU性能 | 取决于硬件和分配模型 | 取决于专用硬件的配置 |
| 硬件变更 | 通常切换实例类型会更容易一些 | 可能需要更换硬件或部署新服务器 |
| 业务工作 | 范围从托管端点到自主管理的虚拟机 | 通常需要承担更大的服务器管理责任 |
| 最佳匹配 | 可变且具有实验性质的人工智能工作负载 | 可预测且持续的人工智能工作负载 |
什么是云GPU托管?
云GPU托管服务通过服务平台提供基于GPU加速的计算能力。.
客户无需购买实体加速器或自行搭建GPU服务器,即可部署兼容的AI应用程序。.
根据服务提供商的不同,云端 GPU 产品可能包括虚拟机、GPU 容器、无服务器推理端点、专用 GPU 实例以及多节点集群。.
按需 GPU 实例
按需实例允许用户为开发、训练、推理或批处理配置 GPU 资源。.
计费可能按秒、分钟或小时计算,具体取决于服务类型。.
无服务器 GPU 推理
无服务器平台通过 API 端点执行兼容的推理工作负载。.
当流量消失时,某些服务会缩减 worker 数量,从而降低闲置计算资源的费用。.
然而,模型加载、工作进程初始化和活动容量设置都会影响延迟和成本。.
GPU 交易平台
GPU 交易平台将客户与不同主机提供的可用加速器算力资源进行对接。.
不同列表中的硬件选型、定价、网络特性及主机可靠性可能存在差异。.
预留云GPU
一些云服务提供商为工作负载可预测的客户提供预留或承诺的计算资源。.
这些产品可能会降低有效计算速率,但会引入承诺或取消方面的考量。.
重要区别
云 GPU 实例可以在不向客户提供整台物理服务器的情况下,提供对物理加速器的独占访问权限。.
因此,“云GPU”和“专用GPU”这两个术语并不总是互斥的。.
更准确的比较应是在 按量计费的云GPU服务 以及 专用的物理GPU服务器基础设施.
什么是专用GPU服务器?
专用GPU服务器是指配备了一块或多块GPU,并专供某位客户使用的物理服务器。.
它通常包括专用的 CPU 资源、系统内存、存储设备、网络接口以及操作系统访问权限。.
客户可以从基础设施提供商处租用专用GPU服务器,而无需自己购买和维护硬件。.
裸机 GPU 服务器
裸机托管让客户能够直接使用物理服务器,而不像云托管那样采用常见的虚拟机抽象层。.
当工作负载需要直接访问 GPU 驱动程序、操作系统设置、存储布局或专用软件时,这种方式就颇具吸引力。.
单GPU服务器
单GPU专用服务器可能适用于较小的推理应用、渲染、开发环境以及专用计算任务。.
多GPU服务器
多GPU服务器能够支持更大规模的模型、并行训练,以及能够从多个加速器中获益的应用程序。.
然而,仅靠GPU数量并不能保证高效的可扩展性。.
专用基础设施控制
专用服务器在操作系统、驱动程序、容器运行时、网络和存储配置方面可能提供更大的灵活性。.
可行使的控制权取决于服务提供商及管理安排。.
云GPU 与 专用GPU:工作负载灵活性
灵活性是选择云端 GPU 基础设施的最有力理由之一。.
短期人工智能实验
开发人员在测试模型架构时,可能需要在不同的开发阶段使用不同的GPU。.
云托管可以简化对多个加速器模型的测试流程,而无需维护多台物理服务器。.
临时培训岗位
对于运行时间有限的训练任务,按量计费的云资源可能更为合适。.
客户仍应考虑启动时间、数据传输以及检查点存储。.
连续生产工作负载
对于持续运行的应用程序,专用硬件可能会带来好处,特别是在资源利用率持续较高的情况下。.
不过,对于持续性需求而言,预留型云GPU产品同样具有竞争力。.
GPU 配置要求的变更
云平台或许能让开发人员更轻松地从一代GPU过渡到下一代GPU。.
对于专用服务器,硬件升级可能需要更换新服务器或进行物理重配置。.
需求激增
当需求激增时需要额外实例,云平台便显得颇具吸引力。.
不过,扩展能力取决于实际库存、账户配额、部署时间以及应用程序架构。.
GPU利用率:最重要的经济变量
GPU利用率是基础设施成本效率的关键。.
不过,必须对“利用率”一词进行精确定义。.
GPU 计算利用率
GPU 计算利用率衡量的是加速器在处理工作负载期间的繁忙程度。.
GPU 在执行相对较少的计算时,可能会显示较高的内存使用率。.
可计费利用率
可计费利用率衡量的是,付费的基础设施时间中有多少用于产出有价值的工作。.
例如,即使应用程序仅在工作时间运行,也可以租用一台专用GPU服务器整整一个月。.
产能利用率
产能利用率是指实际产出的有效产量与购入的总产能之比。.
作业失败、重复的模型初始化、闲置的预留资源以及低效的批处理都会降低生产利用率。.
为什么高利用率很重要
如果持续使用专用服务器,其固定成本就可以分摊到更多的有效GPU小时数上。.
当服务器处于空闲状态时,生产性工作的实际成本就会增加。.
为什么云利用率有所不同
云用户有时可以在工作完成后释放资源。.
不过,保留存储、最低计费周期、预留承诺以及“温存”的无服务器工作进程仍可能产生费用。.
云GPU与专用GPU服务器:总体拥有成本
总体拥有成本(TCO)不仅包括计算费用。.
其中还包括存储、网络、管理、软件许可、监控、停机时间以及保持容量可用所产生的成本。.
云 GPU 成本构成
- GPU 计算时间
- CPU 和系统内存分别计费
- 持久化存储
- 数据传输
- 预留容量承诺
- 工人的初始化和空闲期
- 监测与运营服务
- 软件和模型托管许可
专用GPU服务器的成本构成
- 定期服务器租赁
- 如适用,将收取设置或开通费用
- 网络流量与带宽升级
- 额外存储空间
- 备份基础设施
- 托管管理服务
- 软件许可
- 硬件更换与恢复流程
- 未使用的预留容量
不要仅比较 GPU 的每小时费率
GPU的每小时单价较低,并不一定意味着总工作负载成本会降低。.

较便宜的 GPU 每秒处理的令牌数量可能较少,需要更多实例,或者会产生额外的存储和网络费用。.
同样,专用服务器的每小时费用看似不高,但在利用率较低时,成本就会变得很高。.
云GPU与专用GPU:盈亏平衡利用率计算公式
一个简单的盈亏平衡模型有助于估算专用GPU服务器何时具备竞争力。.
定义以下变量:
C = 每生产性 GPU 小时的云 GPU 价格。.
D = 每月专用 GPU 服务器的费用。.
H = 每月所需的有效 GPU 小时数。.
不考虑其他成本,且假设性能相当:
云成本 = C × H。.
专用成本 = D.
盈亏平衡的工作量为:
GPU 小时数的盈亏平衡点 = D / C。.
假设成本示例
假设每小时有效运行时间的云端 GPU 费用为 $2.50。.
假设一台性能相当的专用GPU服务器每月费用为$900。.
盈亏平衡点是:
$900 / $2.50 = 每月360个有效GPU小时。.
以一个720小时的示例月为例,这意味着:
360 / 720 × 100 = 50% 可计费利用率。.
在这些简化的假设下,当每月有效GPU使用时长超过360小时时,专用服务器的成本就更低了。.
这些数值仅为假设,并不代表任何供应商的报价。.
为什么实际盈亏平衡点会发生变化
当系统表现不同时,实际的盈亏平衡点也会随之变化。.
此外,费用还会因存储费、网络传输费、管理费、预留云折扣、服务器设置费以及容量承诺等因素而有所变化。.
当两个系统的吞吐量不同时,应比较每完成一个任务或每百万令牌的成本,而不是将一个GPU小时视为等价。.
云GPU 与 专用GPU:月度成本对比
以相同的假设值——$2.50 云服务费率和 $900 专用月费为例,以下几种情景说明了利用率的重要性。.
| 每月有效GPU运行小时数 | 云端 GPU 成本 | 专用服务器费用 | 降低简化成本 |
|---|---|---|---|
| 100小时 | $250 | $900 | 云端 GPU |
| 200小时 | $500 | $900 | 云端 GPU |
| 300小时 | $750 | $900 | 云端 GPU |
| 360小时 | $900 | $900 | 平等 |
| 500小时 | $1,250 | $900 | 专用服务器 |
| 720小时 | $1,800 | $900 | 专用服务器 |
这些场景假设性能相当、能够完美释放未使用的云计算资源,且不会产生额外费用。.
它们展示的是一种决策框架,而非实际市场价格。.
大型语言模型(LLM)推理中云端 GPU 与专用 GPU 的对比
大型语言模型的推理需要在延迟、吞吐量、GPU内存和成本之间取得精妙的平衡。.
低样本量推断
对于偶尔接收请求的应用程序,采用无服务器 GPU 服务可能更有利,因为这种服务可以在空闲期间降低计算资源的使用量。.
不过,冷启动可能会影响设备闲置后收到的第一个请求。.
大规模推理
处理持续流量的应用程序可能受益于持久的 GPU 算力。.
当GPU利用率持续较高且可预测的吞吐量至关重要时,专用服务器便具有吸引力。.
获得首个代币所需时间
“首次令牌生成时间”衡量模型开始生成输出所需的时间。.
对于交互式应用程序而言,该指标可能比基准测试的峰值吞吐量更为重要。.
每秒代币数
输出令牌吞吐量衡量模型生成令牌的速度。.
在模型、精度、输入长度、输出长度和并发度均相同的情况下,比较吞吐量。.
批次处理效率
对于兼容的推理引擎,连续批处理可以提高吞吐量。.
不过,较大的批次也会影响单个请求的延迟。.
每百万代币的成本
使用以下公式:
每百万输出代币的成本 = 应计推断成本总额 / 输出代币 × 1,000,000。.
请在适当情况下包含闲置容量、员工入职、存储以及失败的请求。.
AI 训练中云 GPU 与专用 GPU 的对比
训练工作负载与推理工作负载存在显著差异。.
它们可能需要长时间运行的任务、多块GPU、高速存储、检查点机制以及高带宽通信。.
简短的培训实验
对于规模有限的实验和模型测试而言,云端 GPU 基础设施可能非常方便。.
反复微调
运行重复微调任务的组织应计算其每月的累计GPU小时数。.
如果利用率持续处于较高水平,那么或许值得考虑采用专用硬件。.
多GPU训练
分布式训练性能取决于 GPU 互连、网络、内存以及软件效率。.
通过合适的高带宽拓扑连接的八块GPU,其表现可能与分散在连接质量较差的系统中的八块GPU截然不同。.
检查点机制
训练任务应保存检查点,以减少因中断或故障造成的损失。.
检查点的频率和存储吞吐量可能会影响性能。.
可预留容量
可中断的云端 GPU 服务可能有助于降低容错训练任务的成本。.
不过,必须确保任务在中断后能够恢复运行。.
GPU 内存、硬件代际与软件兼容性
GPU内存和软件支持通常比供应商类别更为重要。.
显存容量
大型模型需要足够的GPU内存来存储权重、激活函数、运行时缓冲区和键值缓存。.
VRAM 不足可能会导致无法部署,或者需要采用速度较慢的卸载技术。.
NVIDIA CUDA
许多人工智能应用都依赖于 NVIDIA CUDA 及其相关的优化库。.
请确认所选的 GPU 代数是否支持所需的软件堆栈。.
AMD ROCm
对于受支持的 ROCm 工作负载,AMD 加速器可能适用。.
然而,并非所有面向 CUDA 的应用程序都能在不进行修改的情况下在 ROCm 上运行。.
GPU 互连技术
多GPU训练和推理可以依赖于PCIe、NVLink或其他通信技术。.
请核查具体的硬件拓扑结构,而不是假设每台多GPU服务器的互连性能都相同。.
CPU 和 RAM
GPU 工作负载还需要足够的 CPU 资源和系统内存,用于预处理、数据加载、协调以及应用服务。.
性能一致性:云与裸机对比
专用硬件虽然能更好地控制资源分配,但并不能保证在每项基准测试中都能表现更优。.
共享基础设施的影响
有些云环境共享主机级资源,而另一些则分配专用的GPU算力。.
实际的隔离程度取决于服务架构。.
虚拟化开销
虚拟化开销因平台、GPU 分配方式和工作负载的不同而有所差异。.
应该通过测量来确定,而不是凭空假设。.
热和功率限制
GPU 功耗限制、散热条件以及持续时钟频率的表现都会影响吞吐量。.
存储瓶颈
数据集加载缓慢可能会导致性能昂贵的 GPU 处于等待数据的状态。.
网络瓶颈
分布式工作负载的瓶颈往往在于节点间的通信,而非 GPU 的计算能力。.
基准建议
在具有代表性的条件下,比较每小时完成的任务数、每秒代币数、延迟百分位数以及总成本。.
仅靠GPU的原始规格是不够的。.
可扩展性与GPU可用性
云GPU平台通常以部署迅速著称,但其资源并非取之不尽。.
云端 GPU 的可用性
某些加速器型号在目标地区可能无法提供。.
需求旺盛的GPU代产品可能会面临产能限制。.
专用GPU的可用性
专用服务器的部署取决于物理硬件库存、部署能力,有时还取决于合同审批。.
扩大规模
云平台可能使选择更大规格的实例或启动更多工作节点变得更加容易。.
专用基础设施可能需要配置一台新的物理服务器。.
缩减规模
当不再需要时,通常可以释放云计算资源。.
专用服务器可能会在约定的解约日期或合同到期日之前继续产生费用。.
容量规划
生产系统应考虑在发生故障后,能够多快获得替代的GPU算力。.
存储、网络和数据传输成本
数据传输是人工智能基础设施经济学的重要组成部分。.
模型存储
大型模型可能需要大量的持久化存储空间。.
反复下载权重可能会增加启动时间并消耗更多网络流量。.
训练数据集
大型数据集在不同区域或服务提供商之间传输可能需要相当长的时间。.
检查点存储
训练检查点可能会占用大量磁盘空间和网络带宽。.
云存储计费
一些云GPU服务商在计算停止后,仍会继续对保留的配额收取费用。.
例如,RunPod 记录了针对特定产品的存储费用,而 Vast.ai 则描述了保留实例的持续存储费用。.
专用服务器存储
专用服务器可能配备本地 NVMe 或 SSD 存储,具体取决于服务商,还可提供额外的硬盘或网络存储。.
网络出站流量
请查看该具体服务的数据传输配额和计费规则。.
有些服务商将数据传输量包含在计算产品中,而另一些则会对特定的网络使用量收取费用。.
值得考虑的云GPU服务商
RunPod:Pod、无服务器架构和集群
RunPod 提供用于开发和长期运行工作负载的 GPU Pod、适用于兼容推理应用的无服务器端点,以及用于处理大型任务的集群产品。.
其无服务器弹性工作单元在空闲时可以缩减规模,这对于难以预测的推理流量可能很有帮助。.
然而,在岗员工、初始化时间以及存储空间都会影响总成本。.
请阅读我们的 RunPod 无服务器 GPU 评测 以更深入地了解冷启动、工作者行为和推理成本。.
Vast.ai:GPU 市场平台的灵活性
Vast.ai 通过一个市场平台提供 GPU 算力,该平台上的价格和硬件特性因主机而异。.
其产品包括按需、可中断、预留和无服务器等选项。.
市场买家应评估主机可靠性、GPU规格、网络状况、存储费用以及中断政策。.
我们的 Vast.ai GPU 市场评测 阐述了其他采购注意事项。.
值得考虑的专用GPU服务器提供商
Cherry Servers:可配置的裸机服务器
Cherry Servers 为人工智能、机器学习及其他加速工作负载提供专用 GPU 基础设施。.
其公开提供的服务包括可配置的专用服务器,以及针对符合条件的产品提供的小时计费和固定期限计费选项。.
客户应确认 GPU 型号、服务器配置、位置、网络配额以及最低计费承诺。.
有关其他硬件方面的注意事项,请参阅我们的 Cherry Servers 裸机评测.
GPU Mart:专用GPU托管服务
GPU Mart 专注于GPU托管产品,包括专用GPU服务器以及配备专用加速器访问权限的GPU VPS服务。.
其裸机 GPU 服务器可能适用于长时间运行的 AI 推理、训练和渲染工作负载。.
请核对确切的显卡型号、显存、物理配置、支持范围及定期费用。.
请阅读我们的 GPU Mart 专用 GPU 服务器评测 如需了解更多信息。.
ServerMania:专用基础设施评估
ServerMania 提供专用服务器基础设施和定制化托管方案。.
对于希望部署定制化物理服务器的组织而言,这或许值得考虑。.
不过,买家在未获取最新的硬件报价之前,不应想当然地认为某款GPU型号有货。.
在将某项方案视为 GPU 服务器的替代方案之前,请确认加速器的可用性、部署时间表、管理职责以及网络规格。.
云GPU与专用GPU服务器:服务商对比
| 服务提供商 | 基础设施方法 | 潜在应用场景 | 主要购买考虑因素 |
|---|---|---|---|
| RunPod | GPU 集群、无服务器架构、集群 | 弹性推理、开发、训练 | 工作节点计费、存储和GPU库存 |
| Vast.ai | GPU 市场与无服务器架构 | 灵活的GPU选择和批处理任务 | 主机可靠性、中断情况及总费用 |
| Cherry 服务器 | 专用裸机 GPU 基础设施 | 持续的工作负载与硬件控制 | GPU配置与合同条款 |
| GPU Mart | GPU VPS 和专用 GPU 服务器 | 持续的AI计算与渲染 | VRAM、硬件分配和经常性成本 |
| ServerMania | 专用和定制服务器基础设施 | 定制化物理基础设施评估 | 通过报价确认实际GPU供应情况 |
针对不同AI工作负载,云GPU与专用GPU的对比
| 工作量 | 初始基础设施偏好 | 为什么 |
|---|---|---|
| 不定期的模型测试 | 云端 GPU | 在不同实验之间释放计算资源 |
| 突发式 API 推理 | 无服务器云GPU | 基于需求的扩展可能减少闲置计算资源 |
| 连续的大型语言模型推理 | 专用云与预留云的对比 | 高利用率可能会改变单位经济效益 |
| 短期的微调任务 | 云端 GPU | 临时使用合适的加速器 |
| 每天坚持训练 | 比较专用服务器与云服务 | 可预测的GPU小时数支持TCO建模 |
| 多GPU分布式训练 | 针对特定拓扑结构的评估 | 互连和网络在某些工作负载中占据主导地位 |
| 连续渲染 | 值得考虑的独立显卡 | 稳定的资源使用情况可能更适合固定容量 |
| 快速硬件实验 | 云端 GPU | 更便于评估不同的GPU型号 |
如何选择合适的GPU基础设施
在订购云端或专用 GPU 基础设施之前,请先回答以下问题。.
- 该工作负载是推理、训练、微调、渲染还是开发?
- 每月需要多少GPU小时?
- 预留容量中有多少百分比会产生有效功?
- 该模型需要多少GPU内存?
- 需要哪种 CUDA 或 ROCm 软件栈?
- 多GPU通信重要吗?
- 该工作负载是否需要低延迟?
- 工作能容忍被打断吗?
- 需要多少持久化存储空间?
- 数据传输有哪些要求?
- 新增产能必须在多快的时间内投入使用?
- 是否需要无限制的系统管理权限?
- 需要采取哪些备份和恢复措施?
- 是否有最低合同期限或设置费?
- 每完成一项任务或每百万代币的成本是多少?
如需更全面地了解硬件选型,请阅读我们的 GPU 与 CPU 服务器的对比.

云GPU与专用GPU:优缺点对比
云GPU的优势
- 无需购买硬件即可使用 GPU 计算资源
- 适用于临时性和不可预测的工作负载
- 可能更简便的GPU模型实验
- 按量计费和无服务器计费选项
- 有库存时可快速部署
- 灵活的实例扩展
云端 GPU 的限制
- 对于持续的工作负载,按小时计费可能会变得相当昂贵
- GPU 的供应情况因地区和产品而异
- 存储和网络费用可能会继续收取
- 无服务器冷启动可能会影响延迟
- 平台限制可能会影响系统控制
- 市场平台上的优惠在可靠性方面可能有所不同
专用GPU服务器的优势
- 直接访问专用物理基础设施
- 具有吸引力的经济效益,有助于实现持续利用
- 对操作系统和硬件的更强控制能力
- 可预测的物理资源分配
- 适用于特殊的存储和网络需求
- 适用于长时间运行的训练和推理
专用GPU服务器的限制
- Fixed capacity can be expensive when idle
- Hardware upgrades may require reprovisioning
- Provisioning can depend on physical inventory
- Some products have minimum commitments
- Server administration may require more expertise
- Scaling across multiple machines can add complexity
常见问题解答
Is cloud GPU cheaper than a dedicated GPU server?
Cloud GPU can be cheaper for intermittent workloads because compute may be released when not needed. Dedicated servers may become more economical for sustained, highly utilized workloads. The result depends on actual pricing and performance.
What is the difference between cloud GPU and dedicated GPU?
Cloud GPU describes a service delivery model, while dedicated GPU describes resource allocation. A cloud GPU instance can sometimes provide exclusive accelerator access without giving the customer an entire physical server.
When should I rent a dedicated GPU server?
Consider a dedicated server when GPU demand is predictable, utilization remains high, and hardware control or sustained performance is important.
Is a dedicated GPU server faster than cloud GPU?
Not necessarily. Performance depends on the accelerator model, allocation, power limits, software stack, storage, networking, and workload.
Is cloud GPU better for AI startups?
Cloud GPU may help startups avoid long-term infrastructure commitments while workloads are uncertain. Dedicated infrastructure may become attractive as usage stabilizes.
Which is better for LLM inference?
Serverless cloud GPUs can suit irregular traffic. Dedicated or reserved GPU capacity may suit continuously running inference services. Compare latency and cost per million tokens.
哪种更适合人工智能训练?
Cloud GPUs can suit short experiments, while dedicated servers may be competitive for repeated long-running jobs. Multi-GPU topology and storage performance are important.
What is GPU utilization?
GPU utilization commonly describes accelerator activity. For cost decisions, also measure the proportion of paid capacity used to produce useful results.
How do I calculate GPU break-even utilization?
Divide monthly dedicated server cost by the comparable cloud GPU price per productive hour. Adjust for performance differences and additional costs.
Can cloud GPUs scale automatically?
Some serverless services support automatic worker scaling. Standard GPU virtual machines may require separate orchestration and autoscaling configuration.
Can I use multiple GPUs on a dedicated server?
Yes, when the selected server supports multiple accelerators. Verify interconnect topology, power capacity, cooling, and software compatibility.
Are GPU marketplace instances reliable?
Reliability varies by host, hardware, and service tier. Review listing characteristics and interruption policies before deploying important workloads.
Does a dedicated GPU server require buying hardware?
No. Dedicated GPU servers can be rented from hosting providers. Purchasing and colocating hardware is a separate infrastructure model.
Does stopping a cloud GPU eliminate all charges?
Not always. Persistent storage, reserved commitments, or other retained resources may continue billing after compute stops.
Which providers offer cloud GPUs?
RunPod and Vast.ai are examples of providers offering cloud GPU services, although their deployment and billing models differ.
Which providers offer dedicated GPU servers?
Cherry Servers and GPU Mart advertise dedicated GPU server products. Custom infrastructure providers may also offer GPU configurations subject to quotation and availability.
Final Verdict: Cloud GPU or Dedicated GPU Server?
The best choice between cloud GPU and dedicated GPU server infrastructure depends on workload predictability, GPU utilization, hardware requirements, and total cost.
Cloud GPU platforms are particularly attractive for experimentation, intermittent inference, short training jobs, and applications that benefit from flexible access to different accelerators.
Dedicated GPU servers deserve consideration when AI workloads run consistently, hardware control matters, and high utilization makes fixed capacity economically attractive.
RunPod and Vast.ai provide different approaches to flexible GPU compute. Cherry Servers and GPU Mart offer dedicated GPU infrastructure, while ServerMania may be worth contacting for custom server requirements where appropriate hardware is available.
Do not select infrastructure solely from a GPU hourly rate or advertised specification.
Instead, benchmark the intended model, calculate useful output, include storage and networking charges, and estimate realistic monthly utilization.
AI WORKLOAD → GPU MEMORY → UTILIZATION → PERFORMANCE → DEPLOYMENT FLEXIBILITY → TOTAL COST → INFRASTRUCTURE DECISION
Always confirm current hardware inventory, GPU specifications, service terms, billing rules, and availability directly with the provider before purchasing.