训练大型语言模型不仅需要GPU的原始计算能力。内存容量、内存带宽、GPU间通信、存储吞吐量以及基础设施利用率都会影响训练任务的完成速度。.
该 NVIDIA H100 GPU 服务器 仍是企业级人工智能基础设施的重要基准。H100基于英伟达(NVIDIA)的Hopper架构打造,融合了高带宽内存、Transformer Engine加速技术以及先进的GPU互连技术,可满足高要求的机器学习工作负载需求。.
但租用 H100 并不一定就是最经济的选择。本评测将探讨其硬件性能、多 GPU 扩展能力以及租赁成本,以帮助 AI 团队选择合适的基础设施。.
编者注:GXCOM.NET 对已发布的技术规格和基础设施规划要点进行了评估。本次评测未进行任何独立的 H100 训练基准测试。.
NVIDIA H100 规格:SXM 与 PCIe 对比
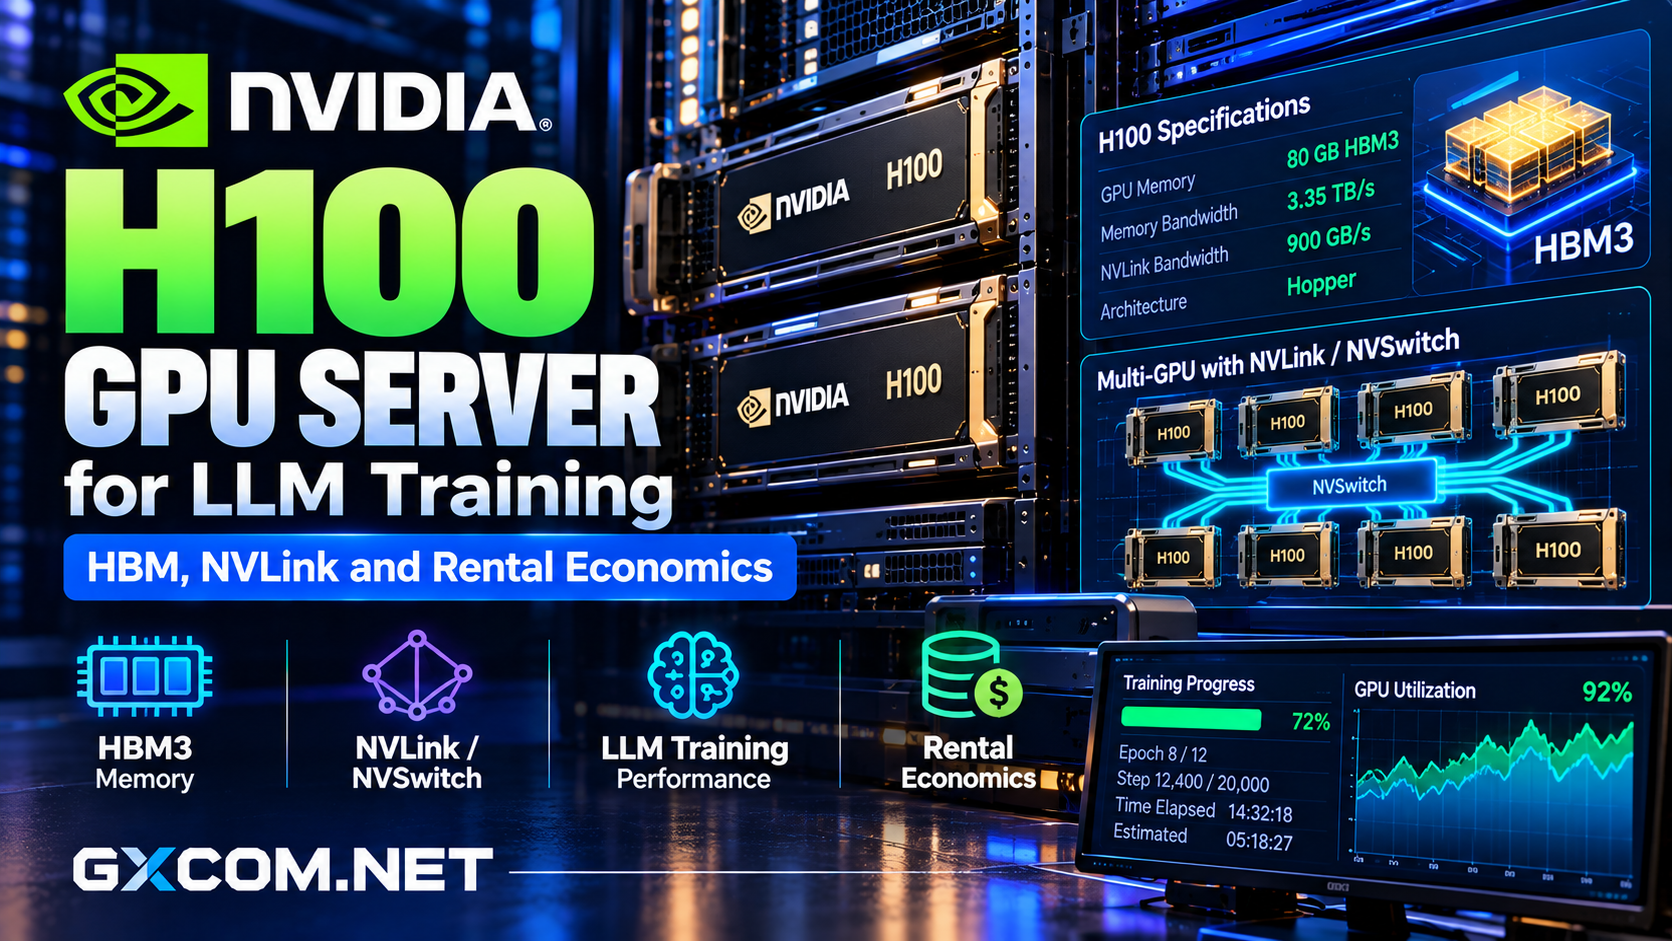
H100 提供多种配置,包括 SXM 和 PCIe 型号。虽然这两种标准版本均配备 80GB GPU 显存,但它们的带宽、功耗限制和连接方式各不相同。.
| 规格 | H100 SXM | H100 PCIe |
|---|---|---|
| GPU 内存 | 80GB HBM3 | 80GB HBM2e |
| 内存带宽 | 3.35TB/s | 2TB/s |
| NVLink 带宽 | 最高 900GB/s | 最高 600GB/s |
| 最大TDP | 最高700W | 最高350W |
这些数据代表英伟达公布的硬件规格,并非对应用程序性能的保证。实际结果取决于服务器设计、散热方案、软件以及工作负载配置。.
如需更全面的硬件对比,请浏览我们的 NVIDIA GPU 服务器供应商指南.
HBM为何对大型语言模型(LLM)的训练至关重要
高带宽内存是 H100 架构的一大优势。在训练过程中,模型参数、激活值、梯度以及优化器数据需要在内存与处理单元之间频繁传输。.
与 PCIe 配置相比,H100 SXM 提供了显著更高的内存带宽,这使其在内存密集型操作中极具吸引力。.
然而,80GB的显存并不意味着每个大型语言模型都能在单张GPU上完成全参数训练。全参数训练所需的内存可能远多于推理,因为优化器状态和梯度会增加工作占用空间。.
内存容量与带宽的对比
容量决定了GPU内存能容纳多少数据。带宽则影响处理器访问这些数据的速度。.

工作负载可能会受到上述任一因素的限制。量化、梯度检查点和参数高效方法虽然可以减轻内存压力,但也会带来额外的计算开销。.
在租用硬件之前,应估算该模型的完整训练内存需求,而不仅仅考虑参数数量。.
用于多GPU训练的NVLink和NVSwitch
大型语言模型的训练通常会将任务分配到多个加速器上。在分布式执行过程中,GPU 必须交换梯度、激活值或模型参数。.
NVIDIA 第四代 NVLink 可在支持该技术的 H100 GPU 之间实现高速通信。HGX H100 平台将 NVLink 与 NVSwitch 相结合,可在八个加速器之间提供互连能力。.
该架构可以缓解张量并行计算及其他分布式训练策略中的通信瓶颈。.
为什么 GPU 拓扑结构很重要
通过适当的 NVSwitch 互连架构连接的八个 GPU,并不等同于通过普通网络连接进行通信的八个独立 GPU。.
互连拓扑会影响集体操作,包括“全-归约”(all-reduce)操作,该操作用于在训练进程之间同步信息。.
在比较租赁方案时,请询问广告中提到的GPU是否位于同一台服务器上、是否启用了NVLink,以及多个节点之间是如何通信的。.
此外,还需验证节点之间的网络带宽。NVLink 可加速受支持的本地 GPU 通信,但不能替代合适的节点间网络架构。.
Transformer 引擎与 FP8 训练
H100 引入了 Transformer Engine 功能,旨在通过混合精度计算来加速适合的 Transformer 工作负载。.
与更高精度的格式相比,FP8 可以降低某些内存和计算需求,但能否成功部署取决于框架的支持和数值稳定性。.
在认定较低的精度也能产生可接受的结果之前,团队应先验证训练的收敛性、模型质量和可重复性。.
基于 PyTorch 的工作流和分布式训练框架,在适当配置的情况下,可以利用 Hopper 的加速功能。.
租用 H100 GPU 的费用是多少?
H100的租赁价格因GPU型号、服务商、地理位置、可用性以及部署是否使用共享云基础设施或预留容量而有所不同。.
RunPod 列出了 H100 PCIe 和 H100 SXM 的配置方案,为比较不同的部署需求提供了切实可行的起点。.
然而,仅凭每小时的租赁价格并不能确定最经济的培训方案。.
一个有用的公式是:
总训练成本 = GPU 小时数 × 每小时费率 + 存储 + 网络 + 运营费用
培训计算示例
假设8块GPU每小时的费用为$2.50(仅供示例)。一个100小时的训练任务在扣除其他费用之前,将产生$2,000的计算费用。.
如果因利用率低下导致作业时间延长至140小时,计算成本将上升至$2,800。.
这些数字仅为示例性假设,并非供应商报价或实际测得的培训绩效数据。.
相关的采购指标是每次完成的训练运行的成本,其中包括准备、检查点、失败和恢复。.
我们的 经济实惠的GPU服务器对比 探讨了其他成本因素。.
存储、网络和 GPU 利用率
即使是昂贵的加速器,在等待数据集、进行 CPU 预处理或写入检查点时,也可能处于闲置状态。.
训练基础设施应提供充足的系统内存、高速的 NVMe 存储、可靠的数据管道以及合适的网络连接。.
在升级硬件之前,请监控 GPU 利用率、内存占用、数据加载延迟以及训练吞吐量。.
检查点存储值得特别关注。大型分布式作业可能会生成大量中间文件,因此制定恢复计划至关重要。.
值得比较的H100主机服务商
RunPod:灵活的 H100 GPU 云平台
RunPod 提供了经过验证的 H100 租赁方案和基于容器的 GPU 部署工作流。对于需要进行实验、微调以及需要灵活计算资源的团队而言,这值得考虑。.
在开始更长时间的训练运行之前,请先检查存储的持久性、可用性以及集群配置。.
Vultr:企业级云 GPU 基础设施
Vultr 提供适用于企业级人工智能部署的GPU云基础设施。购买方应核实当前H100的可用性、加速器分配情况、部署区域以及网络规格。.

GPU Mart:专用GPU服务器的替代方案
GPU Mart 提供专用的GPU托管方案。请将该服务提供的加速器、VRAM、存储空间及租赁条款,与您工作负载对H100的要求进行对比。.
Cherry Servers:定制化裸机基础设施
Cherry 服务器 提供可配置的专用基础设施,用于处理人工智能工作负载。请确认是否有合适的 GPU 配置可用,而不是假设每台裸机服务器都配备了 H100 硬件。.
如需更多购买指南,请参阅我们的 AI GPU VPS 服务商对比 以及 裸机服务器提供商指南.
哪些人适合租用 NVIDIA H100?
H100 服务器最适合用于训练要求苛刻的变压器模型、运行分布式工作负载,或需要大量内存带宽和加速混合精度计算的团队。.
在低成本GPU上,规模较小的微调实验可能更具成本效益,尤其是当LoRA或QLoRA降低了内存需求时。.
购买前,请对具有代表性的工作负载进行基准测试,并将 H100 与现有的 A100、H200 或更新款的加速器进行对比。.
最终裁决
该 NVIDIA H100 GPU 服务器 它仍然是一个适合进行严肃的大语言模型(LLM)训练的强大平台,特别是在HBM带宽、Transformer Engine加速和NVLink连接具有重要价值的情况下。.
其经济价值取决于培训吞吐量、利用率、基础设施配置以及租赁条款。.
只有当工作负载确实需要其性能时,才应选择 H100,而不仅仅是因为它是一款广受认可的 AI 加速器。每次部署前,请先比较完成任务的总成本,再选择服务提供商。.