NVIDIA H100 GPU 服务器评测:用于大型语言模型(LLM)训练——HBM、NVLink 及租赁经济性
训练大型语言模型不仅需要GPU的原始计算能力。内存容量、内存带宽、GPU间通信、存储吞吐量以及基础设施利用率都会影响训练任务的完成速度。NVIDIA H100 GPU服务器……
AMD Instinct MI350 系列云端产品评测:ROCm 支持、GPU 内存与 AI 部署
本篇关于 AMD Instinct MI350 云服务的评测,重点探讨了 AMD Instinct MI350X、MI355X 和 MI350P 加速器、ROCm 软件兼容性、高带宽 GPU 内存、云服务可用性,以及在 AI 训练和推理方面的实际部署注意事项。AMD Instinct…
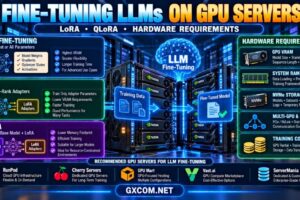
在 GPU 服务器上对大型语言模型进行微调:LoRA、QLoRA 及硬件要求
为大型语言模型(LLM)的微调选择合适的 GPU 基础设施,需要采取与普通 LLM 推理不同的方法。训练工作负载必须考虑模型权重、梯度、优化器状态、激活值、序列长度以及批量大小。由于……
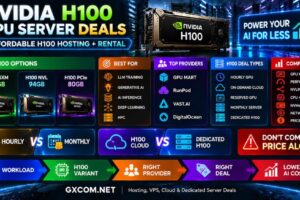
NVIDIA H100 GPU 服务器优惠:经济实惠的 H100 托管与租赁服务对比
NVIDIA H100 已成为在大语言模型、生成式人工智能、深度学习、AI 推理和高性能计算领域最广为人知的 GPU 之一。但 H100 基础设施成本高昂,而且一款性能优良的 H100……
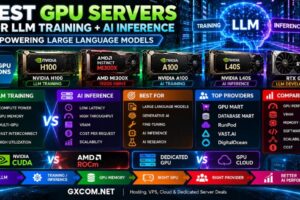
最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器
大型语言模型改变了组织对 GPU 基础设施的看法。训练、微调和部署现代 AI 模型可能需要海量的计算能力、GPU 内存、内存带宽、存储性能和网络容量……