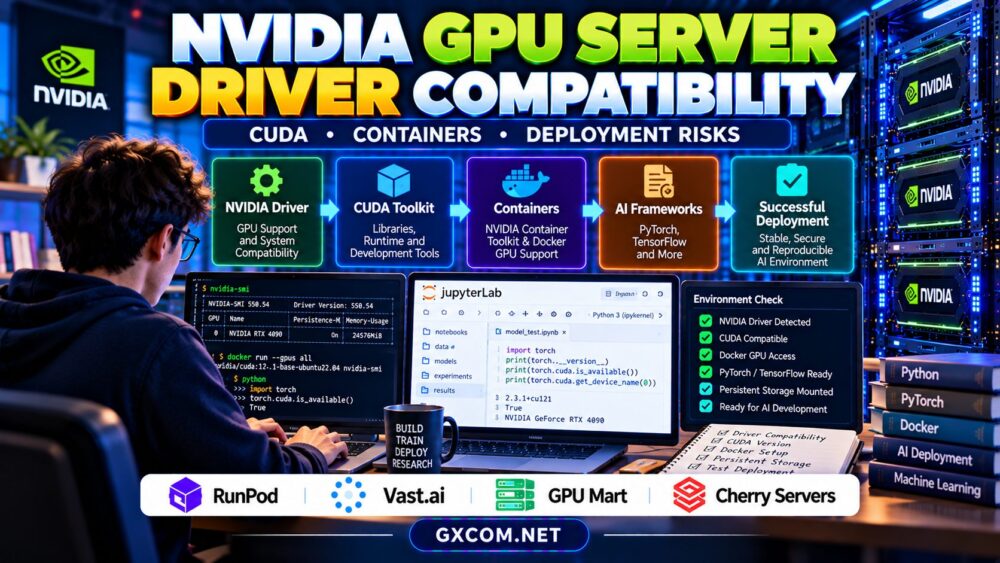
NVIDIA GPU 服务器驱动程序的兼容性对于可靠的人工智能训练、推理和容器化部署至关重要。如果驱动程序、CUDA 运行时、容器配置或机器学习框架存在兼容性问题,即使是最强大的 GPU 也无法正确运行您的工作负载。.
在将应用程序从一家GPU云服务商迁移到另一家、更新Docker镜像或部署新版AI框架时,这些问题经常会出现。在租用硬件之前了解兼容性,可以避免计算时间浪费、安装失败以及生产环境意外停机。.
NVIDIA 驱动程序与 CUDA 兼容性的工作原理
NVIDIA 驱动程序提供了操作系统与 GPU 硬件之间的接口。CUDA 应用程序还依赖于兼容的运行时库,而开发人员可以安装 CUDA 工具包来进行编译和调试。.
重要的是,由 nvidia-smi 表示已安装驱动程序支持的最高 CUDA 版本,但不一定就是服务器上安装的 CUDA 工具包的版本。.
较新的驱动程序通常支持使用旧版 CUDA 工具包构建的应用程序,但须遵守 NVIDIA 的兼容性规则。某些较新的 CUDA 应用程序可在特定兼容性机制下与旧版驱动程序配合运行,但这些例外情况存在一定限制。.
请务必查阅 NVIDIA 的官方兼容性文档,以确认具体的工具包、驱动程序分支、GPU 架构和应用程序要求。.
安装人工智能软件前请检查显卡驱动程序
首先,请确认操作系统能否检测到 GPU,以及驱动程序是否正常工作。在受支持的 NVIDIA Linux 系统上,请运行以下命令:
nvidia-smi请核对 GPU 名称、驱动程序版本、内存容量以及报告的 CUDA 兼容性级别。然后检查您所安装的 PyTorch、TensorFlow 或推理框架的具体要求。.
如果已安装 CUDA 工具包,, nvcc --version 可以报告其编译器版本。不过,许多推理环境并不要求在系统范围内安装 CUDA 工具包。.
如需更广泛的硬件选择,请参阅我们的 NVIDIA GPU服务器供应商对比.
Docker GPU 容器与 NVIDIA 容器工具包
Docker 容器可以打包应用程序的依赖项,但仍需依赖兼容的主机 GPU 驱动程序。容器镜像无法独立替换内核级 NVIDIA 驱动程序。.
在受支持的 Linux 主机上,NVIDIA Container Toolkit 可使兼容的容器运行时将 GPU 设备和所需的驱动程序接口暴露给容器。.
配置好工具包和 Docker 运行时后,一个基本的验证命令是:
docker run --rm --gpus all \
  nvidia/cuda:12.4.1-base-ubuntu22.04 \
  nvidia-smi
此示例使用了一个特定的 CUDA 容器标签;在执行之前,请确认该镜像仍可使用且与您的主机驱动程序匹配。.

如果 Docker 无法访问 GPU,请检查运行时配置、设备权限、驱动程序状态,以及宿主产品是否支持启用 GPU 的容器。.
常见的 CUDA 和 GPU 部署错误
| 问题 | 可能的原因 | 推荐检查 |
|---|---|---|
| CUDA 驱动程序不足 | 驾驶员年龄超限,不符合申请条件 | 驱动程序和运行时要求 |
| 没有可用的 CUDA 设备 | 应用程序无法访问 GPU | 设备可见性与权限 |
| Docker GPU 错误 | 容器运行时配置错误 | NVIDIA 容器工具包 |
| 不支持的 GPU 架构 | 缺少兼容内核 | 框架构建与 GPU 支持 |
| 内存不足 | VRAM 不足 | 模型大小和批处理设置 |
不要将每个 CUDA 故障都归咎于驱动程序问题。内存耗尽、不受支持的架构以及不正确的框架包都需要不同的解决方案。.
我们的 大型语言模型(LLM)推理对GPU显存的要求 本指南介绍了内存限制如何影响部署。.
GPU VPS、直通和驱动程序控制
驱动程序的管理取决于托管架构。专用 GPU 服务器可能允许直接控制操作系统和驱动程序,而托管容器通常依赖于服务商维护的驱动程序。.
GPU 直通、虚拟 GPU 技术以及共享容器访问具有不同的兼容性和隔离特性。.
购买前,请确认您是否可以选择驱动程序、安装自定义内核、重启环境以及使用特权容器功能。.
我们的 GPU VPS 与专用 GPU 服务器对比指南 对这些部署模式进行了比较。.
四家经批准的GPU托管服务提供商供评估
RunPod:基于容器的 AI 部署
RunPod 这对使用 GPU 容器和 AI 工作负载的开发人员具有参考价值。请评估可用的部署类型、支持的镜像、GPU 规格以及主机级驱动程序管理的限制。.
对于托管环境,请确认您的应用程序镜像与提供商底层 GPU 软件堆栈之间的兼容性。.
Vast.ai:Marketplace 的 GPU 配置
Vast.ai 通过市场上的单个商品列表提供GPU租赁服务。由于硬件和主机环境可能各不相同,因此配置验证尤为重要。.
在运行对生产环境至关重要的工作负载之前,请检查所选的 GPU、支持的容器环境、驱动程序兼容性、存储以及可靠性。.
GPU Mart:持久化 GPU 服务器环境
GPU Mart 当项目需要使用寿命更长的 GPU 基础设施,且可能需要对开发环境进行更精细的控制时,值得对此进行评估。.
在选择配置之前,请确认操作系统访问权限、驱动程序安装权限、支持的加速器以及恢复选项。.
Cherry 服务器:专用基础设施要求
Cherry 服务器 是一家经批准的基础设施提供商,可作为专用部署需求的备选方案。请确认目前是否有合适的配备GPU的产品可供选择。.
在评估专用硬件时,请索取有关支持的驱动程序、远程管理、配置和恢复流程的信息。.
部署风险与驱动程序升级规划
更新驱动程序可以解决兼容性问题,但未经控制的升级可能会中断正在运行的工作负载,或导致功能退化。.
维护一份经过测试的软件清单,其中应包含 GPU 型号、驱动程序版本、容器镜像摘要、框架版本以及应用程序依赖项。.
在投入生产环境之前,先在预发布环境中测试升级。保留配置文件,并制定适合操作系统和托管平台的回滚流程。.
有关实用的远程开发工作流,请参阅我们的 用于远程人工智能开发的 GPU VPS 指南.
兼容性问题如何推高GPU成本
部署失败会消耗工程时间,并可能产生需计费的 GPU 时长。反复下载容器、重建环境以及存储保留都会增加开支。.
例如,假设每GPU小时的费用为$0.80,浪费的6小时将产生$4.80的计算费用,其中不包括存储和工程工作量。.

在启动成本高昂的训练任务之前,请使用经过验证的容器镜像、自动环境检查以及短时测试运行。.
比较适用于 AI 部署的 NVIDIA GPU 托管服务
在选择下一台GPU服务器之前,请检查驱动程序兼容性、CUDA要求、容器支持、GPU内存以及管理员访问权限。.
常见问题解答
nvidia-smi 中显示的 CUDA 版本是否意味着已安装 CUDA?
不。这表示驱动程序支持的 CUDA 兼容性级别。可能尚未安装 CUDA 工具包和编译器。.
Docker 容器可以使用不同的 CUDA 版本吗?
是的,只要主机驱动程序和硬件满足相关要求,兼容的容器可以包含不同的 CUDA 用户空间库。.
我应该总是安装最新的NVIDIA驱动程序吗?
不一定。请选择一个受支持的驱动程序,该驱动程序既要满足您的应用需求,又要经过您部署环境的测试。.
最终裁决
在进行生产环境部署或签订长期托管协议之前,应验证 NVIDIA GPU 服务器驱动程序的兼容性。请进行比较 RunPod, Vast.ai, GPU Mart, ,并已验证 Cherry 服务器 基于 CUDA 支持、容器兼容性、管理控制和恢复选项的配置。一个经过测试的环境,比那些无法可靠运行您的应用程序、但硬件规格却非常惊人的配置更有价值。.