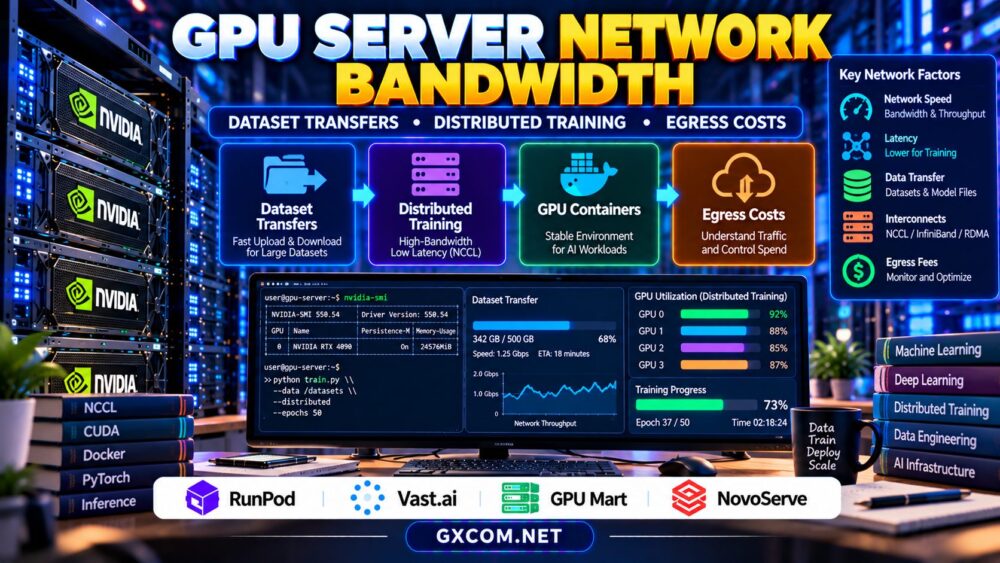
GPU服务器的网络带宽决定了昂贵的人工智能加速器是将时间用于处理数据,还是用于等待数据传入。对于机器学习团队而言,网络性能会影响数据集传输、分布式训练、模型部署以及GPU托管总成本。.
然而,宣传的端口速度并不能说明全部情况。实际吞吐量取决于存储性能、网络拥塞、地理距离、传输协议以及服务提供商的政策。本指南将介绍在决定采用云基础设施或专用基础设施之前,如何评估 GPU 网络性能。.
为什么GPU服务器的网络带宽很重要
现代人工智能工作负载通常需要在对象存储、训练服务器和推理环境之间传输大量数据集。如果数据传输速度过慢,即使是性能强大的GPU也可能无法充分发挥其潜力。.
网络要求因工作负载而异。单个推理服务器可能主要用于接收请求并返回结果。而训练集群则可能持续交换梯度、检查点和数据集分片。.
首先,将流量分为三类:传入数据集、计算节点之间的通信,以及传出的模型产出或推理结果。每类流量可能有不同的性能要求和计费规则。.
带宽、吞吐量与延迟
带宽指连接的理论数据传输能力。吞吐量衡量实际传输的有效数据量,而延迟则指通信延迟。.
10 Gbps 端口并不能保证持续以 10 Gbps 的速率进行数据传输。共享基础设施、存储限制、协议开销以及远程端点的带宽容量都可能导致实际性能下降。.
当分布式应用程序反复同步小消息时,延迟就显得尤为重要。仅靠高带宽并不能消除通信延迟。.
如需了解相关的存储规划,请阅读我们的 GPU服务器存储需求指南.
传输一个大型数据集需要多长时间?
一个有用的估计值是:
传输时间(单位:秒)= 数据集大小(单位:比特)÷ 有效吞吐量(单位:比特/秒)。.
假设有一个500 GB的数据集,通过一条有效吞吐量为1 Gbps的连接进行传输。采用十进制单位计算,理论上的传输时间约为4,000秒,即67分钟。.
在 5 Gbps 的有效吞吐量下,处理同一数据集大约需要 13 分钟。这些估算未考虑额外的处理、重试及其他延迟。.
对于重复进行的实验,将数据集缓存到 GPU 工作节点附近可以减少不必要的数据传输。在升级任一资源之前,请先比较网络吞吐量与本地 NVMe 读取速度。.
分布式 GPU 训练:网络技术改变一切
分布式训练引入了超出普通数据集下载范围的通信需求。在训练过程中,多个 GPU 或服务器可能会交换梯度并协调模型更新。.
使用 NVIDIA NCCL 等集体通信库的框架可以从适当的高性能网络中获益。根据硬件和配置的不同,包括 RDMA 和 InfiniBand 在内的技术可能会降低通信开销。.

然而,同一台服务器内部的GPU间通信与不同机器之间的通信有所不同。即使支持PCIe和NVLink,它们也不能替代服务器间网络。.
在租用多节点集群之前,请核实拓扑结构、可用的互连方式、支持的软件,以及服务提供商是否允许采用所需的网络配置。.
GPU 云出站流量费用的说明
“入站”指传入的数据,而“出站”通常指传出的流量。服务提供商可能会对互联网数据传输、跨区域流量以及私有网络通信采取不同的计费方式。.
切勿以为“无限带宽”就意味着“无限免费数据传输”。某些套餐可能包含固定的流量配额、端口速度限制或额外使用费。.
例如,假设某个项目每月向外部传输 3 TB 数据,而某家假设的供应商在 1 TB 免费用量之后,按每 GB $0.05 收费。采用十进制单位计算,额外的 2,000 GB 费用为 $100。.
这仅为示例性计算,并非服务提供商报价。请务必仔细核对实际计费条款、包含的流量以及针对特定目的地的规则。.
我们的 GPU 云服务空闲费用指南 解释了在非活跃计算时间外可能产生的额外费用。.
GPU托管服务商:需要比较的网络因素
以下经批准的服务提供商提供不同的基础设施方案。将其列入此列表并不意味着当前可提供带宽保证、网络定价或GPU库存。.
| 服务提供商 | 潜在应用场景 | 网络问题 |
|---|---|---|
| RunPod | AI 训练和推理工作负载 | 存储迁移、区域互连、数据输出规则 |
| Vast.ai | 灵活的GPU市场租赁服务 | 主机特异性吞吐量和连通性 |
| GPU Mart | 持久化 GPU 服务器环境 | 端口速度、流量配额、远程存储 |
| NovoServe | 专用基础设施评估 | GPU可用性、网络容量、传输策略 |
RunPod:评估 GPU 和存储的连接性
RunPod 可能适合部署容器化人工智能应用程序和训练工作负载的团队。在选择环境之前,请比较可用的位置、存储选项、数据迁移要求以及适用的传输费用。.
如需了解更全面的采购背景,请参阅我们的 RunPod GPU 云服务评测.
Vast.ai:检查单个主机的状态
Vast.ai 该平台采用市场模式,因此不同列表的网络特性可能有所不同。在评估GPU规格的同时,还应评估主机位置、可用网络连接、可靠性以及数据集访问情况。.
在处理长时间运行的工作负载之前,请先测试代表性数据传输。.
GPU Mart:考虑持久化数据工作流
GPU Mart 在评估持久性 GPU 服务器环境时,这一点至关重要。请咨询网络端口容量、包含的传输配额、存储连接性以及管理访问权限等相关信息。.
持久化数据集可以减少重复下载,尽管存储成本和备份责任仍然很重要。.
NovoServe:专用网络基础设施
NovoServe 当网络控制是主要需求时,这是一家值得考虑的经认证的专用基础设施提供商。在将任何服务视为GPU训练解决方案之前,请先确认是否有合适的GPU硬件可用。.
请提供关于带宽承诺、流量政策及支持的网络配置的书面说明。.
如何测试 GPU 服务器的网络性能
应采用受控测量方法,而不是完全依赖广告宣传的规格参数。诸如 iperf3 之类的工具可帮助测量您控制且有权进行测试的端点之间的吞吐量。.
在真实工作负载条件下,测量数据集的下载速度、存储读取性能、延迟以及持续传输表现。.
对于分布式训练,需监控 GPU 利用率和通信时间。如果 CPU 预处理或存储仍是实际瓶颈,那么网络速度的提升所带来的好处是有限的。.
我们的 大学研究实验室专用GPU服务器指南 讨论了共享工作负载和基础设施规划。.
GPU 网络采购检查清单
购买前,请确认广告中标明的端口速度、预期吞吐量、包含的月流量、出站速率、区域间传输费用、存储位置以及任何高性能互连要求。.

此外,还应核实带宽是否为共享的、流量是否按量计费,以及网络使用情况在账单上如何体现。若合同条款存在歧义,应要求对方提供书面说明。.
比较 GPU 托管服务:超越 GPU 规格
在选择 GPU 基础设施之前,请评估网络性能、存储连接性、数据传输配额以及总运营成本。.
常见问题解答
1 Gbps 是否足以满足 GPU 训练的需求?
对于一些数据集在本地缓存的单节点工作负载而言,这可能已经足够。而大型分布式训练任务可能需要截然不同的网络能力。.
10 Gbps 的 GPU 服务器能否保证训练速度更快?
不。训练速度还取决于 GPU 利用率、存储吞吐量、预处理以及通信模式。.
GPU 云数据传输是免费的吗?
不一定。转账手续费和费用因服务商、地区、目的地及服务类型而异。.
最终裁决
合适的 GPU 服务器网络带宽取决于数据如何进入、在您的 AI 基础设施中传输以及如何离开该基础设施。进行比较 RunPod, Vast.ai, GPU Mart, ,并已验证 NovoServe 根据测得的吞吐量、存储局部性、分布式训练需求以及总传输成本来设计配置。与选择宣传速度最快的网络端口相比,均衡的基础设施方案通常能带来更好的性价比。.