在规划人工智能训练、微调或推理基础设施时,人们很容易低估 GPU 服务器的存储需求。如果数据集加载缓慢、模型检查点占满磁盘,或者临时文件耗尽可用存储空间,那么即使配备了性能强大的 NVIDIA GPU,也无法充分发挥其潜力。.
选择合适的 NVMe 容量,不仅仅是简单地将各型号的容量相加。您还必须考虑数据集副本、预处理、训练检查点、容器镜像、缓存以及持久化存储费用。本指南将详细说明如何确定 GPU 服务器存储的容量、识别性能瓶颈,并在不超支的情况下比较各种托管方案。.
GPU 服务器需要多少存储空间?
存储需求取决于工作负载类型、数据集大小、模型架构以及数据保留策略。推理服务器除模型权重和应用程序文件外,可能只需相对较少的存储空间,而训练系统则可能需要大型数据集的多份副本。.
一个实用的起始公式是:
所需存储空间 = 数据集 + 处理后的数据 + 模型文件 + 检查点 + 临时工作区 + 操作系统 + 空闲空间预留。.
例如,一个训练项目可能需要 400 GB 的原始数据、250 GB 的处理后数据、100 GB 的模型文件、300 GB 的检查点以及 100 GB 的临时工作区。 加上 100 GB 的操作系统和工具空间,总计达到 1.25 TB,这还不包括额外的预留空间。.
在这个假设的情景中,一个 2 TB 的 NVMe 卷比一个几乎已满的 1 TB 配置提供了更大的灵活性。.
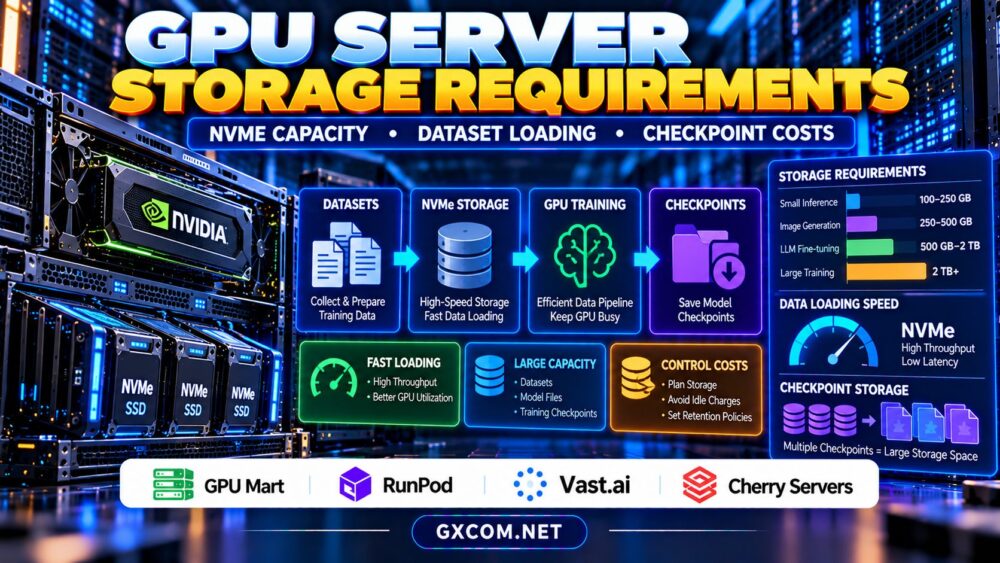
根据 GPU 工作负载推荐的 NVMe 容量
| 工作量 | 规划能力 | 主要存储问题 |
|---|---|---|
| 小型模型推理 | 100–250 GB | 模型文件和容器 |
| AI图像生成 | 250–500 GB | 检查点、扩展、输出 |
| LLM微调 | 500 GB–2 TB | 数据集和检查点保留 |
| 大规模培训 | 2 TB 或更多 | 数据管道和重复检查点 |
这些范围仅为示例性的规划类别,并非通用的最低标准。大型模型、多模态数据集或庞大的实验历史数据可能远超这些范围。.
请务必根据实际文件来计算容量,而不是仅凭广告中宣传的GPU型号来选择套餐。.
为什么 NVMe 存储对 GPU 性能至关重要
NVMe 固态存储可提供高吞吐量和低延迟,但实际性能取决于存储设备、接口、文件系统、资源竞争以及运行环境。.
训练管道会反复加载样本、解码文件、应用变换并准备批次。如果这些操作无法足够快地提供数据,昂贵的 GPU 可能会处于空闲等待状态。.
对于大文件而言,顺序吞吐量至关重要;而当数据集包含数百万个较小对象时,随机I/O和元数据性能则变得尤为重要。.
请同时监控 GPU 利用率、磁盘吞吐量、CPU 使用率以及数据加载器等待时间。GPU 利用率较低并不一定意味着存储性能不足。.

数据集加载:本地 NVMe 与网络存储
本地 NVMe 存储可以减少重复的网络传输,并提升对常用数据集的访问效率。不过,这种存储可能是临时性的,可能与某台机器绑定,或者在实例终止时丢失。.
网络附加存储具有多种优势,包括共享访问和更便捷的数据持久化。其性能取决于网络带宽、存储架构以及并发工作负载。.
一种切实可行的方法是,将持久的源数据集单独保存,并在执行前将频繁访问的训练数据复制到本地 NVMe 上。.
对于分布式工作负载,请参阅我们的 NVIDIA AI GPU 服务器指南 在比较加速器基础设施和部署要求时。.
训练检查点需要多少空间?
检查点的大小取决于训练过程保存的内容。仅模型权重所占的空间,可能远小于包含优化器参数、梯度以及调度器信息的完整训练状态。.
假设有一个占用40 GB空间的训练检查点。保留十个版本大约需要400 GB空间,这还不包括临时文件和其他生成文件。.
频繁保存检查点可以增加恢复选项,但无限期保留每个版本会增加存储占用。.
请采用能够保留近期检查点、重要里程碑和经过验证的恢复点的保留策略。在删除较旧的副本之前,请先测试恢复流程。.
持久化存储与隐藏的 GPU 托管成本
GPU 计算和存储费用并不总是合并计费。已停止的实例可能不再产生活跃计算费用,但持久卷、快照或预留资源仍会继续产生费用。.
举例来说,如果以每GB-月$0.08的假设费率存储1 TB数据,且计费单位为1,000 GB,则每月费用约为$80。.
实际费用取决于服务商的存储单元、计费模式以及所选产品。.
我们的 GPU 云服务空闲费用指南 解释了为何已停止的实例和保留的存储空间会影响您的总账单金额。.
四家经过认证的GPU托管服务商对比
GPU Mart:持久化 GPU 服务器要求
GPU Mart 对于需要更长久运行的 GPU 环境的工作负载,值得对此进行评估。请比较可用的存储容量、磁盘类型、扩展选项、GPU 分配以及备份方案。.
请确认关机后存储空间是否仍可用,以及额外容量的计费方式。.
RunPod:GPU 计算与数据持久化
RunPod 这对于 AI 开发、训练实验和推理部署都至关重要。请评估与您所选部署类型相关的存储选项,包括数据持久化和生命周期行为。.
请阅读我们的 RunPod GPU 云服务评测 以获取有关该服务提供商的更多背景信息。.
Vast.ai:比较 GPU 市场上的配置
Vast.ai 这可能对正在比较不同硬件和存储特性的GPU租赁方案的团队具有吸引力。各条目在可用磁盘空间、网络连接和运行可靠性方面可能有所不同。.
在下载大型数据集之前,请先检查存储限制,并为重要的检查点保留独立备份。.
Cherry Servers:专用基础设施评估
Cherry 服务器 在比较专用服务器需求时,这也是另一家值得考虑的经认证的基础设施提供商。请确认其目前是否提供合适的配备GPU的配置与NVMe存储的组合。.
专用基础设施虽能提供更强的配置控制能力,但在采购决策时仍应综合考虑资源配置条款和总体运营成本。.
如何降低 GPU 存储成本
删除过时的临时文件,对数据集进行去重,并避免保留不必要的容器镜像。对适当的构建产物进行压缩,并在可行的情况下,将访问频率较低的检查点迁移到成本较低的存储中。.
将持久化数据与临时计算环境分离。这样可以更轻松地替换 GPU 实例,同时不会丢失重要的项目文件。.
对于更广泛的基础设施预算编制,请比较 经济实惠的 GPU 服务器选项 在确定长期配置之前。.
GPU 服务器存储采购检查清单
下单前,请计算磁盘峰值使用量,而非平均使用量。请确认 NVMe 容量、实测吞吐量、持久化存储行为、备份策略以及扩展选项。.

请询问:本地磁盘在删除实例后是否会保留、是否可以挂载额外的卷,以及数据集的出站传输是否会产生额外费用。.
存储要求还取决于部署模式。我们的 GPU VPS 与专用 GPU 服务器的对比 解释了资源配置方面的重要差异。.
比较配备合适 NVMe 存储的 GPU 服务器
在选择下一台 AI 服务器之前,请评估 GPU 性能、可用磁盘容量、数据持久性以及检查点存储成本。.
常见问题解答
对于一台AI GPU服务器来说,500 GB的存储空间够用吗?
对于较小的推理或图像生成项目,这可能已经足够。而大型数据集和反复使用的训练检查点则可能需要大得多的容量。.
NVMe 存储能加快 GPU 训练速度吗?
当数据加载成为瓶颈时,这可以提升性能。如果计算、预处理或网络传输占主导地位,那么更快的存储可能带来的好处有限。.
检查点应该使用本地存储还是持久化存储?
本地存储可支持快速的检查点写入,而持久化存储则能保护重要的恢复数据。将两者结合使用可为许多工作流带来益处。.
最终裁决
在计算 GPU 服务器的存储需求时,应同时考虑 GPU 内存和计算性能。根据数据集、检查点、临时文件以及未来增长需求来确定 NVMe 容量。进行比较 GPU Mart, RunPod, Vast.ai, ,并已验证 Cherry 服务器 基于实际存储性能、持久化策略和总托管成本的配置方案。.