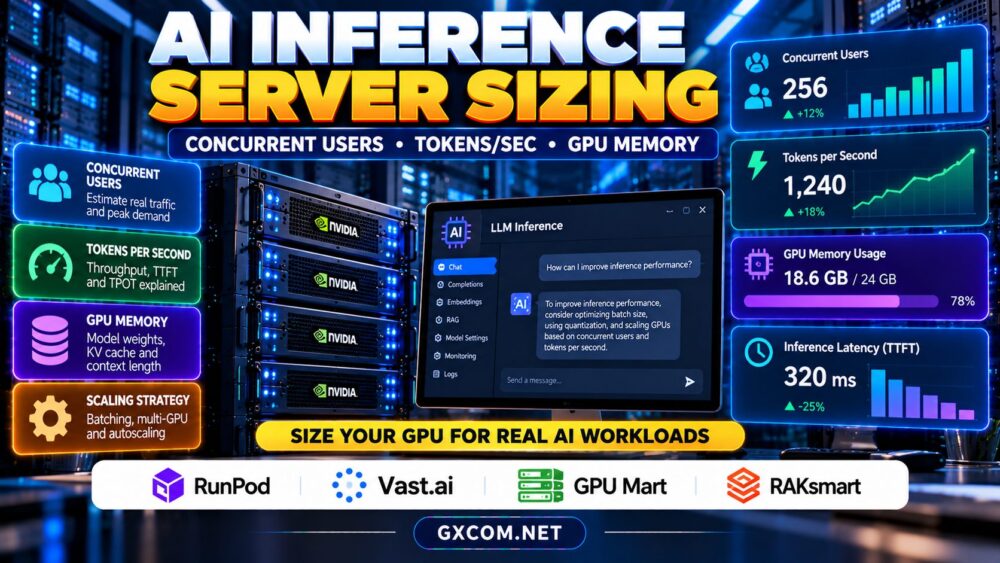
AI推理服务器的规格规划应以用户期望的体验为出发点,而非您想要租用的GPU型号。处理偶尔出现的问题的聊天机器人,其配置需求与需要处理数百个并发请求的API截然不同。并发用户数、每秒令牌数、上下文长度以及GPU内存,共同决定了部署环境在高负载下能否保持响应能力。.
本指南将说明如何将应用程序需求转化为可量化的性能目标、模拟实际流量,以及在评估托管方案时,不盲目认为配置最高的 GPU 一定能提供最佳性价比。.
1. 在选择硬件之前,先确定工作负载
请记录您的模型、精度、典型输入长度、预期输出长度以及延迟目标。将交互式聊天与离线批处理区分开来:聊天用户会注意到第一个令牌出现前的延迟,而批处理任务通常更重视总吞吐量。应确定每秒请求峰值,而不是依赖注册用户数量。.
例如,1,000名注册用户并不意味着有1,000个并发生成任务。请测量在高峰期实际有多少请求是重叠的。在估算端到端响应时间时,请将检索、工具调用和提示词构建都纳入考虑范围。.
2. 了解每秒令牌数和延迟
有两个关键指标:首次生成令牌所需时间(TTFT)和每个输出令牌所需时间(TPOT)。TTFT 包括排队和提示词处理;TPOT 则反映了首个令牌出现后的生成速度。当请求在队列中等待时间过长时,用户可能会觉得一个总吞吐量很高的系统运行得很慢。.
请区分单次请求的生成速度与所有活跃请求的总输出吞吐量。一台服务器每秒总共生成400个输出令牌,并不一定意味着它能向每位用户每秒交付400个令牌。性能会随着批量大小、输入长度、输出长度以及推理引擎设置的变化而变化。.
应在具有代表性的流量条件下测量 p50 和 p95 延迟,而不仅仅是孤立的基准测试。容量决策应确保在需求激增时仍能保障尾部延迟。.
3. 估算并发请求数和所需吞吐量
首先考虑峰值到达率和平均生成时长。作为规划上的近似,平均活跃请求数等于每秒到达的请求数乘以平均请求时长。如果每秒到达两个请求,且生成时长为八秒,则在稳定条件下预计会有大约16个活跃请求。.
接下来估算输出需求。如果这两个请求各自生成 200 个令牌,那么该工作负载平均每秒需要约 400 个输出令牌,其中不包括突发处理余量。这只是一个示例性计算,并不保证任何特定的 GPU 都能达到这一要求。.
运行一项负载测试,以模拟实际环境中短提示和长提示的混合情况。为不可预见的请求到达、部署操作和硬件故障预留容量余量。队列长度和 p95 TTFT 应作为触发扩展决策的指标,以避免客户遭遇大范围超时。.

4. 计算模型权重之外的 GPU 内存
GPU VRAM 必须存储的不仅是模型参数。还需预留空间用于模型权重、KV 缓存、运行时工作区、临时激活值以及框架开销。量化可以减少权重占用的内存,但无法消除并发序列和长上下文所占用的内存。.
KV缓存的使用量会随着活跃令牌数量的增加而增长,并取决于模型架构和实现方式。即使模型加载成功,过长的提示词、较大的批量大小以及较长的对话也可能耗尽内存。应同时测试最大上下文长度和并发数,而非分别测试。.
多GPU推理可以分散模型权重或工作负载,但互连性能和软件支持会影响结果。有关相关硬件规划,请参阅我们的 NVIDIA AI GPU 服务器指南.
5. 连续批处理和缩放选项
连续批处理使推理引擎能够动态地接收并完成请求,与处理固定批次相比,这通常能提高利用率。然而,吞吐量的提升可能会与延迟目标产生冲突,尤其是在许多长序列共享内存的情况下。.
垂直扩展是在单个部署中增加 GPU 内存或计算能力。水平扩展则是增加副本,这需要路由、健康检查、模型加载,以及足够的容量来容纳发生故障的实例。自动扩展还存在冷启动成本:下载大型模型文件并预热新副本可能需要一定时间。.
将这些选项与我们的 GPU 与 CPU 服务器的对比 在评估您的工作负载是否需要加速时。.
6. 对比四家经过认证的GPU托管服务商
RunPod:灵活的 GPU 部署
RunPod 这对于测试托管式 GPU 推理和部署工作流的团队具有参考价值。请评估所选产品的 GPU 可用性、持久化存储、网络费用、启动行为以及管理模式。在预测生产环境容量之前,请先核实实际配置。.
Vast.ai:基于市场平台的GPU算力
Vast.ai 可用于价格敏感型实验和容量测试的评估。请对比各方案在 GPU 规格、可靠性特性、存储、连接性以及主机特定条件方面的差异。市场上的产品列表并非因为宣传的是同一款 GPU 就能互换使用。.
GPU Mart:持久化 GPU 服务器选项
GPU Mart 当项目需要持续使用的GPU资源或更传统的服务器环境时,这也是另一种选择。请查看可用的GPU型号、内存、管理责任、操作系统支持以及升级选项。.
RAKsmart:基础设施采购对比
RAKsmart 这可能与专用基础设施的评估相关。请确认当前是否提供合适的 GPU 配置,以及其位置、库存、部署时间和支持范围。请勿将通用专用服务器的列表视为 GPU 可用性的证明。.
如需了解现有服务提供商的具体情况,请参阅我们的 Vultr NVIDIA GPU 云服务分析 作为额外的编辑背景,而非替代对这四个选项的测试。.
7. 模型的月度推断成本
将月度支出估算为活跃 GPU 小时数乘以有效小时费率,再加上存储、带宽、备份以及任何平台费用。对于始终在线的部署,应将全天候运行小时数与开发和测试小时数分开计算。对于需求波动的情况,需对空闲期和副本启动延迟进行建模。.
每百万输出代币的成本只有在基准测试能反映您的提示词组合、并发量和延迟目标时才有参考价值。一台价格较低但利用率低的 GPU,其每完成一次请求的成本可能更高。在总成本比较中,应将工程人力成本和故障恢复成本一并考虑在内。.
我们的 经济实惠的GPU服务器指南 提供了额外的采购背景信息,而 AI GPU VPS 服务商对比 有助于评估规模较小的部署方案。.
8. 一份实用的尺寸选择清单
从一个代表性部署开始,在多个并发级别下对实际提示进行基准测试。记录TTFT、输出吞吐量、p95延迟、VRAM使用量、错误率和每小时成本。逐步增加负载,直到无法达到服务级别目标,然后确定是计算、内存还是队列是限制因素。.

在更改量化、上下文限制、批处理设置或模型版本后,请重复进行测试。预留空间以应对流量突发和故障转移。只有这样,才能选择生产方案,并记录何时进行扩展或迁移。.
AI 推理服务器配置常见问题解答
一块GPU最多能支持多少个用户?
没有一个放之四海皆准的数值。模型规模、上下文、生成长度、分批处理以及延迟要求共同决定了处理能力。.
VRAM 越大,推理速度就一定越快吗?
不。VRAM 虽然能支持更大的模型和批量,但计算能力、内存带宽和软件效率同样重要。.
我应该根据平均流量还是峰值流量来规划容量?
在制定峰值基准方案并保留合理的冗余空间的同时,利用实际测得的需求量来避免不必要的闲置产能。.
最终裁决
AI 推理服务器的规格规划需要考虑测得的并发量、每位用户的延迟、总令牌吞吐量以及 GPU 内存余量。进行比较 RunPod, Vast.ai, GPU Mart, ,以及 RAKsmart 在相同的工作负载和运营要求下。应购买能够满足既定服务目标的算力,而不是仅依赖GPU的标称规格。.