人工智能工作负载的规模日益扩大,要求日益提高,运行成本也越来越高。在选定 NVIDIA GPU(例如 H100、A100 或 L40S)之后,还需做出另一个重要决策:是将其部署在专用 GPU 服务器上,还是从云端租用 GPU 资源?
该 NVIDIA GPU 服务器与 GPU 云的对比 这一决策将对性能、可扩展性、基础设施控制以及人工智能的总体计算成本产生重大影响。.
专用的 NVIDIA GPU 服务器可提供可预测的硬件资源和更强的控制力,而 GPU 云基础设施则具备快速部署、灵活扩展以及按使用量计费等优势。这两种方案都并非对每个 AI 项目都自动更优。.
本指南对比了专用的 NVIDIA GPU 服务器与 GPU 云平台在人工智能训练、大型语言模型、推理、机器学习以及其他 GPU 密集型工作负载方面的表现。.
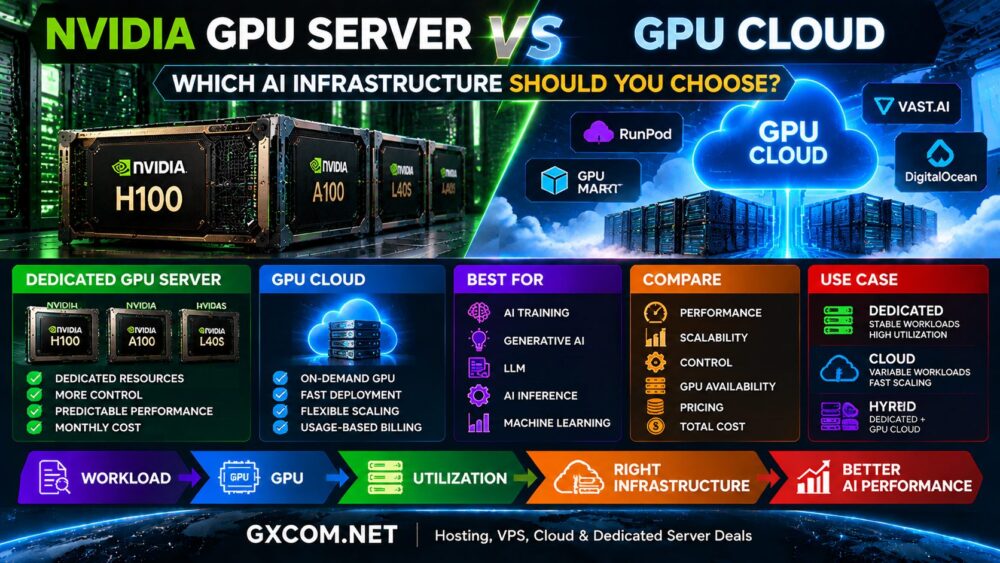
NVIDIA GPU 服务器与 GPU 云服务一览
| 因子 | 专用 NVIDIA GPU 服务器 | GPU 云 |
|---|---|---|
| 硬件资源 | 专属 | 取决于平台 |
| 部署 | 通常较慢 | 快 |
| 缩放 | 受硬件限制 | 灵活的 |
| 账单 | 通常每月一次 | 通常基于使用情况 |
| 基础设施控制 | 高 | 取决于平台 |
| 最适合 | 稳定的工作负载 | 可变的工作量 |
| 容量规划 | 必填 | 更灵活 |
什么是专用 NVIDIA GPU 服务器?
专用 NVIDIA GPU 服务器是一种物理服务器,其 GPU 资源专属于单一客户,而非通过通用云环境进行共享。.
根据服务商的不同,专用 GPU 服务器可能包含以下类型的加速器:
- NVIDIA H100
- NVIDIA A100
- NVIDIA L40S
- RTX 系列显卡
- 其他 NVIDIA 数据中心 GPU
该服务器通常将 GPU 与专用 CPU 资源、系统内存、NVMe 存储、网络以及由客户或托管服务提供商控制的操作系统环境相结合。.
如需了解 NVIDIA 服务器选项的概述,请参阅我们的
最佳 NVIDIA GPU 服务器
指南。.
什么是 GPU 云?
GPU 云服务通过云基础设施提供 GPU 计算资源,用户无需购买和维护物理 GPU 服务器。.
根据平台的不同,客户可以启动 GPU 实例,使用时间从几小时、几天到更长时间不等,并按实际使用情况付费。.
GPU 云基础设施可用于以下方面:
- 人工智能开发
- 机器学习实验
- LLM微调
- AI推理
- 临时培训工作量
- 研究
- 变化迅速的项目
诸如以下平台: RunPod, Vast.ai, ,以及 DigitalOcean 阐述基于云的GPU计算的各种方法,范围从专门的GPU云和市场平台,到更广泛的开发者云基础设施。.
专用 GPU 服务器与 GPU 云:性能对比
专用服务器可提供对已安装 GPU 硬件的可预测访问。客户清楚了解工作负载可使用的 GPU、CPU、内存、存储和网络资源。.
对于基础设施利用率始终保持在较高水平的持续性人工智能工作负载而言,这种可预测性具有重要价值。.
云端 GPU 的性能在很大程度上取决于平台和实例配置。虽然高质量的云端 GPU 实例能够提供卓越的性能,但购买者仍应确认以下几点:
- 确切的 GPU 型号
- 专用或虚拟化 GPU 分配
- CPU 资源
- 系统内存
- 存储吞吐量
- 网络性能
- 多GPU连接
仅凭GPU的名称,无法描述整个AI系统的性能。.
NVIDIA GPU 服务器与 GPU 云在 AI 训练中的对比
AI训练通常需要GPU持续运行数小时、数天,甚至更长时间。.
对于持续的训练工作负载,专用基础设施可能更具吸引力,因为硬件始终可用,无需反复启动云实例。.
当训练需求不稳定时,GPU 云基础设施会更具实用性。.
例如,一个团队在进行大规模训练时可能需要八块高端GPU,但在两次实验之间几乎不需要任何GPU算力。为长期闲置的硬件付费会降低成本效益。.
因此,这一决定在很大程度上取决于利用率。.
用于大型语言模型(LLM)的 NVIDIA GPU 服务器与 GPU 云对比
大型语言模型可能需要大量的GPU内存和多块加速器,因此基础设施架构尤为重要。.
对于 LLM 工作负载,请比较:
- GPU内存
- GPU 数量
- GPU间通信
- 系统内存
- NVMe 性能
- 网络带宽
- 存储容量
- 扩展要求
专用多GPU服务器可能非常适合处理稳定的LLM工作负载,而云基础设施则能更轻松地临时扩展资源,以满足训练、微调或模型测试的需求。.
用于人工智能推理的 NVIDIA GPU 服务器与 GPU 云的对比
推理与训练的基础设施要求不同。.
生产环境中的 AI 应用程序可能需要持续处理请求,因此可预测的可用性和利用率至关重要。如果需求保持稳定,专用 GPU 基础设施可以提供一种简单的容量模型。.
然而,许多人工智能应用会遇到流量波动的情况。.
当一天中推理需求发生显著变化,或者在流量高峰期应用程序需要额外容量时,云基础设施能够提供更大的灵活性。.
各团队应比较每项请求的成本、延迟、利用率以及扩展行为,而不是简单地比较 GPU 的每小时价格。.
H100 专用服务器与 H100 云服务对比
NVIDIA H100 很好地说明了部署模式如何影响基础设施决策。.
| 因子 | 专用 H100 | Cloud H100 |
|---|---|---|
| 访问 | 保留的硬件 | 按需或预留 |
| 部署 | 取决于提供商 | 通常很快 |
| 缩放 | 固定配置 | 更灵活 |
| 账单 | 通常每月一次 | 通常按小时/按使用量计费 |
| 最适合 | 持续的工作负荷 | 可变的工作量 |
如果您正在专门评估 H100 基础设施,请阅读我们的
NVIDIA H100 服务器托管
指南。.
GPU 云与专用服务器:可扩展性
可扩展性是支持GPU云基础设施的最有力论据之一。.
专用服务器安装的GPU数量是固定的。如果一台配备4个GPU的服务器突然需要8个GPU,则必须额外配置物理容量。.
云基础设施可以简化扩展过程,因为当有可用容量时,用户可以部署更多的 GPU 实例。.
不过,云的可扩展性不应被理解为GPU资源无限可用。需求量大的加速器可能会受到区域或服务商层面的容量限制。.
基础设施控制
专用 GPU 服务器通常能对整个环境提供更强的控制力。.
根据托管模式的不同,用户可以控制:
- 操作系统
- NVIDIA 驱动程序
- CUDA 环境
- 集装箱
- 存储配置
- 网络配置
- 安全政策
云平台可能会对其中一些基础设施层进行抽象化处理,以此换取更简便的部署和管理。.
这两种方法本身并没有孰优孰劣之分。正确的选择取决于应用程序实际上需要多少基础设施控制权。.
NVIDIA GPU 服务器与 GPU 云的成本对比
成本是比较过程中最容易被误解的部分之一。.
云GPU看似更便宜,因为无需前期投入大量资金购买硬件,也不需要长期租用服务器。然而,如果连续数月运行一台昂贵的云GPU,运营成本可能会相当高。.
专用服务器通常每月费用较为可预测,但在利用率较低时可能会造成资金浪费。.
| 使用模式 | 待评估的基础设施 |
|---|---|
| 每周几小时 | GPU 云 |
| 临时人工智能项目 | GPU 云 |
| 需求难以预测 | GPU 云 |
| 持续的高利用率 | 专用GPU服务器 |
| 稳定的生产工作负载 | 根据总成本对两者进行比较 |
这些只是参考起点,而非放之四海皆准的规则。服务提供商的定价、GPU 类型、存储、带宽以及工作负载效率等因素都可能影响计算结果。.
如需更全面的成本分析,请参阅我们的
AI 服务器成本指南.
GPU 云服务的隐性成本
GPU的按小时计费仅是云服务账单的一部分。.
可能产生的费用包括:
- GPU计算
- CPU 和 RAM
- 持久化存储
- 快照
- 数据传输
- 公共IP资源
- 空闲实例
- 托管服务
AI 团队应计算运行整个工作负载的总成本,而不是将宣传的 GPU 每小时价格乘以预计运行时间。.
专用GPU服务器的隐性成本
专用基础设施的成本不仅限于 GPU 本身。.
根据服务器是租用的还是自有的,这些可能包括:
- 服务器月租
- 硬件采购
- 功率
- 冷却
- 人际网络
- 维护
- 硬件更换
- 技术管理
租用专用GPU服务器可以将大部分物理基础设施的管理责任转移给托管服务提供商。.
GPU 云服务提供商
GPU云市场包含几种不同的服务模式。.
RunPod
RunPod 专注于为人工智能开发者提供 GPU 计算服务,并支持灵活访问 GPU 资源。该方案非常适合开发、模型实验、训练和推理等工作负载,且无需永久性的专用基础设施。.
Vast.ai
Vast.ai 运营着一个 GPU 市场,用户可以在该平台上比较来自多个服务商的 GPU 资源。这对注重成本的项目来说颇具吸引力,不过用户还应比较各服务商的可靠性、存储、网络以及完整的实例规格。.
DigitalOcean
DigitalOcean 将 GPU 基础设施与更广泛的开发者云环境集成在一起。这对于需要同时使用 GPU 计算以及虚拟机、网络、存储、数据库和应用程序基础设施的团队而言极具吸引力。.
那么,专用 GPU 托管呢?
诸如以下这类专用 GPU 托管服务提供商: GPU Mart 更加侧重于构建持久的GPU服务器基础设施。.
当组织需要为持续的AI工作负载提供可预测的GPU资源,但又无需在内部购买和运营物理服务器时,这种模式便颇具吸引力。.
在比较专用主机服务时,请查看完整的配置信息,包括GPU型号、CPU、内存、NVMe存储、网络速度、带宽配额、合同期限以及升级选项。.
安全与数据控制
AI 基础设施可处理专有数据集、客户信息、模型权重以及其他敏感的业务资产。.
专用基础设施能够提供更强的隔离性,并对服务器配置拥有更大的控制权。云平台同样能够提供强大的安全功能,但具体的控制措施取决于服务提供商和服务架构。.
对于合规要求严格的组织,在选择任一部署模式之前,应评估安全策略、数据存储位置、访问控制、加密、隔离以及监管要求。.
混合型 GPU 基础设施
选择并不一定非得在专用服务器和云服务之间二选一。.
某些组织可以从混合模式中获益:
- 用于基准生产工作负载的专用 GPU
- 用于临时训练任务的GPU云服务
- 应对流量峰值的云容量
- 用于处理敏感工作负载的专用基础设施
- 用于开发和实验的云端 GPU
这种方法既能提供可预测的基准容量,又能灵活地获取额外的计算资源。.
如何在 NVIDIA GPU 服务器和 GPU 云之间进行选择
从工作负载入手,而不是从基础设施入手。.
| 问题 | 为何这很重要 |
|---|---|
| 您需要多少GPU小时? | 确定利用率 |
| 需求是否可以预测? | 影响扩展需求 |
| 需要哪款显卡? | 决定性能和成本 |
| 需要多少GPU内存? | 限制模型部署 |
| 你需要多块显卡吗? | 影响架构和网络 |
| 这些数据的敏感程度如何? | 影响安全设计 |
| 该工作负载将运行多长时间? | 影响总成本 |
基础设施选型中的常见错误
先选择性能最强的显卡
并非所有人工智能工作负载都需要 H100 级的基础设施。应根据工作负载来确定使用哪种 GPU。.
仅考虑按小时计费
存储、带宽、空闲时间、CPU 资源和工作负载持续时间都会对总云成本产生显著影响。.
忽略利用率
闲置的专用硬件成本高昂。持续运行的云端 GPU 同样可能造成高昂的成本。.
忽略可扩展性要求
在开发阶段运行良好的基础设施,当应用程序进入生产环境时,可能难以进行扩展。.
结语
在 NVIDIA GPU 服务器与 GPU 云之间做出选择,最终取决于工作负载模式、利用率、可扩展性、控制权以及总体成本。.
对于需要可预测的资源、基础设施控制以及持续GPU利用率的持续性工作负载而言,专用NVIDIA GPU服务器可能是一个不错的选择。.
GPU 云平台还具备另一项优势:灵活性。它们使 AI 团队能够快速部署 GPU 资源、测试不同的加速器,并在无需购买永久性硬件的情况下扩展基础设施。.
对于许多组织而言,最有效的策略甚至可能是将这两种模式结合起来。.
首先分析工作负载,确定所需的GPU和内存,估算利用率,评估软件和可扩展性要求,然后比较专用基础设施与云基础设施的总成本。.
正确的道路很简单:
工作负载 → GPU → 利用率 → 基础设施 → 性能 → 成本。.