
您发布了一个新页面,提交了网站地图,甚至可能还在 Google 搜索控制台中请求了收录——但该页面仍然没有出现在 Google 中。.
为什么?
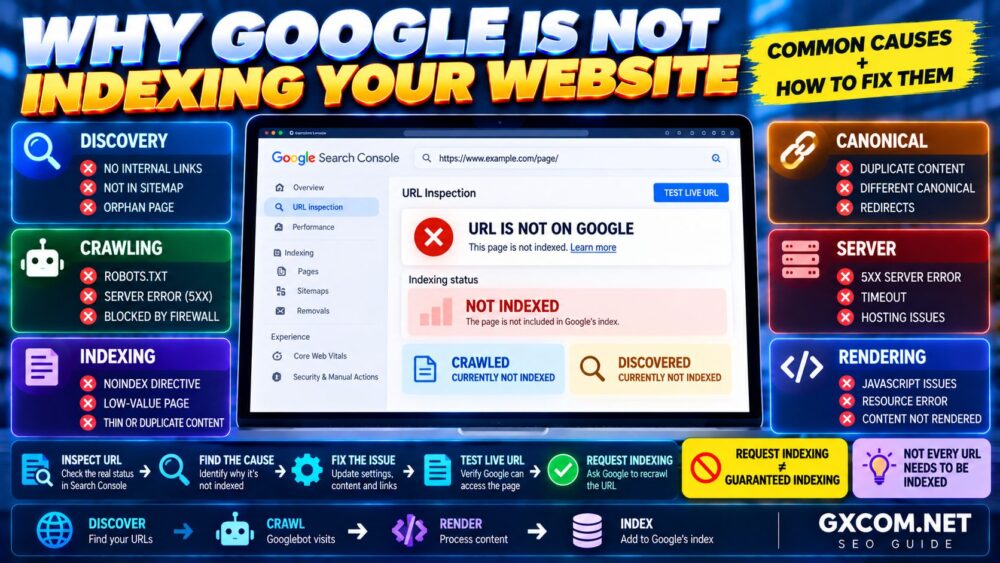
Google 的索引过程并非自动进行。在页面能够出现在搜索结果中之前,Google 通常需要先发现该 URL、对其进行抓取、处理内容、确定其规范版本,并决定是否将该页面纳入索引。.
页面在该过程的任何阶段都可能出现故障。.
本指南介绍了 为什么谷歌没有收录你的网站, ,如何诊断最常见的索引问题,以及如何解决这些问题。.
谷歌的索引过程: 发现 → 抓取 → 渲染 → 评估 → 规范化 → 索引。.
为什么谷歌没有收录我的网站?
最常见的原因包括:
- 您的网站或网页是新创建的
- Google 尚未发现该网址
- robots.txt 文件会阻止爬虫抓取
- noindex 指令会阻止索引
- 该页面已重定向至其他页面
- 谷歌认为该页面是重复内容
- Google 选择了另一个规范 URL
- 该页面返回了 404 错误或其他 HTTP 错误
- 服务器返回了 5xx 错误
- Google 已抓取该页面,但未将其收录
- Google 已发现该页面,但尚未对其进行抓取
- 该内容提供的独特价值不足
- 内部链接较弱
- 该页面实际上已成为孤页
- JavaScript 或渲染问题导致内容显示异常
- 该网站存在安全问题或人工干预问题
关键在于:
未被索引 ≠ 某个具体问题。.
在尝试解决问题之前,你需要先查明确切的原因。.
第一步:检查该页面是否已被收录
不要仅仅因为无法通过目标关键词找到某个页面,就断定该页面未被收录。.
一个页面可能已被收录,但排名过低,因此无法在您测试的查询结果中显眼地显示。.
对于特定的 URL,最有用的诊断工具是 Google 搜索控制台的 URL 检查工具。.
检查确切的规范 URL 并核对:
- URL 状态
- 允许爬虫访问吗?
- 页面加载
- 允许建立索引吗?
- 上次抓取
- 用户声明的规范形式
- Google 选定的规范链接
这一区别至关重要:
已被收录但未排名 ≠ 未被收录。.
了解谷歌的索引过程
在进行故障排除之前,请先了解基本操作流程。.
1. 发现
Google 需要通过内部链接、外部链接或网站地图等机制来发现该 URL。.
2. 爬行
当允许爬取且服务器响应成功时,Googlebot 会请求该 URL 并获取该页面。.
3. 渲染与处理
Google 会处理 HTML 代码,并可能执行 JavaScript 代码,以理解该页面及其资源。.
4. 规范化
如果存在类似的版本,Google 会确定哪个 URL 应代表该内容。.
5. 索引编制
如果谷歌认定该页面适合收录,该页面可能会被存储在谷歌的索引中,并有资格出现在搜索结果中。.
因此:
已发布 → 并不一定意味着 → 已被收录。.
1. 您的网站或网页太新了
新页面并不一定会立即被收录。.
Google 首先需要发现并抓取这些内容,而建立索引可能需要一段时间。.
若要创建新页面:
- 添加上下文相关的内部链接
- 在适当的情况下将其纳入您的 XML 网站地图中
- 确保该页面可被索引
- 使用 URL 检查功能
- 在适当的时候请求建立索引
每隔几分钟就反复提交同一个网址,并不会迫使谷歌加快对其的收录速度。.
2. Google 尚未发现该网址
如果谷歌不知道某个 URL 的存在,就无法对其进行抓取和收录。.
在以下情况下,通常会出现发现问题:
- 没有内部页面链接到该URL
- 该页面未出现在网站地图中
- 该页面在网站中埋得很深
- 导航依赖于无法访问的交互操作
- 该网站是新推出的,目前几乎没有被发现的迹象
重要页面通常应与网站架构相连接。.
一种有用的结构可能是:
首页 → 分类 → 子分类 → 文章
不要仅依靠XML网站地图来弥补网站架构的缺陷。.
3. robots.txt 文件正在阻止 Googlebot
robots.txt 规则可以阻止 Googlebot 抓取某个 URL。.
例如:
User-agent: *
Disallow: /private/
如果某个重要页面位于被屏蔽的路径中,Google 可能无法抓取其当前内容。.
请在以下操作后检查 robots.txt:
- 网站迁移
- 分阶段发布
- 安全方面的变更
- CMS 变更
- 重大改版
有一个特别重要的区别:
robots.txt 用于控制爬取。它并非从谷歌索引中可靠地移除 URL 的正确工具。.
如果你希望谷歌处理一个 noindex 指令,Googlebot 通常必须能够抓取该页面并识别该指令。.
4. 该页面包含一个 Noindex 指令
一个网页可以明确地告诉搜索引擎不要对其进行索引。.
例如:
<meta name="robots" content="noindex, follow">
该指令也可以通过 HTTP 传递 X-Robots-Tag 页眉。.
如果是有意为之,这很有用;但如果无意中应用到以下情况,后果将不堪设想:
- 主页
- 重要文章
- 产品页面
- 分类页面
- 着陆页
WordPress 用户还应检查 SEO 插件的设置以及网站的搜索引擎可见性配置。.
如果 Search Console 报告称不允许索引,请检查 robots 元标签和 HTTP 头。.
5. 该网址会重定向到其他地方
一个会永久重定向到另一个URL的URL,通常并不是您期望谷歌收录的版本。.
例如:
旧网址 → 301 → 新网址
旧的 URL 主要起到重定向的作用,而目标页面才是 intended for indexing 的页面。.
请检查:
- 意外的 301 重定向
- 302 重定向
- 重定向链
- 重定向循环
- HTTP → HTTPS 重定向
- www → 非www 或 非www → www 的重定向
内部链接和 XML 网站地图通常应直接指向您指定的规范目标页面。.
6. Google 认为该页面是重复内容
谷歌无需对同一内容的每个重复版本进行索引。.
可以通过以下方式创建重复项:
- URL 参数
- HTTP 和 HTTPS 版本
- www 和非 www 版本
- 跟踪网址
- CMS 档案
- 打印版本
- 产品变体
- 重复文章
Search Console 可能会报告涉及重复页面或带有正确规范标签的替代页面的状态。.
这未必是错误。.
如果谷歌索引的是您首选的规范版本,那么系统可能正是按预期运行的。.
并非每个未被收录的URL都需要被收录。.
7. Google 选择了另一个规范 URL
您可以指定首选的规范 URL:
<link rel="canonical" href="https://www.example.com/preferred-page/">
不过,规范标签只是参考信号,而非强制谷歌选择您首选网址的绝对指令。.
谷歌在选择具有代表性的规范链接时,会综合评估多种信号。.
请确保这些信号保持一致:
- 规范标签
- 内部链接
- XML 网站地图
- 重定向
- HTTPS 版本
- 内容一致性
如果 Search Console 显示 Google 选定的规范 URL 与您声明的规范 URL 不一致,请调查 Google 为何认为另一个 URL 更具代表性。.
8. “已抓取——当前未被收录”
这是 Search Console 中最令人沮丧的状态之一。.
这意味着谷歌已经抓取了该页面,但该页面目前尚未被收录。.
请不要仅通过反复点击“请求收录”来回应。.
相反,应评估页面本身。.
请问:
- 该页面是否提供了实质性的独特价值?
- 它是否与另一个页面极其相似?
- 内容是否较为单薄,或者主要采用模板化形式?
- 该页面是否满足明确的搜索意图?
- 它是否有有意义的内部链接?
- 该规范是否正确?
- 内容是否完整且有用?
对于重要页面,请先优化内容并完善其在网站中的整合,然后再请求再次抓取。.
已被收录 ≠ 保证被收录。.
9. “已发现——目前未被收录”
这意味着谷歌已知晓该网址,但尚未对其进行抓取。.
可能的诱因包括:
- 大量低价值网址
- 内部链接不足
- 新网站或新内容板块
- 对服务器容量的担忧
- 爬网效率低下
- 大量重复或不必要的URL
重点在于让重要的 URL 易于被发现,并减少不必要的抓取路径。.
对于大型网站,请检查:
- 多维度导航
- 站内搜索网址
- 带参数的URL
- 标签存档
- 日历存档
- 重复过滤器
10. 您的页面返回了 404 错误
如果某个页面确实不存在,则应返回 404 响应。.
但一个本应正常显示却误报404错误的重要页面,将无法被正常收录。.
常见原因包括:
- 更改了固定链接
- 已删除的页面
- 重写规则错误
- 迁移问题
- CMS路由故障
如果该页面本应存在,请将其恢复或修正路由。.
如果该页面已永久迁移,请将旧网址重定向到最相关的替代页面。.
不要将每个 404 错误自动重定向到首页。.
11. 软性 404 问题
当页面似乎不存在或提供的内容几乎没有实质意义,但服务器却返回了HTTP 200等成功状态码时,就会发生“软404”。.
示例包括:
- 空的产品页面
- 空的分类页面
- “返回200状态码的”未找到产品”页面
- 简略的占位页面
- 内容缺失模板
当内容确实不存在时,请使用适当的 HTTP 状态码。.
如果该页面应保持可被索引的状态,请确保其提供充实且有用的内容。.
12. 服务器错误导致 Google 无法抓取
Googlebot 必须能够可靠地抓取您的网页。.
常见的服务器错误包括:
- 500 服务器内部错误
- 502 网关错误
- 503 服务不可用
- 504 网关超时
可能的原因包括:
- 服务器过载
- PHP 错误
- 数据库问题
- 代理错误
- CDN 问题
- 资源不足
- 应用程序错误
如果重要页面频繁返回 5xx 错误,请排查应用程序和基础设施,而不是反复请求索引。.
13. 您的服务器或防火墙正在阻止 Googlebot
安全系统有时会干扰合法的爬虫。.
潜在来源包括:
- Web应用防火墙
- CDN 安全规则
- 速率限制
- 防机器人保护
- 主机防火墙
- 安全插件
不要仅仅因为某个爬虫自称是 Googlebot,就随意将其加入白名单。.
当爬虫身份至关重要时,请使用 Google 文档中记载的验证方法,而不是仅凭用户代理字符串来判断。.
14. 内部链接结构不佳会导致页面难以被发现
内部链接对用户和搜索引擎来说都很重要。.
从相关的高层级页面链接过来的文章,比仅存在于网站地图中的文章更容易被发现。.
在相关页面之间使用上下文内部链接。.
例如,这篇文章自然属于我们的 技术SEO检查清单.
合理的主题聚类有助于搜索引擎和用户理解内容之间的关联。.
15. 该页面是孤立页面
孤立页面没有指向它的有效内部链接。.
它可能存在于您的内容管理系统(CMS)中,甚至会出现在网站地图中,但与常规网站导航是脱节的。.
对于重要页面,请添加来自以下来源的相关链接:
- 分类页面
- 相关文章
- 主题中心
- 在适当情况下提供导航
如果某个页面很重要,就将其整合到网站中。.
16. 您的 XML 网站地图存在问题
XML 网站地图有助于 Google 发现 URL,但其中应包含您真正希望搜索引擎作为规范页面处理的 URL。.
请检查:
- 404 个 URL
- 重定向的URL
- noindex URL
- 重复的URL
- 非规范 URL
- 协议或主机名不正确
网站地图应强化您首选的网站结构,而不是与其相悖。.
提交网站地图 ≠ 保证被收录。.
17. JavaScript 渲染问题导致重要内容被隐藏
Google 可以处理 JavaScript,但复杂的 JavaScript 实现可能会引入额外的故障点。.
在以下情况下可能会出现问题:
- 主要内容完全依赖于无法运行的 JavaScript
- 内部链接未作为可爬取链接实现
- API 请求失败
- 延迟加载的实现有误
- 渲染所需的资源不可用
在排查以 JavaScript 为主的页面问题时,请使用“URL 检查”功能来查看 Google 渲染的页面以及获取的 HTML 和资源。.
18. 内容与现有页面过于相似
创建大量针对几乎相同搜索意图的页面,可能会导致内容出现大量重叠。.
例如:
最划算的VPS
便宜的VPS主机
经济实惠的VPS主机
低成本VPS主机
如果这些页面确实具有不同的用途,那么它们可以是合法的独立页面;但仅仅更改标题和几个词,并不能自动产生独特的价值。.
在发布新文章之前,请先问自己:
该页面是否值得独立存在?
对于大型SEO内容网站而言,这一点尤为重要。.
19. 内容单薄或价值较低的页面
并没有一个能保证被收录的“神奇”最低字数。.
一篇简短的文章可能极具价值,而一篇3,000字的文章却可能仍难以提供多少原创价值。.
请评估该页面是否:
- 满足搜索意图
- 提供有用的信息
- 在现有页面之外添加了某些内容
- 目标明确
- 是否准确且得到维护
- 并非仅仅为了生成另一个关键词网址而创建的
词汇量越多 ≠ 可索引内容越多。.
20. 您的网站生成了太多不必要的 URL
CMS 平台可以通过以下方式生成大量 URL:
- 标签
- 作者存档
- 日期存档
- 分页
- 筛选条件
- 搜索页面
- 参数
- 附件
并非所有通过技术生成的网址都值得出现在谷歌上。.
确定哪些 URL 类型具有独立的搜索价值。.
这可以优化网站架构,并减少谷歌需要处理的低价值重复URL的数量。.
21. HTTPS、WWW 和 URL 的各种形式不一致
可能的 URL 版本包括:
- http://example.com
- https://example.com
- http://www.example.com
- https://www.example.com
您的重定向、内部链接、网站地图和规范标签应始终如一地强化目标版本。.
另请参阅:
- 尾随斜杠
- 大写URL
- 索引文件
- 参数
一致性可减少相互冲突的规范信号。.
22. 手动操作或安全问题
如果技术设置看似正确,但重要页面或整个网站存在严重的可见性问题,请在 Google 搜索控制台中检查以下内容:
- 手动操作
- 安全问题
不要认为每个索引问题都是由惩罚引起的。.
技术问题、规范问题、收录问题、重复内容问题以及内容问题才是更为常见的解释。.
如何解决“已抓取——当前未被收录”的问题”
请按照以下顺序操作:
1. 检查网址
确认 Search Console 的确切状态。.
2. 检查可索引性
验证机器人、noindex、HTTP 响应和规范 URL 的配置。.
3. 比较竞争对手的网址
查找重复页面或内容高度重叠的页面。.
4. 改进内容
让页面内容更全面、更具特色且更有用。.
5. 优化站内链接
从相关的权威页面链接到该页面。.
6. 确认网站地图已包含在内
如果该页面属于搜索范畴,请包含规范 URL。.
7. 申请收录
在进行有针对性的修复后,请再次请求抓取。.
请勿使用:
请求索引 → 请求索引 → 请求索引简体中文(大陆)
作为解决根本问题的替代方案。.
如何解决“已发现——当前未被收录”的问题”
请检查:
- 指向该页面的内部链接
- XML 网站地图
- 网站架构
- 重复和低价值URL的生成
- 服务器可靠性
- 整体网站抓取效率
对于重要的新页面,请从已建立的页面添加强相关的上下文链接,并确保规范 URL 出现在网站地图中。.
如何正确请求谷歌收录
对于单个页面:
- 打开 Google 搜索控制台
- 在“URL 检查”中输入完整的 URL
- 查看现有索引状态
- 如果您最近修复了该页面,请进行一次实时测试
- 确认该网址可以被收录
- 点击“请求收录”
对于大量新增或更新的URL,应维护并提交XML网站地图,而不是手动请求数百个单独的页面。.
请记住:
请求收录 = 请求爬取/处理该 URL。.
请求收录 ≠ 命令 Google 收录该网址。.
谷歌需要多长时间才能将一个页面收录到索引中?
无法保证索引完成的时间。.
根据发现、抓取、网站状况以及谷歌的收录决策,一个页面的处理速度可能很快,也可能需要相当长的时间。.
请勿创建如下规则:
“24小时内未被收录 = SEO问题。”
对于新发布的内容,在认定出现故障之前,请先留出合理的时间。.
更好的主机服务有助于谷歌收录吗?
当基础设施问题导致 Google 无法稳定访问您的网站时,主机服务就显得尤为重要。.
例如:
- 频繁出现的 5xx 错误
- 服务器超时
- 严重过载
- 可用性极差
- 防火墙配置错误
但购买一台更强大的服务器并不能解决以下问题:
- Noindex 指令
- 错误的规范标签
- 重复内容
- 孤立页面
- 内部链接不足
- 内容单薄
如果服务器性能确实存在问题,应先进行诊断,而不是盲目升级。.
WordPress 用户可以关注我们的 WordPress 性能故障排除指南.
Google 索引故障排除对照表
| Search Console 状态/问题 | 通常的含义 | 需要检查的内容 |
|---|---|---|
| 被 robots.txt 阻止 | 禁止爬虫抓取 | robots.txt |
| 被 noindex 排除 | 显式阻止索引 | Meta robots / X-Robots-Tag |
| 包含重定向的页面 | URL 重定向到其他地方 | 重定向目标 |
| 重复页面 | 另一个 URL 代表内容 | 规范信号 |
| 已抓取——目前尚未被收录 | Google 已抓取但未收录 | 内容、重复内容、规范链接、内部链接 |
| 已发现——目前尚未被收录 | 已知但尚未被爬取 | 索引、抓取效率、网站质量 |
| 未找到 (404) | 页面无法访问 | URL、路由、删除 |
| 服务器错误 (5xx) | 服务器请求失败 | 托管/应用程序基础设施 |
| 另一页面 | 更倾向于另一个规范 | 规范 URL |
WordPress Google 收录检查清单
对于 WordPress 网站,请检查:
- ✓ 设置 → 阅读 → 搜索引擎可见性
- ✓ SEO 插件的机器人设置
- ✓ 文章级别的 noindex 设置
- ✓ 规范 URL
- ✓ XML 网站地图
- ✓ 分类和标签设置
- ✓ 作者/日期归档
- ✓ 附件网址
- ✓ 分页
- ✓ HTTP/HTTPS 重定向
- ✓ 内部链接
- ✓ 服务器状态码
- ✓ CDN/防火墙规则
除非您清楚哪个插件负责控制 robots 指令、规范标签和网站地图,否则请勿安装多个 SEO 插件来解决索引问题。.
Google 索引常见问题解答
为什么谷歌没有收录我的新页面?
Google 可能尚未发现或抓取该页面,也可能已抓取该 URL 但未将其选中进行索引。在断定存在错误之前,请先检查 URL 检查、内部链接、网站地图收录情况、robots 指令以及规范 URL 配置。.
为什么 Search Console 显示“已抓取——当前未收录”?
Google 已抓取该 URL,但该页面目前尚未被收录。请检查内容质量、重复内容、规范 URL 信号、内部链接,以及该页面是否提供了足够的独立价值。.
“已发现——目前未被收录”是什么意思?
Google 已知晓该 URL,但尚未对其进行抓取。请优化网站的可发现性、内部链接和抓取效率,并确认该网站可靠且不会生成过多不必要的 URL。.
提交网站地图能否保证被收录?
不。网站地图有助于谷歌发现网址,但不能保证提交的页面一定会被收录。.
“请求索引”能否保证被收录?
“请求收录”功能会要求谷歌重新抓取或处理某个网址。但该页面是否应被纳入索引,仍由谷歌决定。.
robots.txt 能阻止页面被收录吗?
当匹配的规则阻止 Googlebot 抓取时,robots.txt 会阻止抓取,但阻止抓取并不等同于能可靠地防止该 URL 出现在 Google 的索引中。如果目标是将其从搜索结果中排除,请使用适当的索引指令。.
设置了 noindex 的页面会出现在谷歌搜索结果中吗?
如果 Google 能够抓取并处理有效的 noindex 指令,该页面就应从 Google 搜索中排除。如果您希望 Google 能够识别该指令,请确保该页面未被同时阻止抓取。.
所有未被收录的页面都会对SEO产生负面影响吗?
不。重复的 URL、重定向、被故意设置为 noindex 的页面、已删除的页面以及许多带参数的 URL 可能会被正确地排除在 Google 的索引之外。.
我该如何判断谷歌是否选择了另一个规范链接?
使用 URL 检查功能,将用户声明的规范链接与 Google 选定的规范链接进行比较。.
主机速度慢会导致谷歌无法收录我的网站吗?
当服务器频繁超时、返回错误或无法访问时,基础设施问题可能是原因之一。但普通的索引问题不应自动归咎于主机服务。.
谷歌为何未收录您的网站:最终检查清单
- ✓ 确认该网址确实未被收录
- ✓ 在 Google 搜索控制台中检查该 URL
- ✓ 检查 Google 是否已收录该页面
- ✓ 检查 robots.txt 文件
- ✓ 检查 noindex 指令
- ✓ 验证 HTTP 状态码
- ✓ 检查重定向
- ✓ 验证规范 URL
- ✓ 检查 Google 选定的规范链接
- ✓ 检查重复的 URL
- ✓ 审核内容质量和独特性
- ✓ 添加有意义的内部链接
- ✓ 删除孤立页面
- ✓ 验证 XML 网站地图
- ✓ 检查服务器错误
- ✓ 检查 CDN/防火墙规则
- ✓ 在相关处测试 JavaScript 渲染
- ✓ 检查手动操作和安全问题
- ✓ 仅在修复问题后才请求索引
如果 谷歌未将您的网站纳入索引, 请不要一开始就反复提交网址。.
首先,确定索引过程在哪个环节出了问题:
发现问题?
优化内部链接、网站地图的检索以及网站架构。.
抓取问题?
检查 robots.txt 文件、服务器响应、防火墙和可用性。.
索引问题?
检查 noindex 指令、规范化、内容重复以及内容价值。.
渲染问题?
检查 JavaScript 和重要资源。.
服务器出问题了吗?
修复 5xx 错误、超时问题以及基础设施不稳定问题。.
然后测试正式版网址,并再次请求收录。.
发现 → 抓取 → 渲染 → 评估 → 规范化 → 索引。.
解决谷歌不收录该页面的根本原因——而不仅仅是处理搜索控制台的警告。.