大型语言模型改变了企业对GPU基础设施的认知。训练、微调和部署现代AI模型可能需要海量的计算能力、GPU内存、内存带宽、存储性能和网络容量。.
选择 最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器 因此,这远不止是选择最快的加速器那么简单。根据具体模型、工作负载、软件生态系统和预算的不同,NVIDIA H100、A100、L40S、AMD Instinct MI300X以及其他更经济的GPU选项都可能是不错的选择。.
本指南对比了用于大型语言模型(LLM)训练和推理的领先 GPU 服务器方案,解释了模型训练与模型部署之间的区别,并探讨了专用 GPU 服务器与灵活的 GPU 云基础设施的优劣。.
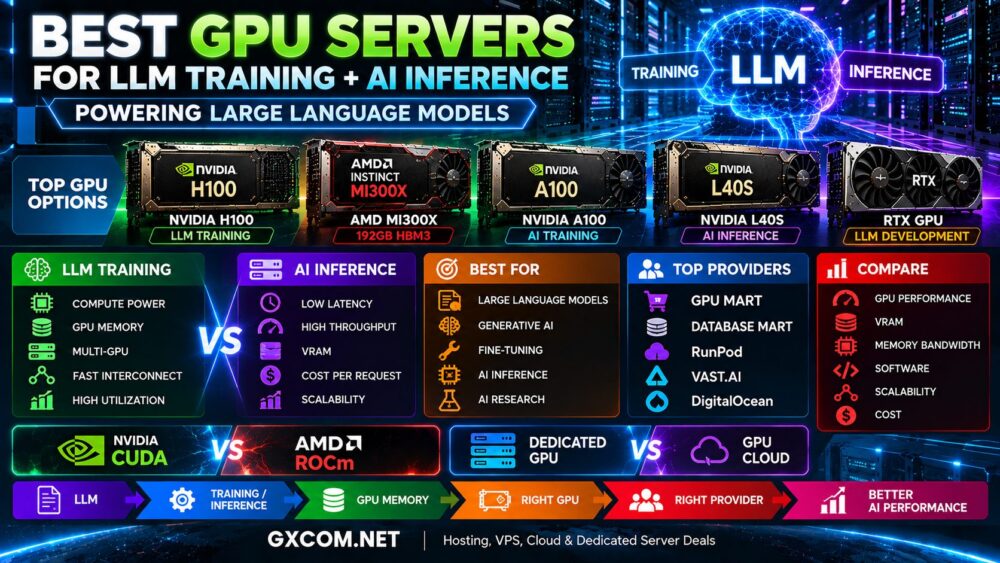
一览:最适合大型语言模型(LLM)的显卡
| GPU | 最适合 | 核心优势 | 软件 |
|---|---|---|---|
| NVIDIA H100 | 大规模大型语言模型(LLM)训练 | 高端人工智能加速 | CUDA |
| AMD Instinct MI300X | 内存密集型大型语言模型 | 192GB HBM3 | ROCm |
| NVIDIA A100 | 训练与微调 | 成熟的人工智能生态系统 | CUDA |
| NVIDIA L40S | AI推理 | AI 与图形处理的多功能性 | CUDA |
| RTX级显卡 | 开发与小型机型 | 较低的入门成本 | CUDA |
为什么大型语言模型需要GPU服务器
大型语言模型在很大程度上依赖于并行数学运算。GPU的设计旨在同时执行大量计算,因此对于许多现代人工智能工作负载而言,它比通用CPU更胜一筹。.
一个完整的LLM服务器必须平衡多种资源:
- GPU 计算性能
- GPU内存或VRAM
- 内存带宽
- CPU性能
- 系统内存
- NVMe 存储
- 多GPU通信
- 网络带宽
如果存储、网络、系统内存或软件配置造成了瓶颈,即使是一块性能强大的GPU,其表现仍可能不佳。.
LLM 训练与 AI 推理
训练和推理对基础设施的要求不同,因此,适合某项工作负载的最佳GPU,未必也适合另一项工作负载。.
LLM 训练
训练过程涉及处理海量数据集并反复更新模型参数。大规模训练可使多块GPU在较长时间内保持高利用率运行。.
培训基础设施通常优先考虑:
- 计算性能
- 大容量 GPU 内存
- 内存带宽
- 多GPU扩展
- 高速互连
- 高速存储
AI推理
推理是在模型训练完成后进行的。服务器处理用户请求,并基于现有的模型生成输出结果。.
推理基础设施通常优先考虑:
- 延迟
- 吞吐量
- GPU内存
- 批次大小
- 上下文长度
- 每次请求的成本
- 基础设施利用率
这一区别很重要,因为如果对每个推理工作负载都使用高端训练硬件,可能会显著增加运营成本,但未必能带来相应的收益。.
NVIDIA H100:最适合高端大型语言模型(LLM)训练
NVIDIA H100 是用于大规模人工智能领域最知名的数据中心 GPU 之一。.
H100 基于 NVIDIA 的 Hopper 架构打造,专为高要求的 AI 训练、推理、生成式 AI 以及高性能计算工作负载而设计。.
H100 服务器特别适用于:
- 大型语言模型的训练
- 生成式人工智能
- Transformer 工作负载
- LLM微调
- 企业级人工智能
- 多GPU人工智能基础设施
主要缺点是成本。对于较小型号和利用率较低的项目,使用价格较低的加速器可能更具性价比。.
如需详细了解 H100 基础设施,请参阅我们的
NVIDIA H100 服务器托管
指南。.
AMD Instinct MI300X:最适合高内存大型语言模型(LLM)工作负载
对于正在构建大型模型人工智能基础设施的企业而言,AMD Instinct MI300X 已成为一种重要的替代方案。.
其主要优势在于内存容量。MI300X 每个加速器配备 192GB 的 HBM3 内存,这使其对于那些受 GPU 内存严重制约的模型而言尤为具有吸引力。.
潜在的应用包括:
- 大型语言模型
- 生成式人工智能
- 大型模型推理
- 机器学习
- 内存密集型人工智能
- 高性能计算
主要需要考虑的是软件。AMD采用ROCm生态系统,因此从NVIDIA基础设施迁移过来的组织应验证模型、框架、库和应用程序的兼容性。.
更多详情请参阅我们的
AMD Instinct MI300X 服务器
指南。.
NVIDIA A100:经实践验证的AI训练方案
NVIDIA A100 虽然早于 H100 问世,但在许多机器学习和人工智能环境中依然发挥着重要作用。.
对于那些不需要新一代加速器性能特性的组织而言,A100 基础设施仍可在以下方面提供有用的性能:
- 模型训练
- 微调
- 深度学习
- 人工智能研究
- 推论
- 数据科学
不应自动排除较旧一代的GPU。关键在于其性能和当前的基础设施成本是否符合工作负载的需求。.
NVIDIA L40S:AI推理的强力选择
当将人工智能推理与图形相关的工作负载相结合时,NVIDIA L40S 尤其引人注目。.
可考虑用于:
- 生成式人工智能推理
- 图像生成
- 人工智能应用
- 计算机视觉
- 渲染
- 可视化
对于不需要高端 H100 级训练基础设施的工作负载,L40S 可以提供一种更均衡的部署方案。.
RTX GPU 服务器:经济实惠的大语言模型开发
并非每个大型语言模型(LLM)项目一开始就是企业级规模的。.
对于需要 GPU 加速但又无需承担高端数据中心硬件成本的开发者、初创企业、研究人员以及小型 AI 项目而言,RTX 级 GPU 非常实用。.
常见的使用场景包括:
- LLM开发
- 模型测试
- 小型模型推理
- 微调实验
- 图像生成
- AI 原型设计
通常,主要限制因素是 GPU 内存。大型模型可能需要进行量化、模型分割、使用多块 GPU 或更高内存容量的加速器。.
H100 与 A100 与 L40S 与 MI300X 在大型语言模型(LLM)方面的对比
| GPU | 培训 | 推论 | 主要优势 |
|---|---|---|---|
| NVIDIA H100 | 版型极佳 | 版型极佳 | 高端人工智能性能 |
| AMD MI300X | 紧身 | 紧身 | 大容量 GPU 内存 |
| NVIDIA A100 | 紧身 | 紧身 | 成熟的平台 |
| NVIDIA L40S | 取决于工作量 | 紧身 | 人工智能 + 图形 |
| RTX 显卡 | 较小的工作量 | 较小的工作量 | 成本更低 |
没有放之四海皆准的优胜方案,因为模型规模、精度、批量大小、上下文长度、框架优化以及GPU利用率都会显著影响实际应用中的结果。.
如需更详细的 NVIDIA 对比,请参阅
H100 与 A100 与 L40S 对比.
大型语言模型(LLM)需要多少GPU内存?
在选择大型语言模型(LLM)服务器时,VRAM 是最重要的因素之一。.
内存需求取决于:
- 模型参数个数
- 数值精度
- 训练还是推理
- 上下文长度
- 批次大小
- KV缓存
- 优化技术
如果某个模型无法高效地加载到GPU内存中,可能需要使用多个加速器或采用内存节省技术。.
正因如此,仅凭计算规格来选择GPU可能会产生误导。对于许多大型语言模型(LLM)工作负载而言,GPU的可用内存与原始处理能力同样重要。.
用于大型语言模型(LLM)训练的多GPU服务器
超大规模模型通常需要多块GPU。.
在这些环境中,服务器必须高效地在加速器之间传输数据。因此,多GPU性能绝不仅仅是将单个GPU的性能乘以已安装GPU的数量那么简单。.
需要重点考虑的因素包括:
- GPU互连
- 内存架构
- CPU平台
- 系统内存
- 存储吞吐量
- 网络架构
- 培训框架
对于跨多台服务器的分布式训练而言,网络性能变得尤为重要。.
大型语言模型(LLM)基础设施中的 CUDA 与 ROCm 对比
软件生态系统是决定选择英伟达还是AMD的一个重要因素。.
NVIDIA CUDA
CUDA 拥有成熟的生态系统,并在人工智能、机器学习和 GPU 计算领域得到了广泛应用。.
AMD ROCm
ROCm 提供了 AMD 的 GPU 计算软件平台,并持续扩展对人工智能和高性能计算(HPC)工作负载的支持。.
在两者之间做出选择之前,请确认:
- 框架支持
- 模型兼容性
- 必需的库
- 容器支持
- 操作系统兼容性
- 现有的 CUDA 依赖项
- ROCm 优化
我们的
AMD GPU 服务器与 NVIDIA GPU 服务器对比
该对比分析对此决定进行了更详细的探讨。.
最适合大型语言模型(LLM)的GPU服务器提供商
服务提供商的影响远不止于 GPU 本身。存储、网络、计费灵活性、区域、服务器架构以及部署模式都会影响最终结果。.
GPU Mart
GPU Mart 专注于 GPU 托管服务,对于寻求持久性 GPU 基础设施和专有服务器式部署的用户而言可能具有参考价值。.
下单前,请仔细比较具体的GPU、CPU、内存、NVMe存储、网络配置、流量配额以及合同条款。.
数据库集市
数据库集市 它将传统的服务器基础设施与GPU计算选项相结合,因此对于那些更倾向于采用服务器导向型部署,而非纯粹的临时性云资源的组织而言,具有重要意义。.
RunPod
RunPod 该平台专为人工智能开发者设计,以灵活的GPU计算为核心。其面向云端的架构可有效支持模型开发、训练、微调以及推理等工作负载,尤其适用于需求随时间变化的场景。.
Vast.ai
Vast.ai 提供了一种GPU交易平台模式,用户可以在其中比较不同主机提供的资源。.
对于对成本敏感的人工智能工作负载而言,这可能很有帮助,不过购买者应综合比较主机特性、可靠性、存储、网络以及完整的实例规格,而不仅仅关注GPU的价格。.
DigitalOcean
DigitalOcean 将 GPU 资源与更广泛的开发者云环境相结合。这对于正在开发人工智能应用且同时需要计算、存储、网络、数据库及相关云基础设施的团队而言极具吸引力。.
用于大型语言模型(LLM)的专用 GPU 服务器与 GPU 云的对比
| 因子 | 专用GPU服务器 | GPU 云 |
|---|---|---|
| 资源 | 专属 | 取决于平台 |
| 部署 | 取决于提供商 | 快 |
| 缩放 | 受硬件限制 | 灵活的 |
| 账单 | 通常每月一次 | 通常基于使用情况 |
| 最适合 | 稳定的利用率 | 可变的工作量 |
对于利用率可预测的、需要持续运行的大语言模型(LLM)工作负载而言,专用 GPU 服务器是一个明智的选择。.
对于开发、临时培训任务、实验以及需要快速扩展的工作负载而言,GPU 云基础设施可能更具吸引力。.
LLM 训练:专用服务器还是云端?
当 GPU 利用率持续较高,且工作负载需要可预测的硬件访问时,请考虑使用专用服务器。.
在以下情况下,请考虑使用 GPU 云服务:
- 训练是暂时的
- GPU 配置要求经常变化
- 您正在测试不同的加速器
- 您需要快速部署
- 您希望避免长期绑定特定硬件
如需查看完整的部署对比,请阅读
NVIDIA GPU 服务器与 GPU 云的对比.
一台用于语言模型(LLM)的GPU服务器多少钱?
由于基础设施要求差异巨大,因此不存在统一的LLM服务器价格。.
总费用可能包括:
- GPU计算
- GPU 数量
- CPU 资源
- 系统内存
- NVMe 存储
- 网络带宽
- 数据传输
- 持久化存储
- 闲置产能
- 管理与支持
仅凭每小时的GPU价格,并不能判断哪台服务器性价比最高。.
价格更高的 GPU 可能更快地完成工作负载,而价格较低的加速器则可能在持续推理方面提供更好的经济效益。.
请参阅我们的
AI 服务器成本指南
如需了解人工智能基础设施成本的更详细分类,请参阅。.
LLM 工作负载最佳 GPU 服务器
| 工作量 | GPU 评估方向 |
|---|---|
| 大型语言模型(LLM)训练 | H100 / 高端 AMD Instinct |
| 大型模型推理 | H100 / MI300X / 适用的替代产品 |
| 微调 | H100 / A100 / 针对特定工作负载的 GPU |
| AI推理 | L40S / H100 / MI300X / RTX(视型号而定) |
| LLM 开发 | RTX / 经济实惠的云端 GPU |
| 人工智能研究 | A100 / H100 / 适配的 GPU 云 |
大型语言模型(LLM)GPU服务器常见的错误
选择最昂贵的显卡
高级加速器并不能保证每款车型都能拥有最佳的性价比。.
忽略显存
GPU内存将决定模型能否高效运行。.
将训练硬件用于所有推理工作负载
推理在性能和成本方面的要求可能与训练截然不同。.
忽视软件兼容性
CUDA 和 ROCm 的兼容性会显著影响部署的复杂程度。.
仅比较每小时GPU价格
真正的衡量标准是总工作负载成本,而不仅仅是一GPU小时的标价。.
LLM GPU 服务器选型检查清单
- 确定该工作负载是训练还是推理。.
- 确定模型尺寸。.
- 计算 GPU 内存需求。.
- 选择所需的软件生态系统。.
- 确定是否需要多张GPU。.
- 估算预期的 GPU 利用率。.
- 比较专用基础设施与云基础设施。.
- 检查存储和网络。.
- 计算总工作量成本。.
- 为未来的扩展做好规划。.
结语
最适合大型语言模型(LLM)训练和人工智能推理的GPU服务器,取决于模型的实际需求。.
NVIDIA H100 专为高要求的 AI 任务和大规模训练而设计。AMD Instinct MI300X 提供了海量的 GPU 内存,可满足内存密集型 LLM 工作负载的需求。 A100 对于现有的 AI 环境仍然很有用,而 L40S 和 RTX 级 GPU 则能在推理、开发以及较小规模的工作负载中提供更优的成本效益。.
部署模式同样至关重要。专用 GPU 服务器能够为持续性工作负载提供可预测的资源,而 GPU 云平台则更便于进行实验、扩展,并且仅在需要时才为基础设施付费。.
不要一上来就问“哪款GPU性能最强?”,而应从具体型号和工作负载入手。.
更好的决策路径是:
LLM → 训练或推理 → VRAM → 软件 → GPU → 基础设施 → 成本。.