针对 RAG 应用的 GPU 托管服务可以加速文档嵌入、重新排序和语言模型推理,但通常没有必要为每个组件都租用 GPU。检索增强生成(RAG)将可搜索的知识与大型语言模型(LLM)相结合,从而产生了多种具有不同硬件需求的工作负载。.
对于开发企业搜索、文档助手或客户支持聊天机器人的团队而言,面临的挑战在于如何在响应质量、延迟和基础设施成本之间取得平衡。本指南将阐述GPU加速在哪些方面至关重要、向量数据库如何融入架构,以及如何比较托管服务提供商。.
RAG 应用程序是如何利用 GPU 资源的?
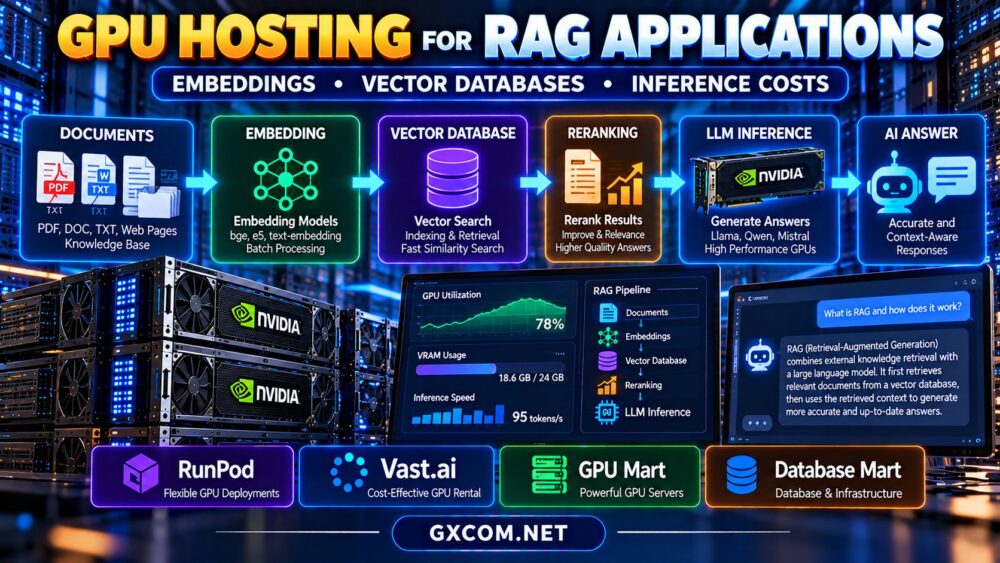
典型的 RAG 管道会摄入文档,将其分割成片段,生成嵌入向量,存储向量,检索相关段落,并将上下文发送给语言模型。有些系统会在生成内容之前增加一个重新排序阶段。.
这些阶段不应自动共享一台昂贵的GPU服务器。文档存储和许多向量搜索在CPU上运行效率很高,而大规模嵌入批次和生成式推理则可以借助加速器来提升性能。.
将服务分离还使团队能够独立于实时用户请求来扩展索引操作。.
嵌入式模型需要GPU吗?
嵌入模型将文本转换为数值向量,以实现语义搜索。小型模型可在CPU上运行,特别是在文档到达速度较慢或数据集规模较小时。.
在对数百万个片段进行索引、刷新大型集合或处理海量嵌入请求时,GPU加速便显得尤为重要。吞吐量取决于模型架构、序列长度、批量大小以及具体实现方式。.
例如,一家需要隔夜导入文档的公司可能会租用 GPU 算力来处理计划好的批量嵌入任务,并在任务完成后释放资源。而对于一个持续更新的知识库,则可能需要一个持久化的嵌入端点。.
应以每小时处理的文档数量和每千个数据块的成本为衡量标准,而不是一味认为更快的GPU总能带来更好的经济效益。.
向量数据库是否需要 GPU 托管?
不一定。许多矢量数据库利用CPU内存和优化后的索引来执行近似最近邻搜索。内存容量、索引结构、存储延迟以及查询过滤条件,其重要性可能超过GPU的可用性。.
GPU 辅助索引或搜索可帮助处理特定的大规模工作负载,但具体支持情况因数据库和部署配置而异。请务必核实实际功能,不要想当然地认为在 GPU 实例上安装向量数据库就能实现加速。.
| RAG 组件 | 典型的起点 | 当GPU发挥作用时 |
|---|---|---|
| 文档解析 | CPU服务器 | 专用视觉模型或OCR模型 |
| 嵌入式生成 | CPU 或共享 GPU | 大批量或高需求量 |
| 矢量数据库 | CPU、内存和高速存储 | 支持基于GPU加速的索引/搜索 |
| 重新排序 | 适用于中等流量的CPU | 负载下的神经网络重新排序器 |
| LLM生成 | 用于更大规模本地模型的GPU | 低延迟、并行推理 |
LLM 推理通常是 GPU 的主要开销
一旦检索到相关段落,生成模型就会处理用户的问题及相关上下文。模型权重、键值对缓存、并发请求以及输出长度在很大程度上决定了推理所需的内存配额。.

检索到的段落过长可能会增加提示处理时间和缓存占用。将每个匹配的文档都发送给模型可能会增加成本,却无法提高答案质量。.
请使用我们的 NVIDIA GPU 用于 LLM 推理的 VRAM 要求 关于估算权重内存、量化开销以及上下文相关缓存增长的指南。.
然后请查阅 AI 推理服务器配置指南 在规划并发用户数和每秒令牌处理能力时。.
RAG 延迟:检索、重新排序和生成
端到端响应时间包括查询嵌入、向量检索、可选的重新排序、提示词处理和令牌生成。服务之间的网络调用可能会增加开销。.
跟踪每个阶段的 p50 和 p95 延迟。如果请求主要受缓慢的数据库查询影响,那么即使使用更快的推理 GPU,也可能收效甚微。.
从一个小而相关的检索集开始。针对具有代表性的问题,测试块大小、Top-k 值以及重新排序质量。更好的检索可以减少不必要的上下文令牌,并提高生成的答案的实用性。.
RAG 基础设施的四家经批准的托管服务提供商
RunPod:GPU推理和嵌入式工作负载
RunPod 这是评估基于 GPU 的嵌入式服务、重新排序器和大型语言模型(LLM)推理的一种选项。请比较特定产品可用的加速器配置、部署方式、存储持久化方案及计费规则。.
我们的 RunPod GPU 云服务评测 提供了有关提供者的更多背景信息。.
Vast.ai:灵活的 GPU 租赁服务
Vast.ai 适合需要对替代性 GPU 进行性能基准测试或运行周期性嵌入任务的团队。由于各平台提供的方案各不相同,部署前请务必核查 GPU 规格、主机可靠性、网络访问情况以及存储条件。.
请将重要的模型构建产物和应用程序数据备份到临时计算环境之外。.
GPU Mart:持久化加速器基础设施
GPU Mart 当您的 RAG 系统需要一个持久的加速环境时,值得考虑这一方案。请确认所选方案中可用的 GPU、驱动程序支持、VRAM 分配以及服务器管理选项。.
在确定固定配置之前,请将按月计费的使用方案与灵活的按小时计费方案进行比较。.
数据库集市:数据库及配套服务
数据库集市 可根据产品兼容性,评估其是否支持数据库或服务器基础设施。请勿假设其普通托管产品提供托管向量数据库或GPU加速功能。.
购买前,请确认您所选的矢量引擎、索引方法和操作要求是否受支持。.
RAG 的 GPU 托管服务费用是多少?
将摄入成本与服务成本区分开来。索引操作可能仅执行一次或定期执行,而检索和生成操作则会在每个用户提问时运行。.
假设GPU租赁费率为每活跃小时$0.60。每月40小时的嵌入任务需要消耗$24的计算时间。若连续运行同一实例720小时,所需计算时间为$432,这还不包括存储、网络及其他费用。.
这些只是假设性的计算,并非服务提供商的报价。有些服务会在计算资源停止运行期间,对预留的存储空间或其他资源收取费用。.
在选购 GPU 时,可进行以下对比: 经济实惠的 GPU 服务器选项 并评估每个成功的RAG回答的总成本。.
推荐的部署架构
对于早期阶段的应用,建议从基于 CPU 的文档处理和向量检索入手,并搭配一个可独立扩展的 GPU 推理服务。当延迟要求允许时,可使用计划好的 GPU 任务进行批量嵌入。.
随着流量增长,请监控嵌入队列时间、数据库搜索延迟、GPU利用率、令牌吞吐量以及答案质量。仅在经测量确认性能提升确实值得时,才增加专用的重新排序处理能力。.
考虑一个 GPU VPS 与专用 GPU 服务器的对比 在决定生产环境部署需要何种程度的资源隔离时。.

比较适用于您的 RAG 管道的 GPU 托管服务
应根据嵌入吞吐量、重新排序负载以及大型语言模型(LLM)推理需求来匹配加速器的容量,而不是为每个组件租用一台规格过大的服务器。.
常见问题解答
RAG 应用程序可以在没有 GPU 的情况下运行吗?
是的。较小的嵌入模型和语言模型可以在 CPU 上运行,而托管模型 API 则可以免去您自行运维 GPU 的麻烦。性能和成本取决于工作负载的规模。.
嵌入向量和大型语言模型(LLM)的推理应该共用一块GPU吗?
在原型阶段可以这样做,但将服务分离通常能使容量规划更轻松。批量索引和交互式推理对延迟的要求不同。.
增加矢量数据库的RAM比增加GPU的VRAM更好吗?
对于基于 CPU 的向量检索,充足的系统内存和合适的索引可能更为重要。而对于加速模型和支持的 GPU 搜索操作而言,GPU 显存则至关重要。.
最终裁决
针对 RAG 应用程序的高效 GPU 托管首先要从工作负载分离做起。在可行的情况下使用 CPU 基础设施,当测量结果表明有必要时加速嵌入或重新排序,并根据实际上下文和并发需求调整 LLM 推理的规模。比较 RunPod, Vast.ai, GPU Mart, ,且合适 数据库集市 根据经过测试的性能、可靠性以及总体运营成本来评估基础设施。.