

适用于 TensorRT-LLM 的 NVIDIA GPU 服务器:吞吐量、批处理和托管成本
为 TensorRT-LLM 选择 NVIDIA GPU 服务器,不仅需要比较 GPU 内存和每小时租赁价格。大型语言模型的推理取决于吞吐量、请求并发数、批处理效率、内存管理以及延迟目标。一款强大的加速器……
NVIDIA GPU 服务器驱动程序兼容性:CUDA、容器与部署风险
NVIDIA GPU 服务器驱动程序的兼容性对于可靠的人工智能训练、推理和容器化部署至关重要。如果 GPU 的驱动程序、CUDA 运行时、容器配置或机器学习框架存在问题,即使是最强大的 GPU 也无法正确运行您的工作负载……
NVIDIA GPU 用于 LLM 推理的 VRAM 需求:量化、上下文和 KV 缓存
在租用 AI 服务器之前,了解 NVIDIA GPU 针对 LLM 推理的 VRAM 要求至关重要。即使某个语言模型在加载时能够完全容纳在 GPU 内存中,当用户提交较长的提示词或多个……时,该模型仍可能出现故障。
NVIDIA Blackwell GPU 云服务评测:B200、GB200 及 AI 基础设施采购考量
本篇关于 NVIDIA Blackwell GPU 云服务的评测,从 AI 基础设施采购的角度出发,对 B200、GB200 Grace Blackwell 超级芯片以及 GB200 NVL72 进行了分析。对于部署大型语言模型、推理系统、生成式 AI 应用以及分布式……
Vast.ai GPU 市场评测:主机可靠性、GPU 选择及隐性成本
本篇关于 Vast.ai GPU 市场平台的评测,重点分析了主机可靠性、GPU 选择、实例中断、存储与网络方面的考量,以及可能影响 AI 训练和推理工作负载的隐性成本。Vast.ai 通过……提供 GPU 计算服务……
AMD Instinct 与 NVIDIA GPU 服务器对比:AI 训练成本、软件支持与基础设施价值
对于正在选择人工智能训练服务器、云GPU实例和专用基础设施的企业而言,AMD Instinct 与 NVIDIA GPU 之间的对比正变得越来越重要。AMD Instinct 加速器提供了高内存计算方案和 ROCm 软件生态系统,而……
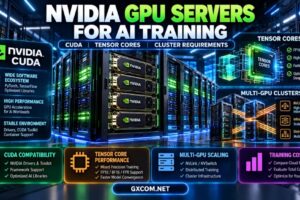
用于人工智能训练的 NVIDIA GPU 服务器:CUDA、张量核和集群要求
用于人工智能训练的 NVIDIA GPU 服务器为许多机器学习实验、大型语言模型微调项目以及分布式深度学习工作负载提供了计算基础设施。然而,选择训练服务器不仅仅只是选择……
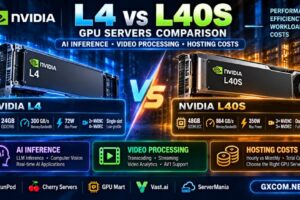
NVIDIA L4 与 L40S GPU 服务器对比:AI 推理、视频处理及托管成本
对于需要为人工智能推理、视频处理、计算机视觉和生成式人工智能选择 GPU 服务器的企业而言,NVIDIA L4 与 L40S 之间的对比至关重要。这两款加速器均采用 NVIDIA 的 Ada Lovelace 架构,但在……方面存在显著差异。
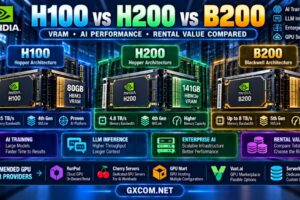
NVIDIA H100、H200 与 B200 服务器对比:VRAM、AI 性能及租赁价值分析
对于运行大型语言模型、AI 训练管道和高吞吐量推理服务的组织而言,在 NVIDIA H100、H200 和 B200 GPU 服务器之间做出选择是一项重要的基础设施决策。尽管这三款加速器均面向要求严苛的数据中心……
最佳 NVIDIA GPU 服务器:顶级 NVIDIA AI 服务器对比评测
人工智能已将GPU服务器从专用计算系统转变为机器学习、大型语言模型、生成式人工智能、推理、渲染以及高性能计算不可或缺的基础设施。英伟达凭借其广泛的产品线……在该市场的很大一部分占据主导地位。
NVIDIA GPU 服务器指南:您需要了解的一切
NVIDIA GPU 服务器已成为人工智能、机器学习、云计算、科学研究和高性能应用领域不可或缺的基础设施。凭借 NVIDIA H100、A100、L40S 和 RTX GPU 等强大的加速器,这些服务器提供了……
GPU服务器优惠:最佳GPU托管方案与折扣
GPU服务器已成为人工智能、机器学习、云渲染、科学计算和高性能应用不可或缺的基础设施。然而,租赁GPU硬件的成本可能很高,尤其是在使用高性能的NVIDIA GPU处理AI工作负载时。GPU……