运行大型人工智能模型已不再仅仅取决于原始计算能力。GPU内存容量、推理吞吐量、软件兼容性以及长期运营成本,在越来越大程度上决定了部署是否成功。.
这个 NVIDIA RTX PRO 6000 Blackwell 服务器评测 本文深入探讨了这款96GB GPU的架构、内存优势、AI推理性能、微调潜力以及服务器部署要求。此外,本文还对比了不同的租赁方案,并解释了在何种情况下选用其他加速器可能更具性价比。.
NVIDIA RTX PRO 6000 Blackwell 服务器评测:简评
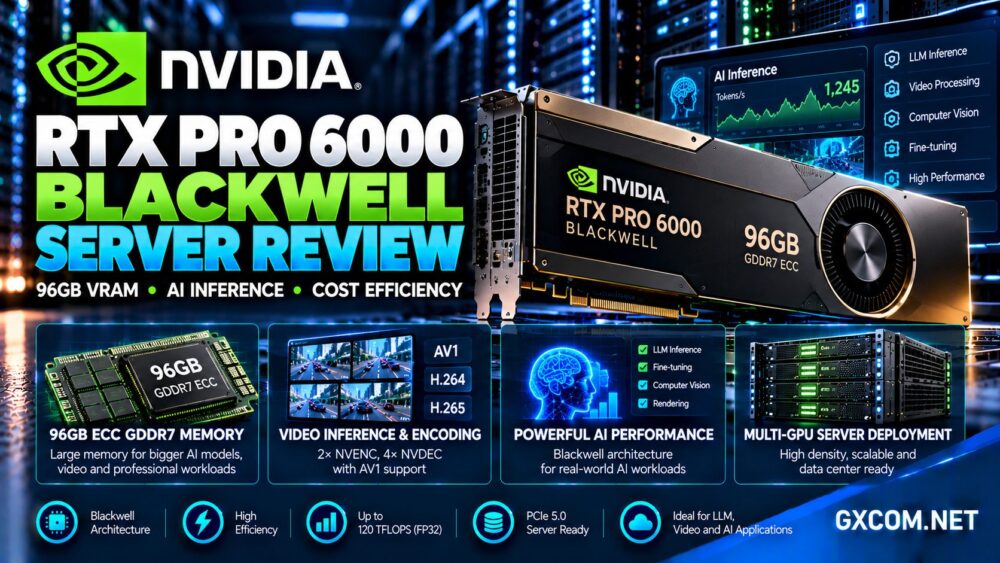
RTX PRO 6000 Blackwell 服务器版是一款功能强大的数据中心加速器,专为企业级人工智能、视觉计算、渲染和科学应用而设计。.
其最突出的特点是配备了96GB的ECC GDDR7显存,拥有约1.6TB/s的显存带宽,并搭载了Blackwell架构的张量核。.
这种组合使其对大型语言模型、多模态推理、高负载的视觉任务,以及希望获得大量GPU内存但又不愿自动升级到最昂贵加速器级别的企业极具吸引力。.
我们的结论: 对于内存密集型推理和专业级 GPU 工作负载,RTX PRO 6000 Blackwell 服务器版值得认真考虑。不过,购买者应核实具体的硬件版本、功耗配置、部署架构以及每项任务的完成成本。.
RTX PRO 6000 Blackwell 服务器版 规格参数
NVIDIA 将服务器版定位为数据中心产品,而非传统的台式机显卡。.
| 规格 | 服务器版 |
|---|---|
| 建筑 | NVIDIA Blackwell |
| CUDA 核心 | 24,064 |
| GPU内存 | 96GB GDDR7(带ECC) |
| 内存带宽 | 1,597 GB/s |
| 内存接口 | 512位 |
| FP32 峰值性能 | 120 TFLOPS |
| 界面 | PCIe 5.0 x16 |
| 最大功率 | 最高 600W,可配置 |
峰值规格有助于了解硬件性能,但不应将其理解为对应用程序吞吐量的保证。.
实际结果取决于模型架构、数值精度、批量大小、软件优化以及所处的服务器平台。.
服务器版与工作站版及 Max-Q 版
RTX PRO 6000 Blackwell 系列包括服务器版、工作站版和 Max-Q 工作站版。.
这三款产品均配备 96GB GDDR7 ECC 内存,但它们的散热设计、功耗目标以及目标部署环境各不相同。.
服务器版专为数据中心系统和高密度 GPU 配置而设计。NVIDIA 为其常规服务器外形规格指定了被动散热方案,并提供了额外的液冷部署选项。.
标准版工作站版面向专业台式机系统,而 Max-Q 版本则侧重于在合适的工作站配置下实现更低的功耗。.
购买服务器时,请确认具体的GPU型号,而不是仅凭“RTX PRO 6000 Blackwell”这一通用名称来判断。”
为什么96GB显存对AI工作负载至关重要
在大型语言模型的部署过程中,GPU内存往往是限制因素。.
模型权重、激活缓冲区、注意力缓存以及框架开销都会争夺可用的VRAM。.
与 24GB 或 48GB 的 GPU 相比,96GB 的加速器提供了更大的内存扩展空间,这可能使单台设备能够运行更大的模型或实现更高的推理并发度。.
LLM 推理与模型量化
量化可以减少存储模型权重所需的内存,但实际推理所需的内存不仅限于权重本身。.
较长的上下文窗口和并发请求会增加键值缓存的消耗。额外的运行时缓冲区也需要占用空间。.
RTX PRO 6000 能够支持规模庞大的量化模型,但能否运行特定的 70B 级模型,取决于精度、上下文长度、软件以及可用的性能余量。.
我们的 AI GPU VPS 服务商对比 探讨了针对不同模型规模的部署方案。.

更大的VRAM能否保证更快的推理速度?
不。内存容量决定了能容纳多少数据,而吞吐量则取决于计算资源、内存带宽、批处理以及软件效率。.
对于要求苛刻的工作负载,更大的GPU可能带来更快的处理速度,但较小的模型有时在价格较低的加速器上运行会更经济。.
在真实的并发流量条件下,测量获取第一个令牌所需的时间、每秒令牌数以及延迟。.
Blackwell 张量核心与 FP4 性能
服务器版采用第五代张量核,并支持低精度AI计算,包括FP4。.
当模型和推理框架支持时,降精度格式可以提高吞吐量和内存利用率。.
然而,宣传中的FP4峰值性能仅代表特定的计算条件,并非通用的性能结果。.
应用程序必须使用兼容的内核、经过优化的推理引擎以及适当的量化方法,才能从中获益。.
量化后还应评估模型的准确性,特别是对于需要输出结果保持一致的应用。.
AI微调:96GB够用吗?
RTX PRO 6000 Blackwell 服务器版适用于参数高效微调、实验以及部分大型模型训练工作流。.
LoRA 和 QLoRA 等技术可以减少适配预训练模型所需的内存。.
全参数训练的要求更高,因为梯度、优化器状态和激活函数会消耗大量内存。.
拥有96GB的GPU并不意味着对每个大型模型进行全面微调都切实可行。.
对于分布式训练而言,网络连接、GPU 通信和存储吞吐量变得越来越重要。.
多GPU服务器与内存扩展
NVIDIA 将服务器版定位于多 GPU 数据中心部署,包括每套系统配备多个加速器的配置。.
一台配备8个GPU的服务器可提供总计768GB的GPU内存,但这些内存分布在不同的设备上。.
应用程序需要采用合适的并行化策略,以有效分配模型和工作负载。.
PCIe 连接和网络架构会影响通信开销,尤其是在模型频繁交换数据时。.
我们的 NVIDIA GPU 服务器供应商指南 有助于比较规模更大的加速器部署。.
GPU 分区与工作负载隔离
RTX PRO 6000 Blackwell 支持 NVIDIA 多实例 GPU 技术,允许符合条件的配置将 GPU 资源划分为相互隔离的实例。.
NVIDIA 表示,根据所采用的分区配置文件的不同,某些配置最多可支持四个 24GB 实例。.
对于运行多个小型推理服务的组织而言,这可能很有用,因为这样就不必为每个应用程序分配整个96GB的加速器了。.
然而,分区的 GPU 实例并不等同于对整个加速器的独占所有权。.
购买者应确认所选的主机方案是提供完整的GPU、MIG分区,还是其他虚拟化方案。.
渲染、视频和专业应用
RTX PRO 6000 不仅限于语言模型。.
其Blackwell架构、RT核心和视频引擎还支持渲染、可视化、媒体处理和计算机视觉。.
开发数字孪生、合成训练数据或高分辨率视觉内容的组织,可从 GPU 内存与图形加速的结合中获益。.
不过,渲染速度取决于应用程序的支持情况、场景的复杂程度、驱动程序的配置以及可用的GPU资源。.
在哪里可以租用 RTX PRO 6000 Blackwell 显卡
各家GPU租赁平台在硬件供应、计费方式、管理工具以及基础设施可靠性方面各不相同。.
RunPod:已发布 96GB RTX PRO 6000 配置选项
RunPod 在其云GPU产品目录中列出了配备96GB内存的RTX Pro 6000 GPU配置。.
对于希望在投入长期基础设施之前先测试推理工作负载的开发人员而言,这是一个切合实际的起点。.
请在部署时确认确切的版本、地区、CPU 分配、存储费用及可用性。.
Vast.ai:基于市场平台的GPU租赁服务
Vast.ai 提供了一个从不同主机租用GPU计算资源的市场平台。.
这有助于比较硬件选项和基础设施的经济性,不过必须在当前的产品列表中核实特定 RTX PRO 6000 配置的供应情况。.
审查主机可靠性、网络、存储成本以及中断情况。.
GPU Mart:GPU服务器的替代方案
GPU Mart 对于正在评估支持 GPU 的托管和专用服务器基础设施的客户而言,这是一种选择。.
买家应询问具体的显卡型号、内存容量、服务器规格以及管理方案。.
请不要认为一般的 GPU 服务器套餐中就包含 RTX PRO 6000 Blackwell 硬件。.
OVHcloud:专用和云端 GPU 基础设施
OVHcloud 为寻求更传统的云或专用服务器环境的企业提供相关的GPU基础设施选项。.
其GPU产品组合可作为网络、地域覆盖和基础设施管理方面的参考基准。.
请确认可用的加速器 SKU,而不是将每个 NVIDIA GPU 实例都视为等同。.
我们的 经济实惠的GPU服务器对比 探讨了更广泛的采购考量因素。.
RTX PRO 6000 与 L4、L40S 和 H100 的对比
| GPU | 记忆 | 首要考虑因素 |
|---|---|---|
| NVIDIA L4 | 24GB GDDR6 | 高效的视频处理与更小的推理规模 |
| NVIDIA L40S | 48GB GDDR6 | 图形处理和大型推理工作负载 |
| RTX PRO 6000 布莱克韦尔 | 96GB GDDR7 | 大内存人工智能与视觉计算 |
| NVIDIA H100 SXM | 80GB HBM3 | 高吞吐量人工智能训练与推理 |
RTX PRO 6000 的内存容量远超 L4 和 L40S,但仅凭容量并不能决定整体性能。.

H100级GPU采用了不同的内存和互连技术,这些技术对于要求苛刻的人工智能工作负载而言具有优势。.
应比较完整的应用程序性能,而不是仅凭显存容量来对GPU进行排名。.
RTX PRO 6000 服务器定价与长期价值
GPU 租赁费用取决于加速器的可用性、所在区域、实例资源、存储、网络以及计费条款。.
对于连续推理,请按每百万个令牌或每个完成的请求,在要求的延迟条件下计算成本。.
在渲染方面,请比较每完成一个场景或视频项目的成本。.
在估算月度支出时,请将闲置容量、持久化存储、备份保留期和数据传输纳入考虑范围。.
我们的 GPU 与 CPU 服务器的对比 解释了在何种情况下,加速能带来有意义的经济价值。.
常见问题解答
RTX PRO 6000 Blackwell 拥有多少 VRAM?
RTX PRO 6000 Blackwell 服务器版配备了 96GB ECC GDDR7 显存。.
它能运行70B的语言模型吗?
它能够支持经过适当配置和量化的 70B 级推理工作负载,但可用上下文长度和并发性取决于内存开销和软件配置。.
服务器版与工作站版有什么区别吗?
是的。尽管这些变体具有相同的标称内存容量,但在功耗、散热、外形尺寸和部署特性方面却各不相同。.
RTX PRO 6000 支持 MIG 焊接吗?
是的。受支持的MIG配置允许将GPU划分为多个较小的隔离实例。.
它比H100更好吗?
并非放之四海皆准。RTX PRO 6000 具备可观的 GDDR7 内存容量和多功能的图形处理能力,而 H100 级硬件则更适合需要其 HBM 内存子系统和面向 AI 的架构的工作负载。.
最终结论:哪些人应该选择 RTX PRO 6000 Blackwell?
这个 NVIDIA RTX PRO 6000 Blackwell 服务器评测 为高内存推理、专业可视化以及部分AI微调工作负载提供了一种极具吸引力的加速方案。.
其96GB ECC GDDR7内存、Blackwell张量核以及多GPU部署能力提供了极大的灵活性。.
RunPod 提供了一项已公布的96GB租赁选项,而Vast.ai,, GPU Mart, ,此外,OVHcloud 作为替代性的 GPU 基础设施和部署模式,也值得评估。.
购买前,请确认具体的服务器版本硬件、内存要求、工作负载吞吐量、隔离模型以及完整的运营成本。最佳的GPU投资应是能够持续满足生产需求的那种,而非仅仅提供最高规格的产品。.