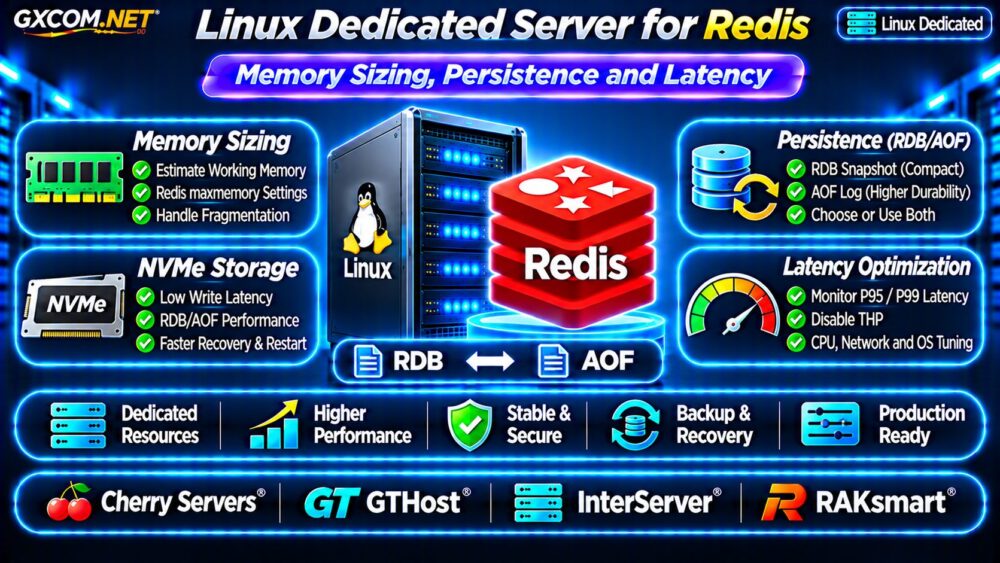
A 用于 Redis 的 Linux 专用服务器 可以提供可预测的内存访问、专用的 CPU 资源,以及对存储和操作系统设置的直接控制。然而,将 Redis 从 VPS 迁移到物理硬件并不能自动消除延迟骤升或内存不足导致的故障。
Redis 的性能取决于数据集大小、内存开销、持久化设置以及应用程序的流量模式。本指南将介绍如何确定专用服务器的规格、在 RDB 和 AOF 之间进行选择,以及如何评估托管服务提供商,同时避免为不必要的硬件付费。
Redis 何时需要专用服务器?
Redis 通常支持应用程序缓存、会话、队列以及低延迟的数据访问。对于较小的部署,共享基础设施可能已足够,但对于持续的工作负载,专用内存容量和可预测的 CPU 调度将带来显著优势。
当内存占用接近可用容量、后台持久化影响响应时间,或者共享 CPU 的争用变得可测量时,请考虑物理硬件。
在迁移之前,请确定基准吞吐量、P95和P99延迟、内存使用情况以及恢复要求。专用硬件是容量规划的决策,不能替代应用程序优化。
Redis 内存配置:不仅取决于数据集大小
Redis 将主要数据结构存储在内存中,但总内存占用量还包括键元数据、内存分配器的开销、客户端缓冲区、复制缓冲区以及内存碎片。仅凭逻辑数据集的大小,不足以作为购买内存的依据。
计算工作内存和可用空间
首先查看 Redis 的 INFO 内存指标,包括 used_memory、used_memory_rss 和 mem_fragmentation_ratio。在分析内存碎片时,应结合绝对内存使用量进行解读,因为在负载较轻的系统中,比率数据可能会产生误导。
举例来说,一个占用 20GB Redis 内存的数据集,在考虑操作系统需求、内存碎片以及持久化开销后,可能需要占用远超此数的物理内存。
对于这种工作负载而言,32GB的设备可能不够用,尤其是在后台保存数据时。64GB的配置或许能提供更大的空间,但要做出正确的选择,需要测量峰值使用量并进行工作负载测试。
谨慎设置 maxmemory
maxmemory 设置会根据 Redis 的内存计账规则限制其内存使用;它并非对进程消耗的每个字节都设置的硬性上限。请为数据持久化、客户端活动、操作系统及其他服务预留足够的余量。
根据应用语义选择驱逐策略。缓存工作负载可能可以容忍驱逐,而持久化队列或关键状态则需要不同的设计。
RDB 与 AOF:Redis 的持久化选项
持久性决定了 Redis 在重启或发生故障后如何重建数据。Redis 支持特定时间点的 RDB 快照和仅追加文件 (AOF) 日志记录。有些部署同时使用这两种方式。
RDB 快照
RDB 会创建紧凑的快照,适用于某些备份和恢复工作流。但是,在意外关机时,自最近一次成功创建快照之后写入的数据可能会丢失。

背景快照的创建利用了 fork 以及写时复制机制。在快照运行期间,写入密集型工作负载可能会增加临时内存的压力。
AOF 日志记录
AOF 会记录数据修改操作,并提供不同的持久性权衡方案。“everysec” 策略(即 appendfsync everysec)是一种常见的折中方案,但它并不能保证零数据丢失。
更激进的同步操作可能会增加磁盘活动和延迟。AOF重写也会产生资源需求,这些需求应纳入容量规划中。
请使用官方的 Redis 持久化文档 以确认您已部署的 Redis 版本的行为。
为什么 NVMe 对 Redis 的持久化至关重要
Redis 主要从内存中提供数据,因此更快的磁盘并不会自动加快每个命令的执行速度。在 AOF 写入、快照创建、加载和恢复过程中,存储性能就显得尤为重要。
应比较持续写入延迟、磁盘耐用性和可用容量,而不是仅依赖于标称的顺序吞吐量。
我们的 NVMe 与 SSD 性能指南 解释了相关的存储权衡。
Linux 调优以降低 Redis 延迟
Linux 内核设置和 CPU 行为可能会影响 Redis 的响应时间。请检查透明巨页 (THP)、内存超额分配、交换、CPU 频率行为以及相关的 NUMA 放置情况。
THP 与内存超额分配
Redis 指南通常建议禁用 THP 以获得可预测的延迟。在进行全系统范围的更改之前,请根据您的 Redis 版本和 Linux 发行版核对当前的建议。
后台进程的持久化可能还需要对 vm.overcommit_memory 进行适当配置。应监控内存压力,而非将内核设置作为充足内存的替代方案。
网络和 CPU 方面的注意事项
尽可能将应用服务器部署在地理位置上靠近 Redis 的位置。即使在高速专用硬件上,网络往返时间、客户端连接模式以及低效的命令也可能成为导致延迟的主要因素。
对于以主 Redis 执行线程为主的工作负载而言,现代 CPU 核心通常比数量庞大的旧式核心更为重要。额外的线程和后台任务仍可从 CPU 性能中获益。
有关相关性能诊断的信息,请参阅我们的 VPS CPU 抢占时间故障排除指南.
升级前测量 Redis 的 P99 延迟
平均延迟可能会掩盖偶发的慢请求。请在具有代表性的生产流量条件下(包括持久化操作和客户端并发峰值)跟踪 P95 和 P99 响应时间。
使用 Redis 延迟监控、SLOWLOG、应用程序遥测以及受控基准测试。在归咎于服务器之前,先排查耗时命令、大型键、网络延迟和磁盘阻塞等问题。
基准测试的结果一次只发生一项变化。如果瓶颈在于应用程序端的串行化或低效的键访问,那么一台看似更快的机器可能带来的好处微乎其微。
四家 Linux 专用服务器提供商对比
以下经 GXCOM.NET 认证的供应商是基础设施候选方。购买前请确认实际 CPU 型号、可用内存、NVMe 选项、部署位置以及管理职责。
Cherry 服务器:内存与裸机灵活性
Cherry 服务器 对于需要大量内存且需对物理硬件进行控制的 Redis 部署而言,值得对此进行评估。请比较可用的内存配置、处理器代数、磁盘性能以及更换流程。
GTHost:地理位置与网络延迟
GTHost 当网络位置和专用资源的可用性至关重要时,可以进行比较。请索取最新规格说明,并评估您应用环境中的延迟情况。
InterServer:Redis 托管套餐
InterServer 提供了另一个专门的基础设施对比参考点。请查看内存容量、CPU 型号年份、存储选项、持续性成本,以及硬件升级是否需要进行数据迁移。
RAKsmart:区域部署选项
RAKsmart 是地理定位型基础设施的候选方案。请确认所选数据中心的可用性、对 Linux 的支持情况、网络状况以及完整的服务器报价。
这些比较并不意味着每个专用套餐都包含 Redis 管理或托管数据库支持。

Redis 专用服务器成本规划
根据服务器租赁、内存升级、存储、备份、监控和运维支持等费用计算总成本。当可用性要求需要时,应将副本或备用基础设施的成本计入其中。
假设一台服务器费用为140美元,加上25美元的备份存储费用和35美元的监控或管理服务费用,每月总计200美元,每年则为2,400美元。这些数字仅用于说明预算情况。
若需做出更广泛的架构决策,请参阅我们的 专用服务器与云服务器的对比.
Redis 专用主机购买检查清单
- 测量 Redis 的峰值内存、RSS 以及碎片情况。
- 为进程分叉、持久化以及操作系统开销预留内存。
- 根据可接受的数据丢失程度,选择 RDB、AOF 或两者兼用。
- 对 NVMe 写入性能和应用程序 P99 延迟进行基准测试。
- 验证 CPU 代数、网络位置和升级选项。
- 规划备份、副本、监控和恢复测试。
常见问题解答
32GB 内存对 Redis 来说够用吗?
这取决于数据集大小、开销、写入活动以及持久化设置。在选择容量之前,请先测量实际的峰值内存占用量。
Redis 是否需要 NVMe 存储?
并非总是如此。当数据持久化、恢复或其他对磁盘访问要求较高的操作至关重要时,NVMe 尤其有用。
AOF 能否保证零数据丢失?
不。耐久性取决于同步策略、系统行为和故障情况。
最终裁决
选择用于运行 Redis 的 Linux 专用服务器时,应主要依据实际测得的内存需求、持久化开销和尾部延迟来决定,而非仅看 CPU 的标称规格。
比较 Cherry Servers、GTHost、InterServer 和 RAKsmart 通过工作负载基准测试和书面报价进行评估。应优先考虑充足的内存余量、可靠的存储以及可预测的恢复能力,而非不必要的硬件升级。