让多个AI应用程序共享一块昂贵的GPU,听起来似乎是降低基础设施成本的显而易见的方法。然而,让多个工作负载访问同一块加速器可能会导致不可预测的延迟、内存耗尽以及“噪音邻居”问题。.
在这篇 GPU MIG 与时间切片 为了进行比较,我们将探讨 NVIDIA 多实例 GPU 与 CUDA 时间片技术之间的差异,包括 VRAM 隔离、Kubernetes 调度、多租户推理、硬件兼容性以及云托管成本等方面。.
GPU MIG 与时间切片:简要结论
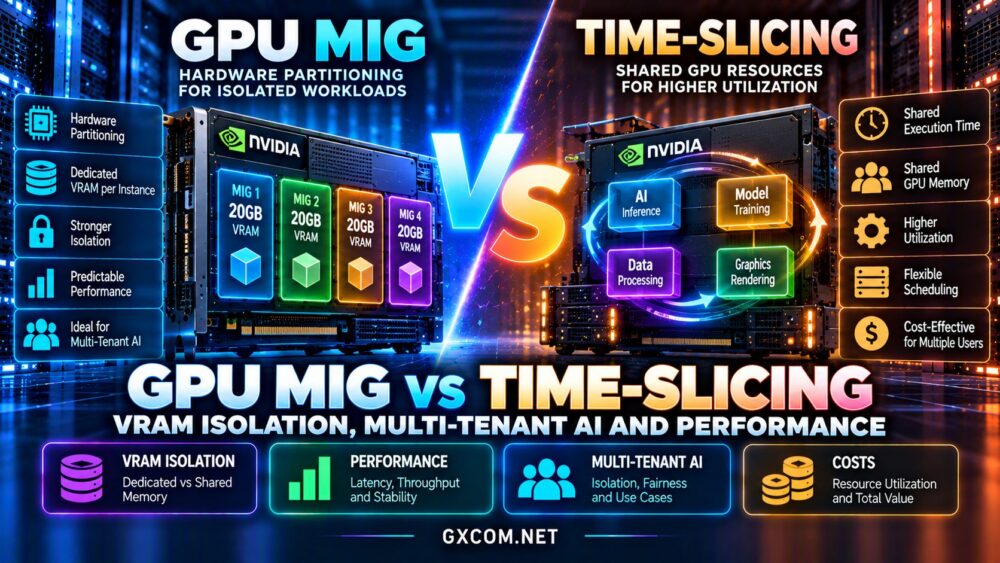
NVIDIA MIG 当受支持的硬件必须处理具有明确内存和计算边界的多项工作负载时,这是更优的选择。它将物理 GPU 资源划分为可独立寻址的实例。.
GPU 时间片分配 当多个可信应用程序需要间歇性地访问 GPU,且无需严格的性能隔离时,此方案非常有用。工作负载共享底层资源,而非获得专用的硬件分区。.
对于生产环境中的 AI 服务,应根据内存需求、延迟目标和工作负载隔离来选择,而不仅仅取决于能够访问 GPU 的容器数量。.
我们的 NVIDIA GPU 服务器供应商指南 提供了更多基础设施选项。.
什么是 NVIDIA 多实例 GPU?
多实例 GPU(简称 MIG)是 NVIDIA 的一项技术,它将受支持的物理 GPU 划分为多个硬件隔离的实例。.
每个实例都会获得预先分配的 GPU 计算资源和内存。这有助于减少在同一加速器上运行的独立应用程序之间的干扰。.
例如,只要 GPU 支持这些配置,操作员就可以为内存需求不同的推理服务分配不同的 MIG 配置文件。.
MIG 不会创建无限数量的分区。分区的数量、大小以及支持的组合取决于具体的加速器型号和代数。.
支持的系列包括部分NVIDIA A100、A30、H100、H200以及更新款的数据中心GPU。兼容性需参照NVIDIA当前的MIG支持列表进行核对。.
什么是 GPU 时间片分配?
GPU 时间片分配通过交错执行多个应用程序,使它们能够共享对单个 GPU 的访问权限。.
在 Kubernetes 中,NVIDIA 设备插件可以发布多个由同一台物理加速器支持的共享资源副本。.
这些副本是调度分配,而非独立的物理 GPU。.
与MIG不同,普通的NVIDIA设备插件时间片划分不会在副本之间建立独立的GPU内存或故障隔离边界。.
应用程序会争夺可用的显存和计算资源。内存占用较大的进程可能会影响共享该设备的其他工作负载。.
因此,时间片分配更适合于内存需求可控、且基于协作且值得信赖的应用程序。.
GPU MIG 与时间切片:技术对比
| 功能 | NVIDIA MIG | 时间切片 |
|---|---|---|
| 资源模型 | 硬件 GPU 分区 | 共享执行访问权限 |
| VRAM 分配 | 由每个 MIG 实例定义 | 共享内存池 |
| 故障隔离 | 实例之间的硬件隔离 | 共享故障域 |
| 性能一致性 | 更强的资源可预测性 | 取决于竞争的工作负载 |
| 硬件支持 | 部分支持MIG技术的GPU | 支持的 GPU 型号范围更广 |
| Kubernetes 集成 | MIG Manager 和设备插件 | 设备-插件共享配置 |
| 最佳匹配 | 隔离的推理服务 | 间歇性可信工作负载 |
实际性能仍取决于 GPU 代数、分区配置、驱动程序版本以及应用程序的行为。.
VRAM隔离:最重要的区别
GPU 内存决定了模型能否加载、能维护多少 KV 缓存,以及能并发处理多少个请求。.
在 MIG 中,应用程序会获得与其分配的实例关联的内存容量。其他 MIG 租户无法直接占用该分区已分配的 VRAM。.

这使得针对需要可预测模型驻留时间的服务进行容量规划变得更加容易。.
时间片分割带来的内存风险
在普通的时间片分配机制下,多个进程会访问同一块物理内存池。即使声明了多个 GPU 副本,也不会将 VRAM 划分为保证完全相等的份额。.
如果总分配量超过可用内存,应用程序可能会遇到 CUDA 内存不足错误。.
管理员必须控制工作负载的分配、应用程序的内存消耗以及并发情况,以避免超额订阅。.
内存评测结果: 当需要强制执行硬件内存边界时,MIG是更优的选择。时间片分配则需要更高的信任度和更紧密的运行协调。.
多租户人工智能:隔离与“噪音邻居”
多租户人工智能平台通常通过共享的基础设施为不同的客户或应用程序提供服务。.
一个租户可能会产生持续的推理流量,而另一个租户则仅偶尔进行实验。.
如果没有适当的隔离措施,相互竞争的工作负载可能会影响响应时间、内存可用性以及服务可靠性。.
MIG 提供专用的硬件资源分区,有助于建立更可预测的性能边界。.
时间片技术以灵活的共享访问方式取代了这些边界,当工作负载时间短、间歇性且受集中控制时,这种方式能发挥良好效果。.
然而,硬件隔离并非一种完整的安全架构。租户隔离仍需配合适当的容器、操作系统、网络及访问控制措施。.
推理性能:吞吐量与延迟
最佳的资源共享方式取决于您的优先级是请求总完成数还是响应时间的一致性。.
当多个应用程序同时运行且加速器原本会处于空闲状态时,时间片分配可提高 GPU 的利用率。.
但并发的工作负载可能会争夺执行时间,从而在需求激增时导致延迟波动。.
MIG 可以减少跨分区干扰,尽管较小的实例在计算能力和内存容量方面都不如完整的 GPU。.
LLM 推理与模型规模
在选择 MIG 配置文件之前,请根据目标上下文长度计算模型权重、运行时缓冲区和 KV 缓存所需的内存。.
一个能完全容纳于完整 GPU 中的模型,可能无法容纳于较小的 MIG 实例中。.
对于大型语言模型,完全分配单张 GPU 或多 GPU 部署可能更为合适。.
我们的 AI GPU VPS 服务商对比 探讨了相关的部署方案。.
Kubernetes 的 GPU 共享与调度
NVIDIA GPU Operator 和 Kubernetes 设备插件提供了用于管理 MIG 资源和共享 GPU 访问权限的机制。.
借助 MIG,管理员可以配置受支持的实例配置文件,并将它们作为可调度资源对外提供。.
通过时间切片,设备插件可以发布底层 GPU 资源的多个副本。.
增加副本数量可以使更多 Pod 请求共享访问权限,但不会增加物理 GPU 的容量。.
监控共享 GPU 工作负载
跟踪 GPU 内存利用率、应用程序延迟、吞吐量、错误率以及资源饱和度。.
在使用设备插件的时间片切分时,某些按容器计的 GPU 监控功能会受到限制,因此请在部署前验证可观测性。.
对于生产集群,应制定准入策略和工作负载限制,以防止某项服务占用过多的共享基础设施资源。.
那么 CUDA MPS 呢?
CUDA 多进程服务(MPS)是 NVIDIA 用于共享 GPU 执行资源的另一种机制。.
不应将其与普通的时间片或MIG混淆。.
MPS 可以协调多个 CUDA 客户端,并在受支持的配置下强制执行某些内存和计算限制。.
其功能、限制以及与 Kubernetes 的集成方式与硬件 MIG 分区有所不同。.
在组合使用共享技术或假设某种部署模式受支持之前,请先查阅最新的 NVIDIA 文档。.
GPU 硬件兼容性
并非所有的 NVIDIA 加速器都支持 MIG。.
例如,尽管NVIDIA L4和L40S GPU是功能强大的推理加速器,但它们并不支持MIG功能。.
相比之下,受支持的 A100 和 H100 配置可以暴露 MIG 配置文件。.
即使在同一受支持的产品系列内,可用的配置文件和软件要求也可能有所不同。.
请阅读我们的 NVIDIA L4 与 L40S 对比 用于评估替代的推理硬件。.
GPU MIG 与时间切片成本的比较
共享GPU可以提高利用率,但最便宜的配置未必是最经济的。.
MIG 可以通过为不同工作负载分配大小合适的分区来减少容量浪费。.
当应用程序仅占用GPU时间的一小部分时,时间切片可能是一个不错的选择。.
然而,资源争用、请求失败以及不可预测的延迟可能会增加运营服务的实际成本。.
计算每次成功推理请求的成本,包括计算租用费、存储费、数据传输费和运营开销。.
如需更全面的预算规划,请参阅我们的 经济实惠的GPU服务器指南.
值得比较的GPU云服务提供商
RunPod:GPU 部署与推理
RunPod 为人工智能开发和推理工作负载提供基于GPU的云基础设施。.
评估可用的 GPU 型号、部署选项,以及您选择的产品是提供对设备的完全访问权限,还是提供受管共享抽象层。.
请不要以为租用 A100 或 H100 就能自动获得配置 MIG 的权限。.
Vast.ai:市场平台上的 GPU 算力
Vast.ai 提供基于市场平台的GPU租赁服务,其配置取决于主机。.
这对于实验和灵活的容量规划可能很有帮助,但需验证隔离性、可用内存、主机策略以及中断风险。.
Vultr:云端 GPU 基础设施
Vultr 提供适用于评估专用加速器部署的云基础设施和GPU产品。.
购买前,请确认当前的 GPU 库存以及支持的虚拟化或共享模式。.

GPU Mart:GPU 虚拟专用服务器和独立服务器
GPU Mart 对于正在比较 GPU VPS 和专用 GPU 基础设施的买家而言,这是一种另一种选择。.
请检查所选服务是否支持实际加速器、管理权限以及硬件分区。.
如需了解各供应商层面的采购对比情况,请阅读我们的 RunPod 与 Vast.ai 对比分析.
如何公平地对GPU共享进行基准测试
部署相同的模型和推理软件,然后分别测试全GPU运行、受支持的MIG配置文件以及时间片访问。.
统计每秒成功请求数、p95和p99延迟、VRAM占用量以及失败率。.
逐步增加并发用户数,以确定竞争程度达到无法接受的临界点。.
在持续载荷条件下重复测量,并纳入符合实际的模型载荷行为。.
最后,根据您要求的服務水平,计算每项已处理请求的运营成本。.
常见问题解答
GPU 时间片分割会隔离 VRAM 吗?
不。普通的 NVIDIA 设备插件时间片分配机制不会在共享副本之间提供硬件内存隔离。.
MIG 比时间切片更快吗?
并非绝对如此。MIG 提供了更强的资源隔离能力,而总吞吐量则取决于工作负载规模、分区配置以及 GPU 利用率。.
NVIDIA L40S 能否使用 MIG?
不,L40S 并非支持 MIG 的 GPU。.
MIG 和时间片技术可以结合使用吗?
是的,某些 NVIDIA GPU Operator 配置可以对 MIG 资源应用时间切片,但需视硬件和软件的支持情况而定。.
对于多租户推理,哪种方案更好?
当需要可预测的内存分配和更强的资源隔离时,通常更推荐使用MIG。时间片分配则适用于能够容忍竞争的协作型工作负载。.
最终结论:MIG 还是时间片?
该 GPU MIG 与时间切片 决策取决于您的应用程序需要多高的隔离度,以及它们利用 GPU 资源的效率如何。.
选择 MIG 适用于支持多种工作负载的硬件,这些工作负载需要明确的显存分配以及更可预测的性能。.
选择 时间片 当可信应用程序的需求具有间歇性,且能够容忍共享内存和执行资源时。.
比较 RunPod, Vast.ai、Vultr 和 GPU Mart 根据具体的 GPU 型号以及可用的共享控制选项而定。.
在确定采用某种架构之前,应先对实际推理工作负载进行基准测试。只有在可靠性和应用程序性能仍处于可接受水平的情况下,更高的利用率才能创造价值。.