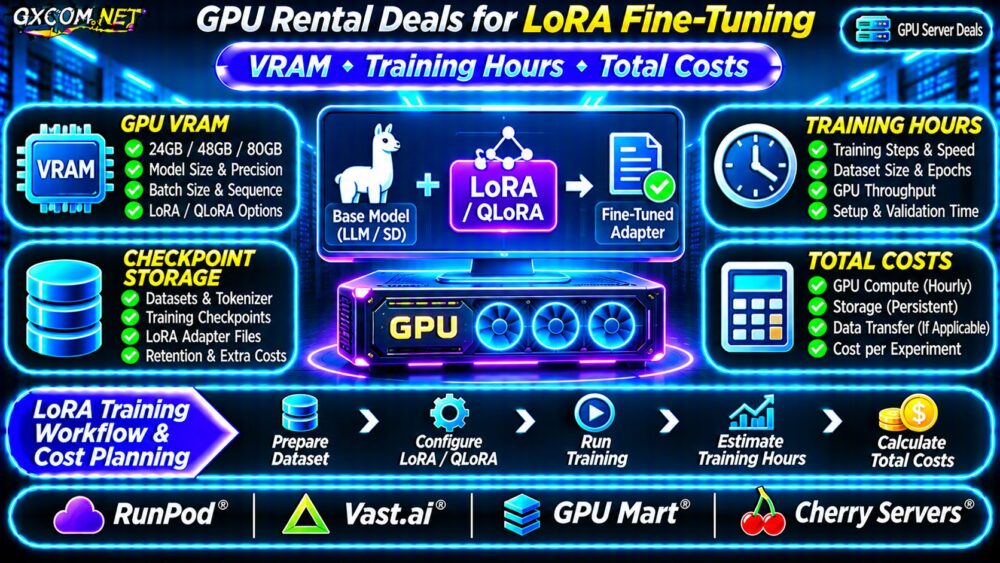
适用于LoRA微调的GPU租赁方案 虽然这可以降低定制语言模型训练的成本,但最低的每小时GPU价格并不一定意味着最终的训练成本最低。视频内存、模型精度、数据集规模、训练吞吐量以及存储费用都会影响最终的账单金额。
对于将语言模型适配到特定任务的开发者而言,在24GB GPU和80GB加速器之间做出选择时,应首先考虑训练配置,而非硬件品牌。
本指南介绍了 LoRA 和 QLoRA 的资源需求,估算了训练时长,对比了四家经认证的 GPU 服务商,并展示了如何计算实验总成本。
为什么LoRA改变了GPU租赁要求
低秩适配(LoRA)通过训练相对较小的适配矩阵来对模型进行微调,同时保持原始模型权重冻结。与完全微调相比,这减少了可训练参数的数量以及相关的优化器内存占用。
然而,基础模型仍然会占用GPU内存,且训练过程需要激活函数、临时缓冲区及其他资源。LoRA并不能自动让每个大型模型都适配于低成本的GPU。
QLoRA 将低秩适配器与量化后的基础模型权重相结合,通常采用 4 位加载方式。这可以降低内存需求,但兼容性和数值行为取决于具体模型和训练框架。
LoRA 微调需要多少 VRAM?
GPU 内存需求取决于参数个数、权重精度、序列长度、微批次大小、优化器配置以及梯度检查点。
仅供参考,一个拥有80亿个参数的模型,按每个参数2字节计算,其基础权重约为16GB,这还不包括训练开销。在理想化的4位存储方案下,扣除量化元数据和其他分配空间后,所需空间约为4GB。
这两个数字均不能代表完整的训练记忆需求。
24GB、48GB 和 80GB GPU 选项
- 24GB 显卡: 适用于较小模型的候选模型以及经过精心配置的QLoRA实验。
- 48GB 显卡: 为模型权重和激活函数留出更多空间,并提供更灵活的训练配置。
- 80GB 显卡: 对于大型模型、较长的序列或内存消耗较大的实验,值得进行评估。
这些是采购类别,并非保证的型号尺寸限制。在预留容量之前,请先测试实际架构和配置。
如需了解更多关于内存规划的信息,请阅读我们的 LLM GPU 内存与服务器配置指南.
LoRA 训练时长:什么因素决定了运行时间?
训练时长取决于数据集的令牌数、有效批量大小、训练轮数、模型架构、GPU吞吐量以及数据处理开销。两块VRAM容量相同的GPU在执行同一实验时,运行速度可能不同。

初始化后,测量每秒的实际训练步数。将剩余步数乘以观测到的步时,然后预留出用于评估、检查点保存和潜在重试的时间。
根据试运行估算工时
假设某项假设性的训练任务需要 2,400 个优化器迭代步,而一名具有代表性的飞行员平均每步耗时 9 秒。不包括设置、验证和检查点操作在内,预计训练阶段将耗时 6 小时。
在做出更大规模的租赁承诺之前,通过一个简短的试点项目,还可以发现内存不足的错误以及意料之外的存储需求。
对比四家GPU租赁服务商
RunPod, Vast.ai, GPU Mart, ,以及 Cherry 服务器 提供了值得探讨的各种基础设施方案。纳入这些方案并不意味着已验证的针对 LoRA 的折扣,也不意味着硬件供应有保障。
RunPod:基于容器的 GPU 工作流
RunPod 这对在 GPU 基础设施上部署容器化训练环境的开发人员具有参考价值。请评估可用的加速器型号、持久化存储选项、实例生命周期控制以及计费条件。
请确认您的训练图像、CUDA 依赖项和检查点工作流与所选环境兼容。
Vast.ai:市场平台上的 GPU 选择
Vast.ai 该功能允许开发者比较市场中各主机商提供的GPU方案。不同列表的定价和运行特性可能存在差异,因此主机商的可靠性及中断处理条款显得尤为重要。
检查 GPU 内存、CPU 分配、磁盘空间、网络性能和主机可用性。在使用可能中断的服务时,请频繁进行检查点保存。
GPU Mart:GPU 虚拟专用服务器(VPS)和服务器选项
GPU Mart 对于正在比较 GPU VPS 和服务器配置的开发者而言,这也是另一个值得考虑的选择。请仔细查看该产品的加速器、操作系统、存储以及租赁期限要求。
请确认所选实例支持所需的训练软件,不要假设所有 GPU 产品都具备相同的功能。
Cherry 服务器:专用基础设施的考虑因素
Cherry 服务器 对于正在考虑部署专用 GPU 基础设施或开展长期项目的团队而言,这值得深入探讨。请确认可用的配置方案、资源调配安排、管理职责以及合同条款。
专用算力可能适合持续性工作负载,但对于短期实验,应将其与灵活的按小时计费方案进行比较。
计算 LoRA 微调的总成本
实验的实际成本包括 GPU 计算、保留存储、相关的数据传输、准备时间、失败的运行以及检查点管理。
请使用以下公式:
实验总费用 = GPU租赁费 + 存储费 + 相关数据传输费 + 其他计费服务。
| 假设性费用 | 配置 A | 配置 B |
|---|---|---|
| GPU每小时费率 | $0.60 | $1.50 |
| 计费的GPU总小时数 | 12 | 5 |
| GPU 计算成本 | $7.20 | $7.50 |
| 仓储费及其他费用 | $2.00 | $1.00 |
| 实验总费用 | $9.20 | $8.50 |
这些是虚构的规划场景,并非供应商报价或实测基准。在所述假设条件下,配置 B 的每 GPU 小时成本更高,但每项完成实验的成本更低。
使用我们的工具比较实际报价 GPU租赁方案及部署成本对比.
存储、检查点和隐藏的 GPU 费用
训练存储必须能够容纳基础模型的下载文件、数据集、分词器文件、临时输出以及已保存的适配器。完整的训练状态检查点所需的空间可能远大于仅包含适配器的导出文件。
在 GPU 计算停止后,持久卷仍可能产生费用。请确认停止、删除或重新创建实例是否会影响存储的文件。
对于被中断的作业,检查点频率会带来一种权衡:频繁保存会消耗时间和存储空间,而保存频率过低则会增加工作丢失的风险。
请查看网络传输费用以及下载模型权重所需的时间。在反复创建短暂存在的实例时,这些费用可能会产生影响。

如何找到性价比更高的 LoRA GPU 租赁服务
- 在进行扩展之前,先对一种具有代表性的培训配置进行基准测试。
- 在支持且符合内存限制的情况下,请使用 QLoRA。
- 减少不必要的序列长度,并避免过大的微批次。
- 按计费的每GPU小时追踪成功的训练步骤。
- 将重要的检查点存储在一次性实例存储之外。
- 在确认数据保留后,终止未使用的计算资源。
如需了解 GPU 基础设施的替代方案,请浏览我们的 GPU服务器租赁优惠 类别。.
常见问题解答
24GB 显存对 LoRA 微调来说够用吗?
对于某些较小的模型和经过优化的 QLoRA 配置而言,这可能已经足够。模型架构、序列长度以及训练设置决定了其实际可行性。
A100 是否总是比 RTX 显卡更划算?
不。内存容量更大的加速器能够支持较小GPU无法处理的工作负载,但成本效益取决于实际运行时间和总费用。
QLoRA 是否总能降低训练成本?
不一定。较低的内存占用或许能使用更廉价的硬件,但量化开销、训练速度和兼容性都会影响最终的经济效益。
最终裁决
针对 LoRA 微调的最佳 GPU 租赁方案应兼具充足的显存、可靠的训练吞吐量、透明的计费方式以及易于管理的检查点存储空间。
将 RunPod、Vast.ai、GPU Mart 和 Cherry Servers 与您的实际模型和数据集进行对比。先进行基准测试,计算每次完成实验的成本,然后选择能带来可持续训练价值的租赁配置。