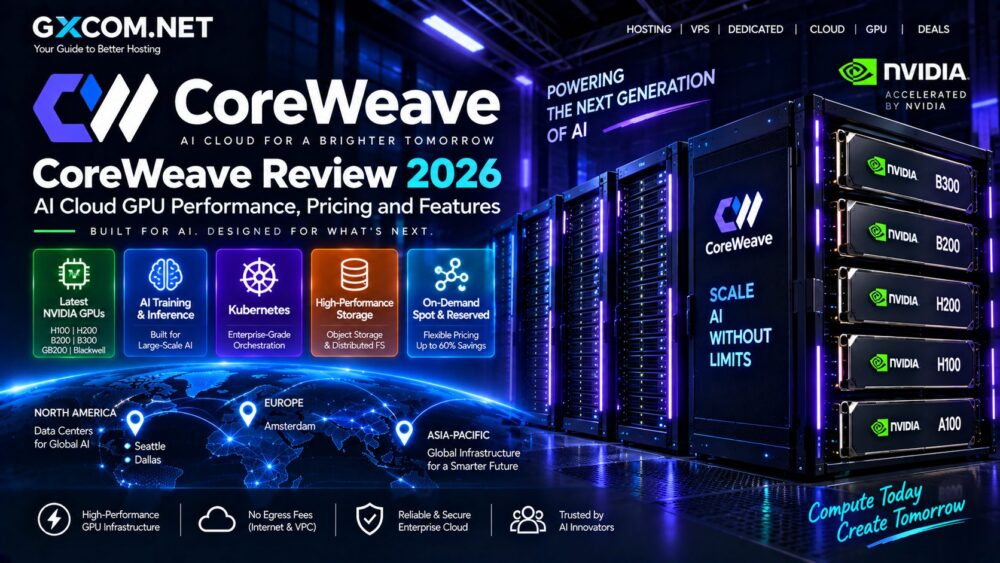
CoreWeave 已成为人工智能基础设施领域最重要的专业云平台之一。与支持数千种互不相关服务的通用云不同,CoreWeave 针对加速计算、大型 GPU 集群、AI 训练和推理进行了深度优化。在本文中 CoreWeave 2026年评测, 我们将深入探讨其最新的 NVIDIA GPU、AI 云性能、按需和竞价定价、Kubernetes、存储、网络,以及该平台最适合处理的工作负载。.
GPU产品组合现已从成熟的NVIDIA A100和H100基础设施扩展至H200、B200、B300、GB200 NVL72以及RTX PRO 6000 Blackwell系统。CoreWeave还正在围绕NVIDIA的下一代Vera Rubin架构构建基础设施。.
这使得CoreWeave与廉价的单GPU交易平台截然不同。其最主要的应用场景是需要大规模AI基础设施的企业,特别是分布式训练、生产推理和GPU集群。.
最后更新时间:2026年9月。GPU的价格和供应情况可能迅速变化。在部署生产工作负载之前,请务必核实所选区域和容量。.
CoreWeave 2026 年评测:快速概览
| 功能 | CoreWeave Cloud |
|---|---|
| 主要重点 | 原生AI云和加速计算 |
| GPU 产品组合 | A100、H100、H200、B200、B300、GB200 和 RTX PRO 6000 Blackwell |
| 计算模型 | 按需、现货和预留容量 |
| 集装箱 | CoreWeave Kubernetes 服务 |
| 存储 | AI 对象存储与分布式文件存储 |
| 互联网数据传输 | 根据目前公布的定价,此项不收费Simplified Chinese (Mainland) |
| 主要工作负载 | AI训练、推理、大型语言模型(LLMs)和高性能计算(HPC) |
| 最适合 | 人工智能初创公司、研究团队和大型GPU工作负载 |
什么是CoreWeave?
CoreWeave 是一家主要专注于加速计算的云基础设施提供商。.
该平台并未将GPU视为传统CPU云的微小补充,而是围绕人工智能和计算密集型工作负载的需求进行设计。.
其基础设施包括:
- NVIDIA GPU 实例
- CPU 实例
- Kubernetes
- AI推理基础设施
- 分布式存储
- 对象存储
- 高性能网络
- 预留的GPU容量
这一专业方向使 CoreWeave 能够满足那些已无法满足单个 GPU 实例需求、且需要能够扩展训练或推理工作负载的集群的组织的需求。.
正在研究更广泛市场的读者可以对比其他 GPU云服务提供商 在选择平台之前。.
CoreWeave GPU 云性能
仅凭GPU型号并不能决定AI的性能。.
大规模工作负载还取决于网络、存储吞吐量、CPU 资源、内存容量以及 GPU 在各节点之间通信的效率。.
CoreWeave 围绕这一问题构建其基础设施,而不是简单地将 GPU 连接到普通的虚拟机上。.
例如,其HGX H100和H200集群采用了NVIDIA Quantum-2 InfiniBand NDR网络,其配置专为分布式训练而设计。.
在训练大型语言模型时,这一点尤为重要,因为如果 GPU 集群的互连性能不佳,可能会导致昂贵的加速器处于等待数据或同步的状态。.
2026年CoreWeave GPU定价
定价是任何……的核心 CoreWeave 2026年评测. CoreWeave 目前公布了多种 GPU 配置的按需定价和现货价格,但部分最新系统需联系销售部门。.
2026年9月核查的北美地区代表性费率包括:
| GPU | GPU 数量 | 每块GPU的VRAM | 按需价格 |
|---|---|---|---|
| NVIDIA A100 | 8 | 80 GB | $ 21.60/小时 |
| NVIDIA HGX H100 | 8 | 80 GB | $49.24/小时 |
| NVIDIA HGX H200 | 8 | 141 GB | $50.44/小时 |
| NVIDIA HGX B200 | 8 | 180 GB | $68.80/小时 |
| RTX PRO 6000 Blackwell 高内存版 | 8 | 96 GB | $ 20.00/小时 |
| GB200 NVL72 实例 | 4* | 186 GB | $42.00/小时 |
| HGX B300 | 8 | 270 GB | 联系销售部 |
*CoreWeave 将 GB200 的配置描述为两个 GB200 Superchip,每个 Superchip 包含一个 Grace CPU 和两个 Blackwell GPU。价格为 2026 年 9 月的快照,可能会有变动。.
CoreWeave Spot GPU 定价
当工作负载能够容忍中断时,现货算力可大幅降低 GPU 成本。.
目前北美地区的例子包括:
- A100 8-GPU 实例——约 $9.65/小时
- H100 8-GPU 实例——约 $19.71/小时
- H200 8-GPU 实例——约 $20.93/小时
- B200 8-GPU 实例——约 $34.11/小时
- B300 8-GPU 实例——约 $35.84/小时
按需基础设施对于容错批处理、实验以及能够对进度进行检查点记录的工作负载而言极具吸引力。.
如果中断会导致无法接受的生产停机或培训进度出现重大倒退,那么这种做法就不太合适。.
CoreWeave 预留容量
对于GPU需求可预测的组织而言,可以考虑预留容量,而不是持续支付按需价格。.
CoreWeave 目前宣传的承诺用量折扣最高可达 60%,相比按需定价。.
在规模化应用中,经济因素可能至关重要。一个持续运行的八张GPU集群每月可产生数千GPU小时,因此采购模式对总成本的影响可能与标示的每小时费率同样显著。.
CoreWeave 上的 NVIDIA H100 和 H200
尽管Blackwell已经问世,H100和H200依然是重要的AI加速器。.
H100 广泛应用于生成式 AI 的训练和推理,而 H200 将 GPU 内存提升至 141 GB,并采用了 HBM3e 内存。.
对于大型语言模型而言,额外的内存尤为宝贵,因为这些模型的权重、键值缓存和批量大小可能会消耗海量的显存。.
CoreWeave 的 HGX 基础设施旨在通过高性能网络连接多块 GPU,而非将每块加速器视为独立的服务器。.
有关这些加速器课程的更多背景信息,请参阅我们的 A100 和 H100 GPU 报道范围。.
NVIDIA B200 和 B300
Blackwell 在 CoreWeave 的 2026 年基础设施战略中变得越来越重要。.
当前的 HGX B200 配置包含 8 个 GPU、每个 GPU 配备 180 GB 显存、128 个 vCPU 以及 2 TB 系统内存。.
CoreWeave 还于 2026 年 3 月正式推出了 NVIDIA HGX B300。.
已公布的 B300 配置将每个加速器的 GPU 内存提升至 270 GB,并配备了 8 个 GPU 和 4 TB 系统内存。.
如此巨大的内存占用量,旨在满足要求严苛的生产级人工智能、强化学习、代理式人工智能及其他工作负载的需求——在这些领域中,模型规模和推理上下文的要求仍在持续增长。.
GB200 NVL72 与机架级人工智能
CoreWeave 还提供 GB200 NVL72 基础设施。.
这标志着思维方式从关注单个GPU转向了机架级系统,在该系统中,加速器、Grace CPU和高速互连技术共同构成一个高度集成的计算平台。.
这些系统面向运行以下模型的组织:这些模型所需的计算能力和内存远超单台传统GPU服务器所能提供的。.
CoreWeave 和 NVIDIA Vera Rubin
CoreWeave 的硬件路线图已超越 Blackwell 阶段。.
2026年6月,该公司宣布已完成NVIDIA Vera Rubin NVL72基础设施的系统级调试和验证。.
Vera Rubin 是 NVIDIA 的下一代机架级 AI 架构,旨在满足日益严苛的自主 AI 和大规模推理工作负载的需求。.
这并不意味着每一位 CoreWeave 客户都能立即按需部署 Rubin 算力。但这确实表明,该公司正在积极围绕 NVIDIA 的新架构进行战略布局。.
CoreWeave Kubernetes 服务
CoreWeave Kubernetes Service(简称 CKS)是该平台的重要组成部分,因为现代人工智能基础设施越来越需要编排功能,而非手动配置的 GPU 服务器。.
Kubernetes 可以协调:
- GPU 工作节点
- 培训岗位
- 推理服务
- 集装箱
- 存储
- 人际网络
- 缩放
这使得 CoreWeave 更适合正在构建生产级 AI 平台的工程团队,而非那些主要围绕通过简单控制面板租用单个 GPU 而设计的服务。.
CoreWeave 存储定价
AI 工作负载可能消耗海量的存储空间,因此仅凭 GPU 的价格无法反映基础设施的总成本。.
CoreWeave 目前公布的存储费率包括:
| 存储产品 | 价格 |
|---|---|
| AI 对象存储 – 热 | $0.06/GB/月 |
| AI 对象存储 – 温存 | $0.03/GB/月 |
| AI 对象存储——冷存储 | $0.015/GB/月 |
| AI 对象存储 – 归档 | $0.0125/GB/月 |
| 分布式文件存储 | $0.070/GB/月 |
Archive 目前显示为“库存有限”,需联系 CoreWeave。.
没有互联网出站费?
CoreWeave 目前公布的定价中,网络服务是一个值得注意的方面。.
该公司目前上市的股票包括:
- 互联网数据传输——免费
- CoreWeave内部数据传输——免费
- VPC – 免费
- NAT 网关 – 免费
公共 IPv4 地址的费用另行列出,每 IP 每月 $4。.
与出站流量成为主要成本组成部分的云架构相比,这可能会从根本上改变需要传输大量模型数据的工作负载的经济性。.
CoreWeave 用于 AI 训练
大规模模型训练是 CoreWeave 最具优势的应用场景之一。.
训练性能取决于能否让多块GPU同时保持高负载运行,这需要加速器之间进行快速通信,并具备能够为集群提供数据的存储能力。.
CoreWeave 将 HGX 系统、InfiniBand 网络、Kubernetes 和分布式存储相结合的方案,正是围绕这些需求而设计的。.
可能的工作内容包括:
- 大型语言模型的训练
- 微调
- 强化学习
- 多模态模型
- 计算机视觉
- 科学计算
CoreWeave 用于 AI 推理
随着人工智能应用从实验阶段迈向实际应用,推理正变得同样重要。.
CoreWeave 公布了其支持的北美配置中单 GPU 推理服务的定价。 例如,根据其推理定价模型,当前价格表显示:H100 GPU 的价格约为每小时 $6.16,H200 为 $6.31,B200 为 $8.60。.
此定价专门针对 CoreWeave 推理平台客户,请勿将其与租赁一台配备 8 个 GPU 的完整 HGX 实例的价格混淆。.
CoreWeave 与 Lambda GPU Cloud 对比
Lambda 和 CoreWeave 均专注于人工智能基础设施领域,因此将二者进行对比,比仅将 CoreWeave 与传统 VPS 服务商进行对比更为恰当。.
Lambda 提供易于使用的 GPU 云实例和以人工智能为中心的基础设施,而 CoreWeave 则特别侧重于大规模集群、Kubernetes、生产环境推理以及机架级系统。.
规模较小的团队应比较实际可用的配置方案,而不是一味认为自己需要尽可能大的集群。.
请阅读我们的 Lambda GPU Cloud 评测 如需详细的替代方案,请参阅。.
CoreWeave 与 RunPod 对比
RunPod 主要面向更广泛的用户群体,这些用户正在寻找易于获取的 GPU Pod、无服务器 GPU 以及独立加速器。.
CoreWeave 的基础设施更侧重于那些在较大规模上运行生产级 AI 的组织。.
对于正在尝试使用 Stable Diffusion 或小型大型语言模型(LLM)的开发者而言,RunPod 的部署模型可能更易于上手。而对于需要协调大规模分布式训练或企业级推理任务的公司来说,面临的基础设施问题则截然不同。.
请参阅我们的 2026年RunPod评测 因其当前的GPU定价和无服务器平台。.
CoreWeave 与 Vast.ai 对比
Vast.ai 则代表了一种截然不同的方法。.
该交易平台汇集了独立主机提供商的GPU算力资源,使用户能够根据硬件配置、可靠性和价格等因素,搜索价格实惠的单台服务器。.
CoreWeave 提供的是专为特定用途设计的云基础设施,而非一个开放的 GPU 交易市场。.
当将实验的每小时成本降至最低作为首要任务时,Vast.ai 具有很强的吸引力。CoreWeave 则更直接地面向那些需要稳定基础设施、编排能力以及大规模 AI 部署的组织。.
我们的 Vast.ai 2026年评测 详细解释了市场模式。.
CoreWeave 的优缺点
| 优点 | 缺点 |
|---|---|
| 专为人工智能工作负载设计 | 对于普通网络托管来说,这有些大材小用 |
| 最新的 NVIDIA GPU 架构 | 大型集群的成本可能会迅速上升 |
| H100、H200、B200 和 B300 | 部分最新产品需要销售联系人 |
| 高性能集群网络 | 需要具备云计算和人工智能基础设施方面的专业知识 |
| 基于 Kubernetes 的编排 | 并非专为初学者使用VPS而设计 |
| 现货价格与预订价格 | 按需工作负载可能会被中断 |
| 目前不收取互联网出站费用 | GPU 的供应情况仍取决于产能和地区 |
哪些人应该考虑使用 CoreWeave?
当 GPU 是工作负载的核心而非仅作为偶尔的需求时,CoreWeave 的作用最为显著。.
典型的应用场景包括:
- 人工智能初创企业
- 机器学习工程团队
- LLM开发者
- 企业级人工智能平台
- 研究机构
- 大规模推理服务
- 分布式模型训练
- HPC 工作负载
哪些人可能会更倾向于选择其他方案?
对于仅需 Linux VPS、WordPress 服务器或低成本开发虚拟机的用户而言,并不需要这类基础设施。.
需要单块低成本GPU的个人开发者,也应对比一下更简单的GPU云平台和市场。.
如需了解有关基础设施选择的更详细说明,请参阅我们的 GPU服务器与云GPU的对比 比较。.
CoreWeave 2026 年评测:最终结论
我们的 CoreWeave 2026年评测 这表明,专业化的AI云基础设施正在以多快的速度超越“租用GPU虚拟机”这一传统概念。.
CoreWeave 现已覆盖 H100 和 H200 系统、Blackwell B200 和 B300 基础设施、GB200 NVL72、RTX PRO 6000 Blackwell、Kubernetes、高性能存储以及生产级推理服务。 其在 Vera Rubin NVL72 上的工作也揭示了该平台未来的发展方向。.
其主要优势在于专业化。计算、网络、编排和存储都是围绕GPU密集型工作负载进行设计的,而非作为次要产品附加到通用托管平台之上。.
其中的权衡在于复杂性和规模。对于仅仅想要一台价格低廉的GPU来偶尔进行实验的用户来说,CoreWeave可能并非理所当然的选择。当AI基础设施成为核心的生产需求,且集群性能、高速网络、存储吞吐量以及对新型NVIDIA架构的访问与每小时GPU价格同样重要时,CoreWeave的优势才得以充分体现。.
对于严肃的人工智能训练和推理部署而言,CoreWeave 应当列入 2026 年待评估的专业 GPU 云平台候选名单。.