
对于许多人工智能和机器学习工作负载而言,GPU云服务已成为不可或缺的组成部分。.
训练大型语言模型、对开源模型进行微调、运行推理、生成图像和视频以及处理大型数据集,这些任务所需的计算能力往往远超传统VPS或基于CPU的云服务器所能提供的水平。.
好消息是,你未必需要自己购买 GPU 硬件。.
GPU云服务提供商允许企业、开发者、研究人员和AI团队按需租用GPU计算资源。根据服务提供商的不同,您可以为短期实验启动单个GPU,为生产工作负载预留多GPU服务器,或部署大型集群以进行分布式AI训练。.
难点在于选择合适的供应商。.
价格固然重要,但GPU型号、VRAM、供货情况、网络、存储、计费、可靠性和部署灵活性同样至关重要。.
GXCOM 评测结论: RunPod 对于灵活的按需 GPU 工作负载尤其具有吸引力;对于希望使用专用 GPU 基础设施的用户而言,Lambda 是一个专注于 AI 的强大选择;而 CoreWeave 则特别适用于要求严苛的生产环境和大规模 AI 工作负载。当 GPU 计算需要与更广泛的企业云架构集成时,AWS、Google Cloud 和 Azure 仍然是重要的选择。.
最佳GPU云服务商对比
| 服务提供商 | 最适合 | 主要优势 |
|---|---|---|
| RunPod | 开发人员与灵活的GPU租赁服务 | 丰富的按需GPU选项 |
| Lambda | AI开发人员和机器学习团队 | 以人工智能为核心的GPU基础设施 |
| CoreWeave | 生产环境中的 AI 工作负载 | 大规模 GPU 基础设施 |
| AWS | 企业级云应用程序 | 广泛的云生态系统 |
| Google Cloud | 人工智能、数据和机器学习 | 强人工智能与数据服务 |
| Microsoft Azure | 企业及微软工作负载 | 企业云集成 |
没有哪家服务商能一概而论地称得上最好。选择合适的平台取决于您是需要偶尔使用 GPU、持续推理、模型训练、多 GPU 集群,还是企业云集成。.
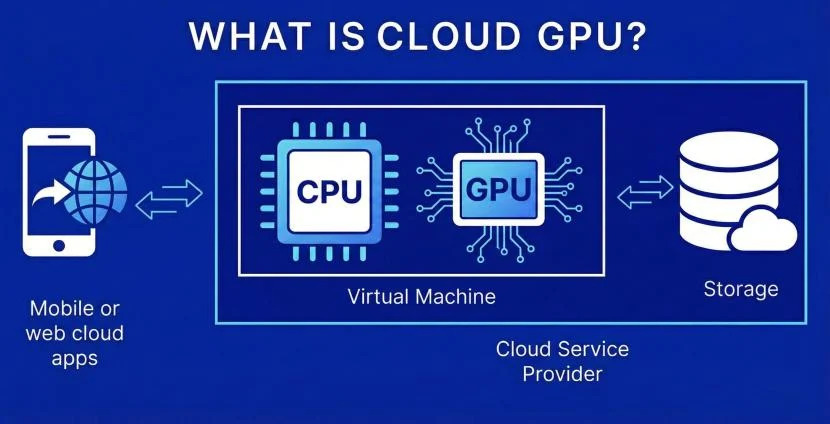
什么是 GPU 云?
GPU 云可提供配备图形处理单元的计算实例,而不仅仅依赖于传统的 CPU。.
GPU 对于高度并行的工作负载特别有效,例如:
- 机器学习
- 深度学习
- 大型语言模型
- AI推理
- 计算机视觉
- 生成式人工智能
- 3D渲染
- 科学计算
用户无需购买实体GPU,而是可以从云服务提供商处租用GPU资源,并根据实际使用情况或约定的容量模式付费。.
GPU云与传统云的对比
对于网站或API而言,一台普通的云虚拟机可能就足够了。.
一项人工智能训练工作负载可能需要多块配备高速内存和高带宽网络的GPU。.
这带来了另一套基础设施要求。.
最重要的因素通常是:
GPU 型号
VRAM
GPU互连
CPU 和系统内存
存储
网络带宽
可用性
价格
1. RunPod
RunPod 已成为面向开发者和小型人工智能团队的、最具影响力的以 GPU 为核心的云平台之一。.
其当前平台为专用 GPU 实例提供 GPU Pod,为推理工作负载提供无服务器基础设施,并为大型任务提供多 GPU 集群。 RunPod表示,其Pod覆盖30多个区域,并提供包括H100、H200、B200、B300和RTX Pro 6000在内的多种GPU配置。.
开发者选择 RunPod 的原因之一在于其灵活性。.
您可以根据工作负载选择不同的 GPU 类型,而不是拘泥于一种企业级架构。.
最适合
- AI实验
- 模型推断
- 微调
- 开发者
- 初创企业
- 短期 GPU 工作负载
优势
- 丰富的GPU选择
- 按需部署
- 灵活的定价模式
- 无服务器推理选项
- 多GPU集群
注意事项
不同的 GPU 环境在价格和供货情况上可能有所不同,因此请比较具体的 GPU 虚拟专用服务器, 在部署工作负载之前,需先确定区域和服务等级。.
GXCOM 视图: 如果优先考虑的是灵活获取 GPU 资源,而非构建大型企业级云架构,RunPod 是值得优先考虑的供应商之一。.
2. Lambda
Lambda 专门专注于人工智能基础设施,而不是将 GPU 仅仅视为另一种云产品。.
其当前的云平台提供 NVIDIA A100、H100、B200、GH200 等 GPU 实例,而其“一键式集群”功能则支持更大规模的互联部署,适用于 AI 训练、微调和推理。.
Lambda 当前的按需服务可部署 1 至 8 个 GPU,而规模更大的“一键式集群”则可从 16 个 GPU 扩展至数千个。.
最适合
- 机器学习团队
- LLM 训练
- 微调
- AI推理
- 研究团队
- 生产环境中的 AI 工作负载
优势
- 以人工智能为中心的基础设施
- 现代 NVIDIA GPU 选项
- 多GPU配置
- 集群支持
- API 和 CLI 访问
注意事项
大型 GPU 集群可能需要经过预订或销售流程,而非简单的自助部署。.
GXCOM 视图: 当人工智能是主要工作负载,且您希望选择一家专注于 GPU 基础设施而非通用云平台的服务提供商时,Lambda 尤其值得关注。.
3. CoreWeave
CoreWeave 是面向大型 AI 工作负载最重要的专业 GPU 云服务提供商之一。.
其当前的基础设施包括 NVIDIA H100、H200、B200、GB200 及其他 GPU 系统,部分配置同时提供按需和竞价资源。.
该平台的设计核心是人工智能计算、存储和网络,而非传统的网站托管服务。.
因此,其基础设施对于需要大规模计算能力的人工智能团队而言,可能更为适用。.
最适合
- 大型人工智能工作负载
- 模型训练
- 大规模推理
- 企业级人工智能
- 多GPU基础设施
优势
- 高度关注人工智能基础设施
- 现代 NVIDIA GPU 系统
- 多GPU环境
- 大规模产能
注意事项
某些配置需通过销售渠道定价,而非简单的自助购买,而且对于小型开发项目而言,其基础设施可能过于庞大。.
GXCOM 视图: CoreWeave 更适合处理严肃的生产级 AI 工作负载,而非仅仅偶尔需要 GPU 进行实验的用户。.
4. 亚马逊网络服务(AWS)
AWS 处理 GPU 计算的方式与“GPU 优先”的供应商有所不同。.
AWS 并未仅专注于 GPU 租赁,而是将加速计算整合到一个更庞大的云生态系统中。.
用户可以访问基于 GPU 的 EC2 实例,同时将这些资源与存储、数据库、网络、监控、安全及其他 AWS 服务相结合。.
对于已经在 AWS 上运营基础设施的用户而言,这种集成可能比 GPU 的每小时基础费率更为重要。.
最适合
- 企业级人工智能
- 现有 AWS 客户
- 大型应用程序
- 复杂的基础设施
- 生产环境部署
优势
- 庞大的云生态系统
- 全面的基础设施服务
- 企业安全与网络
- 广泛的全球基础设施
注意事项
与专注于 GPU 的服务提供商相比,AWS 的复杂程度可能高出许多。.
定价也需要从架构层面进行评估,而不仅仅是关注 GPU 实例的价格。.
GXCOM 视图: 当您的人工智能工作负载是更广泛的 AWS 架构的一部分时,请选择 AWS,而不仅仅是因为它提供了 GPU 实例。.
5. Google Cloud
Google Cloud 特别适用于人工智能、机器学习和数据密集型应用。.
其 Compute Engine 平台支持 GPU 加速的工作负载,而 Google Cloud 还提供了一个更广泛的人工智能和数据生态系统。.
这使得 Google Cloud 对那些正在开发既依赖数据处理、分析又依赖机器学习服务的人工智能应用程序的公司极具吸引力。.
最适合
- 人工智能应用
- 机器学习
- 数据科学
- 企业级人工智能
- 已经使用 Google Cloud 的开发者
优势
- 以人工智能为核心的云生态系统
- Compute Engine 对 GPU 的支持
- 数据与分析服务
- 企业基础设施
注意事项
云托管 当计算、存储、网络以及其他托管服务结合在一起时,定价可能会变得比较复杂。.
GXCOM 视图: 当 GPU 计算成为更广泛的数据和人工智能环境的一部分时,Google Cloud 才更具价值。.
6. 微软 Azure
对于需要将 GPU 计算集成到更广泛的企业环境中的组织而言,Azure 是另一种主要选择。.
其配备GPU的虚拟机可支持人工智能、机器学习、可视化及其他加速工作负载。.
Azure 最大的优势在于它与微软生态系统的集成。.
最适合
- 企业级人工智能
- 微软客户
- Windows 工作负载
- 混合云
- 商业应用
优势
- 企业集成
- 微软生态系统
- 广泛的基础设施服务
- 混合云方案
注意事项
与 AWS 和 Google Cloud 一样,对于简单的独立 GPU 工作负载而言,Azure 可能比专业化的 GPU 云服务提供商更为复杂且成本更高。.
GXCOM 视图: 如果贵公司已经高度依赖微软的服务,那么 Azure 尤其具有吸引力。.
GPU 云服务定价:应比较哪些方面?
要比较显卡的价格,其实出乎意料地困难。.
服务提供商可能会宣传较低的小时费率,但实际费用可能取决于:
- GPU 型号
- GPU内存
- CPU
- 系统内存
- 存储
- 网络流量
- 计费方式
- 地区
- 现货或按需定价
- 最低承诺额
例如,专业服务商当前公布的公开价格显示,不同代GPU以及不同服务商之间的价格存在显著差异。RunPod目前为H100、H200、B200等GPU列出了不同的按需计费价格,而Lambda则分别公布了其H100、B200和A100实例的价格。.
这意味着,你绝不应仅凭标价来比较不同服务提供商。.
H100 与 H200 与 B200:该选择哪款 GPU?
与云服务提供商相比,GPU本身对总成本的影响可能更大。.
NVIDIA H100
对于高强度的人工智能工作负载而言,H100 依然是主要选择之一。.
适用于:
- LLM 训练
- 微调
- 高通量推理
- 深度学习
NVIDIA H200
H200 扩展了 GPU 内存容量,对于大型 AI 模型和内存密集型工作负载极具吸引力。.
NVIDIA B200
Blackwell B200 硬件旨在支持新一代大规模人工智能训练和推理工作负载。.
对于某些应用而言,较新的硬件虽然能显著提升每块GPU的性能,但更高的每小时租赁费用可能会抵消这些收益。.
因此,正确的比较并非:
哪款显卡最快?
但是:
哪款 GPU 能以最低的实际总成本完成我的工作负载?
用于人工智能推理的GPU云
推理与训练不同。.
训练通常需要持续保持较高的 GPU 利用率,且可能运行数小时甚至数天。.
推理可以是:
- 连续的
- 突发性
- 基于API的
- 对延迟敏感
- GPU 服务器评测
正因如此,无服务器 GPU 服务对于某些推理应用而言颇具吸引力。.
以 RunPod 为例,它目前将 Pod 与无服务器 GPU 基础设施分离,并针对推理工作节点单独公布定价。.
对于间歇性的推理工作负载,仅在工作者处于活动状态时付费,可能比维持一台永久运行的 GPU 服务器更为高效。.
用于大型语言模型(LLM)训练的GPU云服务
大型语言模型(LLM)的训练通常需要更多基础设施。.
需要重点考虑的因素包括:
- GPU内存
- GPU互连
- 多GPU扩展
- 存储吞吐量
- 网络带宽
- 检查点存储
- 分布式培训支持
在这个层面上,单GPU云服务器与互联的多GPU集群之间的差异变得非常显著。.
Lambda 目前提供基于互联 NVIDIA GPU 的“一键式集群”,用于更大规模的生产级 AI 训练、微调和推理。.
CoreWeave 同样将其基础设施聚焦于大规模人工智能计算。.
适用于小型AI项目的GPU云服务
并非每个AI项目都需要H100或B200。.
较小的GPU足以满足以下需求:
- 模型实验
- 发展
- 计算机视觉
- Stable Diffusion
- 小型大语言模型(LLM)推理
- 对较小模型进行微调
对于这些工作负载,与租用最新款加速器相比,低成本的 GPU 有时能带来更好的经济效益。.
关键在于使GPU内存和性能与实际工作负载相匹配。.
如何选择最佳的GPU云服务提供商
1. 从显存开始
对于人工智能工作负载而言,显存(VRAM)通常是最重要的规格之一。.
如果模型无法完全装入 GPU 内存,性能损失可能会非常大,甚至可能导致工作负载无法运行。.
不要仅仅因为某款显卡采用了更新的架构就选择它。.
2. 比较总成本
不要只关注GPU的租赁费率。.
计算:
GPU + CPU + 内存 + 存储 + 网络 + 数据传输 + 管理
这样能让你得到一个更切合实际的成本。.
3. 查询空房情况
如果当项目需要时无法调配到廉价的GPU,那么它就毫无用处。.
GPU的供应情况可能会迅速发生变化。.
专业服务提供商可能在某个地区有某些加速器可供使用,而在另一个地区则已售罄。.
4. 比较计费模式
请查看服务提供商是否收取以下费用:
- 每秒
- 每分钟
- 每小时
- 每笔预订
- 现货或可中断电价
对于短时工作负载,精细计费能带来显著差异。.
5. 关注人脉拓展
多GPU训练在很大程度上依赖于GPU之间的通信。.
因此,大型分布式工作负载可能需要专门的高速网络和 GPU 互连技术,而不仅仅是简单地增加更多的独立 GPU 实例。.
6. 考虑存储问题
AI 工作负载可能涉及非常大的模型文件和数据集。.
快速的本地存储、已挂载的卷以及高吞吐量的数据访问可能会成为重要的瓶颈。.
GPU云与自建GPU服务器之比较
在云端租用GPU有以下几个优点。.
您可以:
- 立即开始
- 避免购买大件硬件
- 扩大或缩减产能
- 测试不同的GPU型号
- 避免数据中心基础设施成本
当GPU利用率持续保持较高水平,且企业拥有管理设备的资源时,购买硬件会更为合理。.
正确的选择取决于使用率、资本预算、电费、维护成本以及硬件的预期使用寿命。.
最终裁决
最佳的 GPU 云服务提供商取决于您需要运行的 AI 工作负载的类型。.
RunPod 对于寻求灵活的 GPU 访问权限和多种服务模式的开发者和团队而言,这是一个极佳的选择。.
Lambda 对于主要专注于人工智能和机器学习基础设施的团队而言,这是一个极具吸引力的选择。.
CoreWeave 更适合大型生产级AI工作负载和多GPU基础设施。.
AWS、Google Cloud 和 Azure 当GPU计算需要与更庞大的云架构、企业服务、网络、数据平台以及现有基础设施进行集成时,其吸引力将进一步增强。.
对于规模较小的AI项目而言,最昂贵的GPU很少能自动胜出。.
然而,对于大型模型的训练而言,GPU内存、互连、网络以及多GPU可扩展性变得越来越重要。.
最佳策略是先确定工作负载,其次选择 GPU 类别,然后根据总成本、可用性、性能和基础设施来比较各服务提供商。.
GPU 云服务的定价变化频繁,因此 GXCOM 建议在启动大型 AI 工作负载之前,先查看服务提供商的最新定价和可用性。.
常见问题解答
哪家是最好的GPU云服务提供商?
没有哪一家服务商能适合所有工作负载。RunPod、Lambda 和 CoreWeave 是功能强大的专业型选择,而 AWS、Google Cloud 和 Azure 则适用于大型云架构。.
哪家GPU云服务最便宜?
最便宜的选项取决于 GPU 型号、所在地区、计费方式,以及您使用的是按需、竞价还是其他计费模式。每小时 GPU 价格较低并不一定意味着总成本最低。.
GPU云对人工智能有帮助吗?
是的。GPU云服务使AI团队无需购买实体硬件,即可租用加速计算资源。.
哪款显卡最适合人工智能?
选择合适的GPU取决于具体型号和工作负载。H100、H200和B200专为高要求的AI工作负载而设计,而低成本GPU在开发和小型推理任务中则更为经济实惠。.
H100 比 A100 更好吗?
H100 是专为高要求的人工智能工作负载设计的新一代产品,但其性价比是否更高,则取决于具体的工作负载和租赁价格。.
RunPod 适合 AI 吗?
RunPod 专为 GPU 云工作负载设计,目前提供 Pod、无服务器推理和多 GPU 集群等多种选项,是开发人员和 AI 团队的理想之选。.
Lambda 适合用于机器学习吗?
Lambda 专门专注于人工智能基础设施,目前提供 NVIDIA GPU 实例以及用于训练、微调和推理的大型互联集群。.
CoreWeave 适合处理大型 AI 工作负载吗?
CoreWeave 专注于 GPU 加速的云基础设施,并提供适用于人工智能计算的大型 NVIDIA GPU 配置,因此特别适合处理大规模的训练和推理工作负载。.