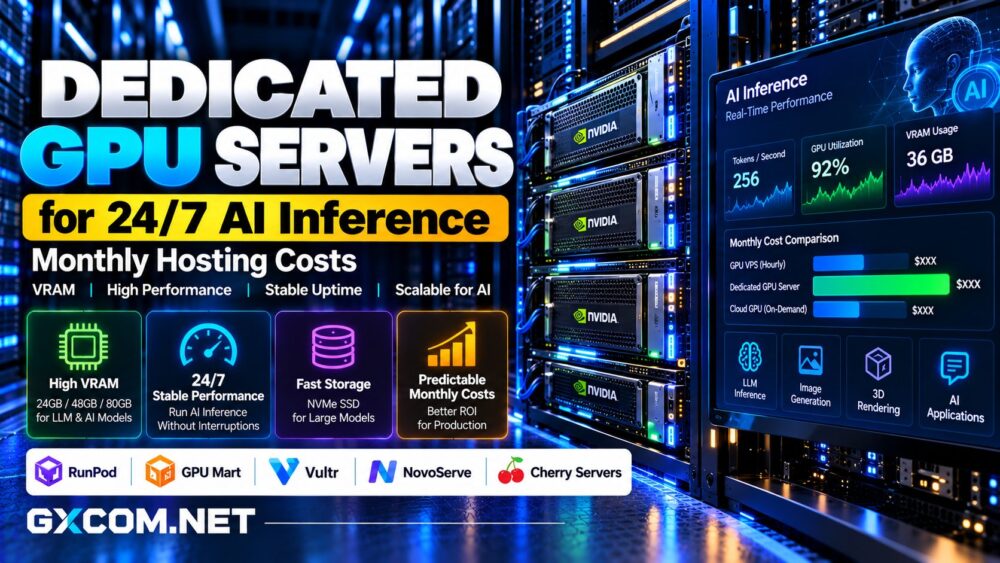
运行人工智能模型会不断改变您采购 GPU 基础设施的方式。对于生产环境中的聊天机器人、推荐引擎或图像生成 API 而言,, 用于人工智能推理的专用GPU服务器 与反复启动按小时计费的云实例相比,这可能带来更可预测的月度成本。.
但专用硬件并不一定更便宜。正确的选择取决于模型的内存需求、流量模式、延迟目标、利用率,以及您的团队能够处理的运维工作量。本指南对比了 GPU Mart, Cherry 服务器, NovoServe,以及 Vultr 在讲解如何估算实际的7×24小时托管费用时。.
在什么情况下选择专用 GPU 主机才是明智之举?
当推理服务需要持续运行并可靠地访问其分配的硬件时,专用 GPU 托管服务能发挥最佳效果。常见的工作负载包括私有语言模型 API、文档助手、语音处理以及连续图像生成。.
专用服务器让客户能够控制一台物理服务器,而不仅仅是预留一个虚拟GPU实例。这一区别对于操作系统管理、存储配置、资源隔离以及长期运行的服务而言至关重要。.
不过,按小时计费的GPU云服务对于原型开发、需求难以预测的情况,以及可在不同请求之间缩减规模的应用程序而言,仍然颇具吸引力。在签订月度合同时,请先对比这两种方案。.
GPU内存比标称规格更重要
推理工作负载需要足够的显存来存储模型权重、运行时开销、激活值以及许多Transformer模型所使用的键值缓存。更长的上下文窗口和更多的并发请求会显著增加内存消耗。.
量化可以减少模型权重的内存需求,但并不能消除所有其他内存开销。一个成功加载的模型仍可能无法达到并发性或延迟目标。.
对于较小的量化模型,24GB的GPU可能就足够了。对于更大的模型或更高的并发量,则可能需要采用48GB、80GB或多GPU配置。这些仅为规划示例,并非通用的模型要求。.
购买前请测试实际模型、上下文长度、批量设置以及目标响应时间。.
值得比较的专用GPU服务器提供商
GPU Mart:GPU 虚拟专用服务器和物理 GPU 服务器
GPU Mart 既提供 GPU VPS 配置,也提供专用 GPU 服务器。购买者应区分这两者:VPS 中的 GPU 直通功能与租用整台物理服务器并非同一产品。.
对于部署持久化推理端点或维护受控软件环境的团队而言,其专属选项值得考虑。请对比可用的 NVIDIA GPU、VRAM、CPU 分配、系统内存、NVMe 存储以及网络配额。.

对于定期的AI服务,请审核 GPU Mart 的 GPU 托管配置 并查阅我们的 GPU Mart 评测 以便更全面地了解服务提供商的背景。.
Cherry Servers:裸机控制
Cherry 服务器 提供配备GPU的专用基础设施。裸机访问适合希望直接控制推理软件、本地模型存储、容器编排和监控的企业。.
应评估整个服务器,而非仅评估 GPU。CPU 资源会影响预处理和请求处理,而内存和高速存储则会影响模型加载及支持服务。.
专用硬件还使客户在操作系统维护、安全更新和部署可靠性方面承担了更多责任。.
NovoServe:定制化专用基础设施
NovoServe 当部署需要定制化基础设施或持续处理工作负载时,这是一家值得考虑的专用服务器提供商。配备GPU的配置应向提供商确认,而非默认所有地点均提供此类配置。.
请询问确切的加速器型号、内存容量、服务器位置、网络服务承诺、配置时间表以及月度报价。定制需求可能会影响可用性和价格。.
这种方案适合那些能够预测稳定的推理需求,并且愿意在下单前商讨具体服务器配置的组织。.
Vultr:比较云GPU与裸机
Vultr 提供 GPU 云基础设施以及精选的裸机 GPU 选项。在决定选择专用物理算力还是更灵活的部署模式时,该服务提供了有用的对比参考。.
对于流量波动较大的情况,云端 GPU 可能有助于降低承诺风险。对于可预测且持续的工作负载,请对比可用的裸机方案及其每月总费用。.
确认所列出的实例是虚拟化实例还是专用实例,并了解其在各地区的可用性及计费条件。.
如何计算每月的 GPU 推理成本
请以完整的月度账单为依据,而非仅参考广告中列出的GPU价格。账单中应包含服务器租赁费、持久化存储费、网络超额费用、备份服务费、软件费以及任何必要的运维支持费用。.
月度成本 = 服务器租赁费 + 其他基础设施费用 + 运营费用
一个持续运行的按小时计费实例,在一个30天的月份中大约会累积720个计费小时。假设每小时费用为$1.20,仅计算费用就需$864。 假设每月租用的 $700 专用服务器看似更便宜,但这仅在它能提供相当的推理吞吐量和可靠性时才成立。.
这些数字仅用于说明计算过程,并非供应商的当前报价。.
计算每百万个产出代币的成本
对于语言模型 API,每百万输出令牌的成本通常比每小时 GPU 价格更有参考价值。应在符合实际的并发条件下测量已完成的输出令牌数量,包括请求排队和请求失败的情况。.
每百万产出代币的成本 = 月度相关成本 / 月度产出代币 × 1,000,000
假设某项服务每月花费 $900,并产出 9000 万个输出代币。其基础设施成本为每 100 万个输出代币 $10,其中不包括未计入 $900 总金额的任何费用。.
在比较服务器时,应采用相同的模型、精度、上下文长度和延迟目标。除非额外的吞吐量能够抵消其成本,否则更快的硬件并不一定更具性价比。.
利用率、并发性和可用性
高利用率可以改善单位经济效益,但让 GPU 接近饱和状态运行可能会增加队列等待时间,从而影响用户体验。请综合跟踪吞吐量、首次令牌响应时间、尾部延迟、内存使用情况和错误率。.
对于全天候运行的应用程序,请在预算中预留用于监控、备份、事件响应和备用容量的费用。一台专用服务器并不一定能自动提供高可用性。.

当停机时间会对客户造成实质性影响时,应考虑部署第二个节点或制定故障转移策略。虽然这会增加成本,但对于生产环境的服務承诺而言,此举可能是必要的。.
我们的 GPU 与 CPU 服务器的对比 解释了在何种情况下加速是合理的,而我们的 NVIDIA GPU 服务器供应商指南 提供了更广泛的硬件选择背景。.
如何选择合适的月度GPU套餐
首先,使用您的实际模型和具有代表性的用户请求进行基准测试。确定可接受的最低吞吐量和延迟,然后计算正常时段和高峰时段所需的GPU数量。.
针对匹配的VRAM容量、CPU、RAM、存储、流量和支持服务,请求报价。请核对合同期限、取消条款、开通时间以及硬件更换政策。.
如果需求不确定,在预留专用容量之前,先试用按小时计费的模式。对于已投入运行的服务,请将按月计费的专用价格与实际云资源消耗量进行比较。.
探索我们的 经济实惠的GPU服务器指南 有关其他购买注意事项。.
最终裁决
在持久型 GPU 托管方面,GPU Mart 和 Cherry Servers 值得对比,而 NovoServe 可能更适合寻求定制化专用配置的买家。Vultr 提供了一份有用的云服务与裸机服务对比参考。.
最好的 专用于全天候(24/7)AI推理的专用GPU服务器 是指能够以最低的可持续月度成本满足实际延迟和可用性目标的那款——而不仅仅是VRAM容量最大或标价最低的那台服务器。.