

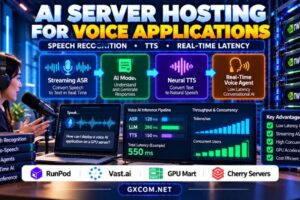
面向语音应用的AI服务器托管:语音识别、文本转语音(TTS)及实时延迟
语音应用的AI服务器托管所需的基础设施策略与普通聊天机器人部署有所不同。语音识别、文本转语音(TTS)和实时语音代理必须以足够快的速度处理音频,才能支持自然的对话。即使是性能强大的GPU……
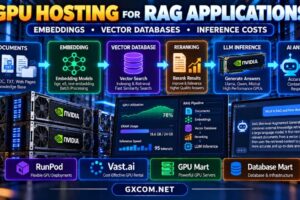
RAG 应用的 GPU 托管:嵌入向量、向量数据库与推理成本
针对 RAG 应用的 GPU 托管服务可以加速文档嵌入、重新排序和语言模型推理,但通常没有必要为每个组件都租用 GPU。检索增强生成(RAG)将可检索知识与大型语言模型(LLM)相结合,从而产生多种……
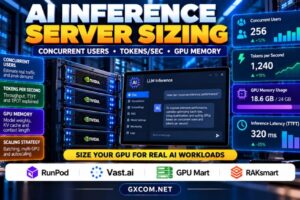
AI推理服务器规格规划:并发用户数、每秒令牌数和GPU内存
AI推理服务器的规格规划应以用户期望的体验为出发点,而非您想要租用的GPU型号。一个仅需处理偶尔咨询的聊天机器人,其配置需求与一个需要同时处理数百个请求的API截然不同……
在 GPU 服务器上对大型语言模型进行微调:LoRA、QLoRA 及硬件要求
为大型语言模型(LLM)的微调选择合适的 GPU 基础设施,需要采取与普通 LLM 推理不同的方法。训练工作负载必须考虑模型权重、梯度、优化器状态、激活值、序列长度以及批量大小。由于……
LLM 托管要求:GPU 显存、量化及服务器配置指南
在将大型语言模型部署到 GPU 服务器、云实例或私有基础设施之前,了解大型语言模型的托管要求至关重要。如果选择的 GPU 内存过少,可能会导致模型无法加载;而如果租用过多的……
AI推理服务器托管:GPU内存、延迟与成本对比
对于部署大型语言模型、AI聊天机器人、检索增强生成(RAG)应用程序以及生产级AI API的开发人员和企业而言,选择合适的人工智能推理服务器托管方案至关重要。与AI训练不同,推理主要侧重于运行……
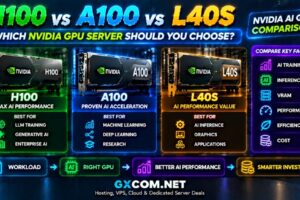
H100 对比 A100 对比 L40S:您应该选择哪款 NVIDIA 服务器 GPU?
在构建人工智能基础设施时,选择合适的 NVIDIA GPU 是至关重要的决策之一。NVIDIA H100、A100 和 L40S 是最广泛用于人工智能、机器学习和高性能计算的加速器……
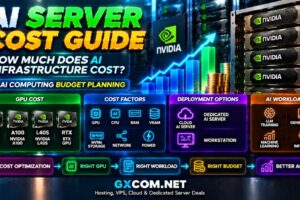
AI 服务器成本指南:AI 基础设施需要多少成本?
对于开发人工智能应用、机器学习模型和大型语言模型的企业而言,人工智能基础设施已成为最重要的投资领域之一。然而,人工智能服务器的成本会因GPU的不同而存在巨大差异……
最佳AI服务器:顶级AI计算解决方案对比
人工智能彻底改变了现代计算领域,催生了对强大基础设施的需求,这种基础设施需要能够训练模型、运行人工智能应用程序并处理海量数据。传统上为网站和商业应用程序设计的服务器往往无法……
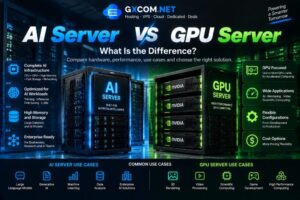
AI服务器与GPU服务器:有什么区别?
人工智能工作负载需要强大的计算基础设施,但在AI服务器和GPU服务器之间做出选择可能会让人感到困惑。这两种解决方案都采用了先进的硬件加速技术,且专为高要求的工作负载而设计,但它们的侧重点……
最佳AI服务器:顶级AI计算解决方案对比
人工智能工作负载需要强大的计算基础设施,以处理海量数据集、训练复杂模型并提供快速的人工智能应用。最佳的人工智能服务器融合了先进的GPU、高性能CPU、大容量内存和经过优化的网络……
AI 服务器指南:关于 AI 服务器你需要了解的一切
人工智能应用正在迅速推动对高性能计算基础设施的需求。从机器学习模型和生成式人工智能,到大型语言模型和自动化系统,传统服务器往往无法提供足够的计算能力……