当模型跨多个设备运行时,两台GPU服务器即使宣称属于同一加速器系列,其运行结果也可能大相径庭。这种差异可能涉及GPU的外形尺寸、互连拓扑、功耗限制,以及软件在加速器之间传输数据的方式。.
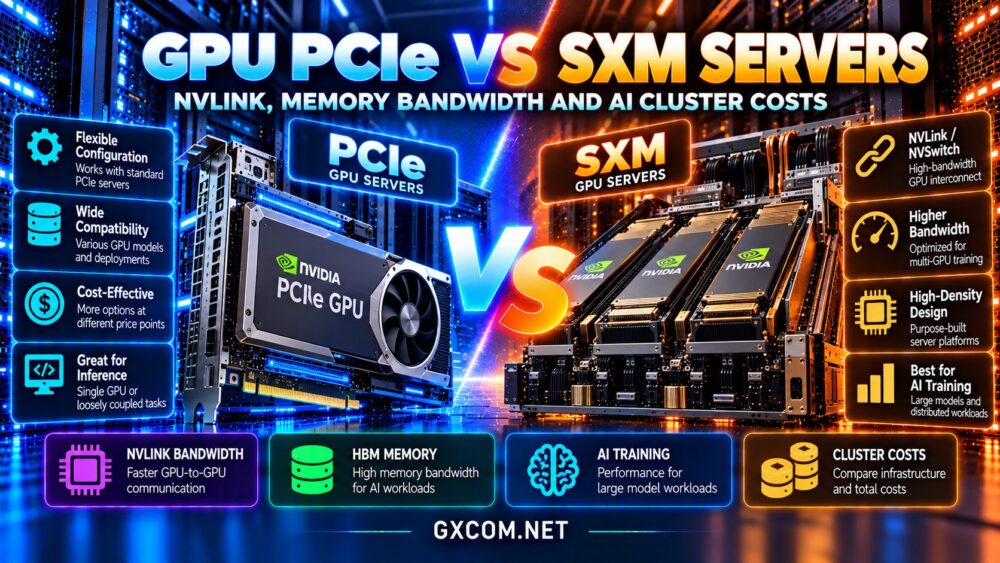
这个 GPU PCIe 与 SXM 服务器对比 该对比分析了 NVLink、NVSwitch、HBM 内存带宽、AI 训练吞吐量、推理部署以及集群总成本。其重点在于实际的采购决策,而非将某一种连接器类型视为通用的性能保证。.
GPU PCIe 与 SXM:简要结论
选择一款配备 PCIe GPU 的服务器 当您需要灵活的配置、单GPU或松耦合的工作负载,或者基础设施预算不足以支持高度集成的加速器系统时。.
考虑基于SXM的系统 当您的应用程序能够从高带宽的 GPU 间通信、强大的供电和散热能力,以及经过验证的多 GPU 软件堆栈中获益时。.
请务必比较完全相同的GPU型号和服务器拓扑结构。现代PCIe加速器可能比老款SXM产品性能更优,而且并非每台SXM服务器都提供相同的NVLink互连架构。.
什么是 PCIe GPU 服务器?
PCIe GPU是通过外设组件互连express(PCIe)接口安装的,通常以插卡式加速卡的形式存在。PCIe 提供了 GPU 与主机平台(包括 CPU 内存、存储设备和网络设备)之间的连接。.
服务器对GPU的支持取决于物理空间、供电、散热、PCIe代数、通道分配以及固件。配备多个PCIe插槽的服务器并不一定支持任意数量的高功耗GPU。.
PCIe 是一种外形规格和连接方式,并不意味着该加速器缺乏高速本地内存或高计算性能。许多专业级 GPU 都采用 HBM 技术,并在 PCIe 配置下能提供出色的推理性能。.
什么是 SXM GPU 服务器?
SXM 是指专为兼容的服务器主板和专用系统架构设计的 NVIDIA 加速器模块。SXM 系统通常应用于高密度多 GPU 平台,这些平台专为提供强大的供电能力和热管理能力而设计。.
某些 NVIDIA HGX 和 DGX 配置采用配备高带宽 NVLink 连接和 NVSwitch 互连架构的 SXM 模块。具体功能因产品代次和服务器设计而异。.
SXM 并非一种可以直接插入普通 PCIe 插槽的升级组件。购买 SXM 服务器通常意味着需要选择一个兼容的完整平台,并满足其相关的网络、散热和维护要求。.
NVLink 与 PCIe:了解 GPU 通信
PCIe 提供了一种通用 I/O 架构,而 NVLink 则是仅在部分 NVIDIA GPU 产品和系统上提供的专用高带宽互连技术。这两项技术分别解决了既存在重叠又各不相同的通信问题。.
某些采用 PCIe 规格的 GPU 代产品支持 NVLink 连接,而另一些则不支持。同样,仅凭 SXM 这一名称,无法得知其可用的链路数量、带宽或交换拓扑。.
在张量并行推理中,GPU 可能会在生成每个令牌的过程中反复交换中间结果。如果通信成为瓶颈,更快的互连技术可以改善延迟并提高吞吐量。.
然而,对于独立推理副本而言,请求通常可以在无需大量GPU间通信的情况下进行分发。在这种情况下,为高级网络架构付费可能带来的收益有限。.
NVSwitch 带来了什么?
NVSwitch 使受支持的系统能够通过高带宽交换架构连接多块 GPU。与依赖数量有限的直接点对点连接相比,这使得多个加速器之间的通信更加切实可行。.

服务器的拓扑结构与它的营销标签同样重要。需考察哪些 GPU 能够直接通信、可用的带宽,以及工作负载是否必须跨越 CPU、PCIe 或网络边界。.
有关详细的硬件候选清单,请参阅我们的 NVIDIA GPU 服务器供应商指南.
HBM 内存带宽不等于 NVLink 带宽
高带宽内存(HBM)向GPU的计算单元提供数据。其带宽会影响诸如读取模型权重和处理内存密集型内核等操作。.
NVLink 带宽涉及 GPU 之间的数据传输,以及在支持该技术的系统中与其他连接组件之间的数据传输。PCIe 带宽则涉及通过主机 I/O 接口进行的通信。.
这些指标不能相互替代。一款GPU可能拥有巨大的本地HBM带宽,但在分布式执行需要频繁通过较慢的互连总线进行数据传输时,其可扩展性却可能较差。.
将内存容量、内存带宽、GPU 计算能力以及互连带宽作为独立的规格进行比较。.
培训:SXM平台何时能胜出
分布式人工智能训练通常涉及在多个GPU之间同步梯度、交换激活值或对模型进行划分。通信强度取决于数据并行、张量并行、流水线并行以及模型架构。.
配备 NVLink 或 NVSwitch 的匹配良好的 SXM 平台可减少受支持训练配置中的通信瓶颈。但训练速度还取决于软件库、存储吞吐量、网络、批量大小以及 GPU 利用率。.
对于较小的模型、独立实验或通信需求不高的任务,基于 PCIe 的集群仍然是合适的选择。.
应测量每秒完成的训练步骤数以及每次训练运行的成本,而不仅仅是加速器的峰值理论性能。.
推理:使用单张 GPU 还是多张 GPU?
对于能够装入单个加速器中的模型而言,GPU 间带宽对请求延迟的影响可能微乎其微。VRAM 容量、权重精度、内存带宽以及高效的推理内核才是更关键的因素。.
当模型被分配到多块GPU上运行时,通信开销可能会变得相当显著。如果更快的连接能带来可测量的吞吐量提升,那么SXM系统的高昂价格就显得物有所值了。.
量化可以通过减少所需的GPU数量来改变决策结果。我们的 经济实惠的GPU服务器指南 解释了租用加速器容量时需要权衡的更广泛因素。.
在相同的工作负载下,需考虑首次令牌出现时间、每秒令牌数、并发请求数以及模型质量。.
PCIe 与 SXM 服务器成本对比
合理的比较不应仅限于每小时的GPU租赁费用。SXM系统可能涉及高端机箱、高密度供电、专用散热方案、交换硬件以及更高的最低租赁配置要求。.
PCIe 系统可能提供更多样化的加速器数量和配置选择,不过高端 PCIe GPU 的价格也可能较高。供货情况和价格取决于具体供应商和地区。.
如果一套 SXM 系统的每小时成本更高,但能显著更快地完成一项训练任务,那么其每项完成的任务成本可能反而更低。反之,如果一套配备八个 GPU 的系统利用率较低,而实际上仅需一两个 GPU 即可满足需求,那么这种配置反而会造成资金浪费。.
根据可计费运行时间、利用率、存储、数据传输、支持以及工程间接费用,计算项目总成本。.
值得比较的GPU托管服务商
RunPod:灵活的GPU租赁服务
RunPod 这对于实验、推理和 GPU 部署工作流都至关重要。请比较当前加速器的可用性、专用资源与共享资源的特性、存储费用,以及所提供的机器是否提供了您的工作负载所需的互连。.
Cherry Servers:专用 GPU 基础设施
Cherry 服务器 对于希望获得专用服务器控制权和可预测的硬件部署位置的买家而言,该方案值得考虑。在做出决定之前,请务必确认具体的GPU型号、PCIe或SXM配置细节、互连拓扑以及网络规格。.
Vultr:GPU 云部署
Vultr 提供适合云原生 AI 服务的 GPU 基础设施选项。请确认所选产品的加速器代数、内存容量、部署区域,以及是否支持多 GPU 通信功能。.
GPU Mart:GPU 服务器选项
GPU Mart 这是另一个用于比较 GPU 托管和专用配置的参考案例。请确认支持的硬件、驱动程序要求、功耗限制以及实际拓扑结构,而不是假设每台多 GPU 服务器都包含 NVLink。.
请参阅我们的 AI GPU VPS 服务商指南 购买前。.
运营方面的考虑:网络连接与可靠性
多节点集群带来的网络带宽、延迟和集体通信需求,已超出了单台服务器内部连接的范围。即使拥有出色的内部 NVLink 互连架构,也无法消除不同机器之间的瓶颈。.
请检查InfiniBand或以太网功能、网络超额订阅情况、资源放置策略,以及对您计划使用的分布式框架的支持情况。.

此外,还需考虑故障域。当一个节点发生故障时,紧密耦合的多GPU任务可能会中断,因此检查点、恢复流程以及技术支持响应时间都会影响实际的训练成本。.
租房前应询问的问题
请提供确切的加速器 SKU、GPU 数量、内存容量、本地互连拓扑、主机 CPU、RAM、存储、网络吞吐量以及租赁计费单位。.
询问该服务商是否提供裸机访问或虚拟化GPU实例,是否支持点对点传输,以及提供哪些驱动程序和CUDA版本。.
在决定长期租赁之前,请先进行一次具有代表性的性能测试。我们的 GPU 与 CPU 服务器的对比 为选择合适的计算架构提供了更多背景信息。.
常见问题解答
SXM 是否总是比 PCIe 更快?
不。应比较具体的GPU代数、功耗限制、工作负载以及互连技术。仅凭外形尺寸无法决定性能。.
所有 PCIe 显卡都不支持 NVLink 吗?
不。NVLink 的支持情况因 GPU 代号和产品配置而异,包括某些 PCIe 型号。.
SXM 是否提供了更多的显存?
并非必然如此。VRAM 容量是特定加速器型号和代次的规格参数。.
LLM推理是否需要SXM?
不。许多推理工作负载在 PCIe GPU 上都能高效运行,尤其是当模型能够容纳在一台设备上时。.
最终结论:根据工作负载情况考虑购买
该 GPU PCIe 与 SXM 服务器对比 这一决策旨在使加速器架构与通信需求及总体运营成本相匹配。.
若需灵活部署或处理无需高端 GPU 间带宽的工作负载,请选择 PCIe。对于经过验证且能从其互连架构中受益的多 GPU 工作负载,请考虑采用配备 NVLink 或 NVSwitch 的 SXM。.
比较 RunPod, Cherry Servers、Vultr 和 GPU Mart 基于经过验证的规格和每项已完成工作的实测成本。合适的服务器是指既能提供所需性能,又无需为未使用的基础设施付费的那种。.