当 GPU 内存限制了批量大小、模型部署位置和并发请求数量时,运行大型语言模型的成本会很高。采用低精度推理可以缓解这些限制,但选择更小的数值格式又会引发关于精度、硬件兼容性以及实际服务成本的新问题。.
这个 FP8 与 FP4 推理 该对比分析阐述了GPU内存节省、量化权衡、模型质量、吞吐量以及基础设施采购决策。我们并未简单假设四位推理能自动将云服务费用减半,而是深入探究了节省成本的实际来源。.
FP8 与 FP4 推理:简要结论
选择 FP8 当您希望在内存效率、模型质量以及对兼容 GPU 架构和推理框架的支持之间取得实际平衡时。.
考虑FP4 当模型权重占用大量VRAM时,您的目标硬件支持高效的4位执行路径,且质量测试确认量化后的模型满足应用需求。.
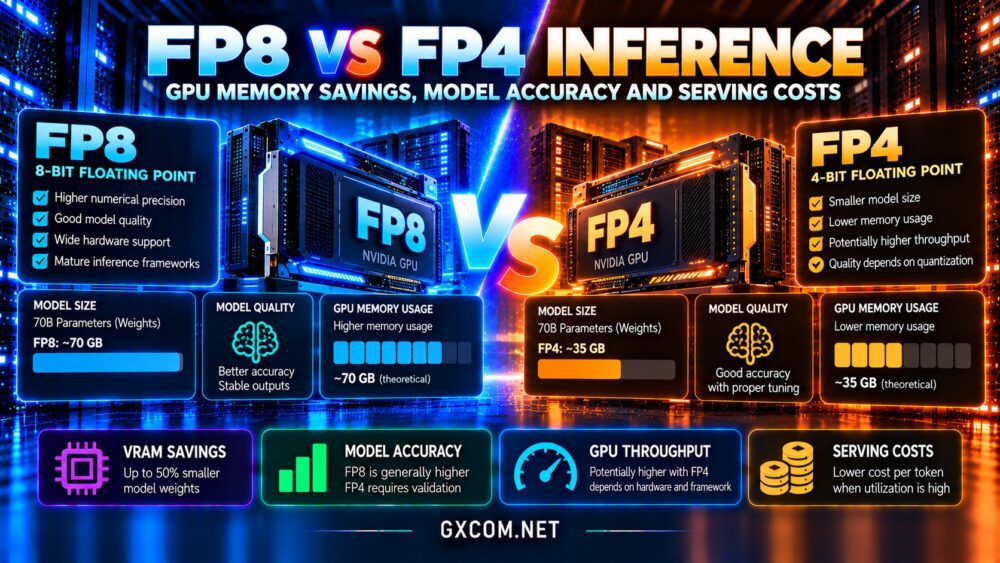
与 FP8 相比,FP4 可将理论内存占用减少 50%。但这并不能保证 GPU 总内存消耗会降低 50%、推理速度会提高一倍,或模型输出结果完全相同。.
什么是 FP8 推理?
FP8 使用 8 位浮点表示法来存储或处理数值。不同的 FP8 格式在数值范围和精度之间做出了不同的权衡。.
在人工智能推理中,与FP16或BF16等更高精度格式相比,FP8可以减少模型权重的存储空间和内存带宽需求。.
实际性能取决于 GPU、内核和推理引擎能否高效支持所选的 FP8 运算。.
FP8 之所以在生产部署中颇具吸引力,是因为在经过适当的转换和验证后,它不仅能显著提升效率,还能为许多模型保持可接受的质量水平。.
什么是 FP4 推理?
FP4 使用 4 位来表示数值。现代人工智能部署可能会使用专用格式,例如 NVIDIA NVFP4 或其他基于块的 4 位表示法。.
这些实现方式不能互换。它们的缩放方法、支持的操作、数值行为和硬件要求可能各不相同。.
FP4 可以大幅减少权重存储空间,但要实现强大的推理性能,仅靠将数字存储在 4 位中还远远不够。.
执行框架必须支持该格式,且硬件必须为相关操作提供高效的执行路径。.
GPU 内存节省:FP8 与 FP4 对比
对于一个包含700亿个参数的简化模型,若将每个权重以FP8格式存储,则大约需要700亿字节,即十进制单位下的70 GB。.
在不考虑额外元数据的情况下,存储与原始四位值相同数量的权重大约需要 35 GB 空间。.
这一比较解释了为什么FP4在内存受限的推理场景中备受关注。然而,实际的模型文件和运行时内存消耗比这些理论数据更大或更复杂。.
为什么 FP4 并不总能将 VRAM 占用量减半
量化模型可能需要缩放因子、元数据、更高精度的层、临时缓冲区以及转换工作区。.
推理服务器还会为激活函数、注意力操作和键值对缓存分配内存。当模型权重从 FP8 变为 FP4 时,这些组件的内存占用并不一定会减少。.
对于长上下文工作负载,KV缓存的占用可能会成为内存预算中的主要部分。.
应在实际的上下文长度和并发条件下测量峰值分配的VRAM,而不是仅依赖于下载的模型大小。.
如需了解更多硬件选项,请阅读我们的 NVIDIA GPU 服务器供应商指南.

模型准确率:FP4 会降低质量吗?
精度降低会导致量化误差,因为能够直接表示的数值变少了。.
与FP4相比,FP8通常能提供更大的表示灵活性,但实际模型质量取决于量化方法、缩放策略、校准数据以及模型架构。.
有些模型能很好地适应激进的权重量化。而另一些模型在推理、编码、数学任务或遵循指令方面可能会出现可测量的性能下降。.
在生产环境部署前测试质量
评估具有代表性的提示词、特定领域的数据集、结构化输出的可靠性,以及对用户至关重要的失败案例。.
对于面向客户的应用程序,应在评估过程中纳入事实准确性、格式合规性以及工具调用行为等评估标准。.
在相同的测试条件下,将量化模型与一个合适的、精度更高的基准模型进行比较。.
如果输出质量下降导致重试次数增加、需要更多人工修正或增加客户支持工作量,那么降低托管费用并不算节省成本。.
GPU 硬件支持与张量核
硬件支持是 FP8 与 FP4 部署之间最重要的区别之一。.
部分 NVIDIA GPU 代产品支持加速的 FP8 计算,而高效的原生 FP4 推理则与较新的架构及受支持的数值格式相关。.
一款能够存储4位权重的GPU,并不一定能高效地执行原生FP4矩阵运算。.
某些框架在计算过程中会解压或将压缩的权重转换为另一种数值格式,从而改变了预期的性能优势。.
在选择服务器之前,请确认具体的 GPU 型号、支持的数据类型、推理引擎版本以及可用的内核。.
我们的 GPU 与 CPU 服务器的对比 解释了硬件加速的更广泛作用。.
推理速度:每秒令牌数
当减少内存流量或支持低精度计算从而消除了实际瓶颈时,FP4 可以提高推理吞吐量。.
然而,性能取决于工作负载是受内存带宽、计算吞吐量还是服务管道的其他部分所限制。.
预填充与解码性能对比
在预填充阶段,模型会处理输入令牌并执行大量并行计算。在自回归解码阶段,它会增量生成令牌。.
不同阶段对量化的响应可能各不相同。较低的权重带宽可能有助于解码,而预填充性能则在很大程度上取决于计算内核和批处理特性。.
分别测量获得第一个令牌所需的时间、每秒生成的令牌数以及每秒完成的请求数。.
此外,还应测试不同的批次大小和上下文长度。仅使用一个简短提示词进行的基准测试,可能无法反映实际生产环境中处理大量并发用户的聊天机器人情况。.
多GPU部署中的FP8与FP4对比
大型模型可能需要张量并行、流水线并行或其他技术,以将计算任务分配到各个GPU上。.
减少权重存储量有时可以让模型在更少的GPU上运行,从而有可能降低基础设施成本和通信开销。.
不过,结果取决于可用的VRAM、运行时缓冲区、KV缓存需求以及模型架构。.
当工作负载涉及多个加速器时,互连带宽和软件支持仍然至关重要。.
应比较完整的服务器配置,而不是假设较小的重量就必然会排除某款GPU。.
如何计算实际的 GPU 服务成本
最有用的财务指标通常是每成功生成一百万个输出代币的成本,该指标是在规定的工作负载和服务水平目标下测得的。.
例如,假设一个 FP8 部署的每 GPU-小时成本为 $2,且在该小时内生成 100,000 个输出令牌。其示例计算成本为每百万个输出令牌 $20。.
如果一个 FP4 部署的每小时成本相同,但能产出 150,000 个代币,则相应的计算成本将降至每百万个产出代币约 $13.33。.
这些是假设数据,并非供应商报价或绩效基准。.
在估算总生产成本时,应将输入处理、闲置产能、重试、网络、存储以及工程开销纳入考虑范围。.
探索我们的 经济实惠的GPU服务器指南 有关其他购买注意事项。.
值得比较的GPU托管服务商
RunPod:面向人工智能工作负载的GPU租赁服务
RunPod 这对测试推理框架和 GPU 配置的团队具有参考价值。请比较可用的加速器型号、VRAM、部署选项、存储费用以及当前的租赁条款。.
Vultr:云端 GPU 基础设施
Vultr 提供了值得评估的 GPU 云基础设施,可满足托管部署工作流和区域性需求。在规划 FP4 推理之前,请确认具体的 GPU 代数和软件兼容性。.
Cherry Servers:专用 GPU 基础设施
Cherry 服务器 对于正在考虑采用专用硬件且工作负载可预测的组织而言,这一点尤为重要。请评估可用的加速器、内存容量、网络配置以及部署支持。.
GPU Mart:GPU服务器的替代方案
GPU Mart 这是另一个可用于比较 GPU 托管配置的选项。购买前请确认具体的 GPU 型号、驱动程序支持情况、虚拟化限制以及可用内存。.
如需了解其他基础设施选项,请查阅我们的 AI GPU VPS 服务商对比.

什么时候应该选择 FP8?
当有支持的硬件可用、模型质量重要且现有推理框架具备成熟的部署路径时,FP8 是一个很好的起点。.
当模型已经能够轻松容纳在可用VRAM中,且FP4带来的可测得吞吐量提升有限时,这种做法可能更为可取。.
在什么情况下进行FP4更合理?
当内存占用成为主要限制因素、支持该格式的硬件能够高效执行所选格式,且具有代表性的质量测试显示结果可接受时,FP4便具有吸引力。.
它或许能够支持更大的模型、更高的并发性或更少的GPU,但这些优势必须通过实际验证来证明,而非仅凭假设。.
有关硬件对比,请参阅我们的 经济实惠的 NVIDIA GPU VPS 指南.
常见问题解答
FP4 占用的内存是 FP8 的二分之一吗?
原始的4位权重所需的存储空间仅为8位权重的一半。运行时内存的总节省量通常会有所不同。.
FP4 是否总是比 FP8 更快?
不。性能取决于原生硬件支持、推理内核、模型架构以及工作负载特征。.
FP4 是否总是会降低模型的准确率?
这会引入量化误差,但对实际质量的影响因情况而异。进行具有代表性的评估至关重要。.
每块GPU都能运行FP4推理吗?
某些 GPU 可以通过软件转换来处理压缩权重,但要实现高效的原生 FP4 执行,则需要兼容的硬件和软件。.
最终结论:AI推理该选FP8还是FP4?
该 FP8 与 FP4 推理 该决策应在内存效率、输出质量、硬件兼容性以及测算出的服务成本之间取得平衡。.
若要在兼容硬件上采用一种广泛适用的低精度部署策略,请选择 FP8。当支持的加速功能和经过验证的模型质量能带来明显的经济优势时,请考虑采用 FP4。.
比较 RunPod, Vultr、Cherry Servers 以及 GPU Mart 基于实际的GPU规格和工作负载基准测试。最优配置是指能在最低可持续成本下提供可靠模型输出的配置,而不仅仅是权重格式最小的配置。.