您应该使用 XML 网站地图还是 robots.txt 来控制 Google 如何发现和访问您的网站?这两者都是必不可少的技术 SEO 工具,但它们发挥的功能截然不同。.
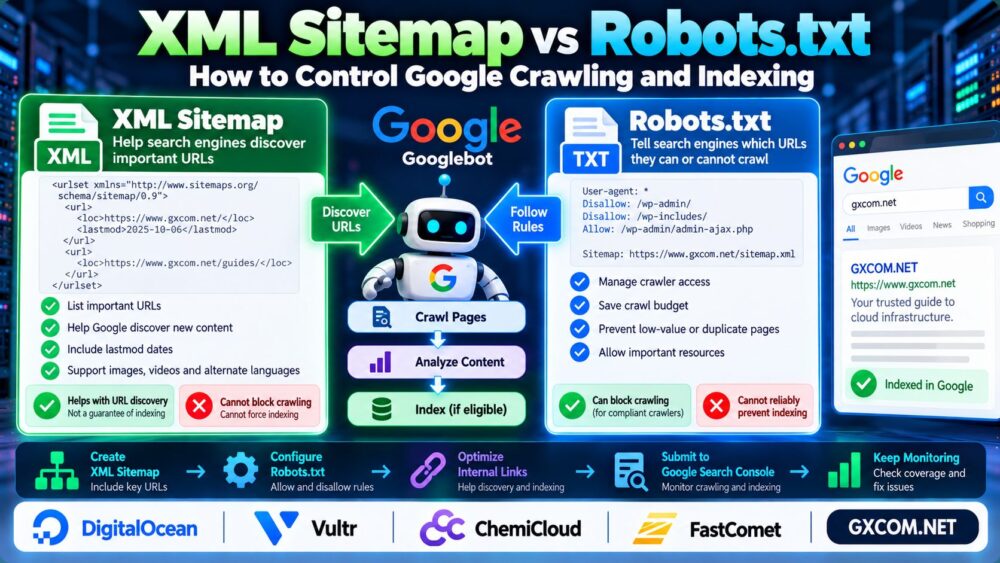
一个 XML 网站地图 有助于搜索引擎发现重要的URL。A robots.txt 该文件会告知符合规范的爬虫,哪些区域可以请求,哪些区域不能请求。.
这两款工具都无法保证谷歌会将其收录。本指南将对此进行说明 XML 网站地图与 Robots.txt, ,爬取与索引有何区别,以及如何为 WordPress 和其他网站正确配置这两项功能。.
XML 网站地图与 Robots.txt:主要区别
| 功能 | XML 网站地图 | Robots.txt |
|---|---|---|
| 主要目的 | 帮助发现重要的网址 | 管理爬虫访问权限 |
| 典型位置 | /sitemap_index.xml | /robots.txt |
| 可以阻止爬虫吗? | 不 | 是的,对于符合规范的爬虫来说 |
| 会阻止索引吗? | 不 | 不可靠 |
| 能保证被收录吗? | 不 | 不 |
| 适用于 | URL 发现 | 爬虫访问管理 |
简答: 使用 XML 网站地图来发现 URL,使用 robots.txt 来设置爬虫访问规则,并在需要将符合条件的页面从搜索结果中排除时使用 noindex 指令。.
1. 什么是 XML 网站地图?
XML 网站地图是一个结构化的文件,其中列出了您希望搜索引擎发现的 URL。.
一个基本的示例如下:
https://example.com/guide/网站地图对于大型网站、新发布的内容以及那些通过内部链接可能难以被发现的页面尤其有用。.
不过,提交网站地图并不能保证谷歌会抓取或收录其中列出的每个网址。.
2. 什么是 Robots.txt?
robots.txt 文件包含有关爬虫访问您网站的规则。.
一个简单的例子:
User-agent: *
Disallow: /private-area/
Allow: /

网站地图: https://example.com/sitemap_index.xml
此示例要求符合规范的爬虫不要访问指定的目录,同时允许访问其他路径。.
sitemap 指令可帮助爬虫找到您的 XML 网站地图。.
Robots.txt 是公开可访问的,并非一种安全机制。切勿依赖它来保护机密信息。.
3. 抓取与索引:为何这种区别很重要
爬行 指搜索引擎如何请求和处理网络资源。. 索引 这意味着搜索引擎可能会存储有关某网页的信息,以便该网页可能出现在搜索结果中。.

一个页面可能已被爬取,但尚未被收录。.
需要注意的是,即使某个URL被robots.txt文件屏蔽,如果通过外部链接或其他信号被发现,有时仍可能出现在谷歌的搜索结果中。.
如果你希望谷歌识别一个 noindex 指令,通常需要获得许可才能抓取该页面并查看该指令。.
如果在 robots.txt 中屏蔽某个 URL,同时又对该页面添加了 noindex 标签,可能会导致 Google 无法识别该 noindex 指令。.
4. 如何正确控制谷歌的索引
不同的SEO目标需要采取不同的控制措施:
| 你的目标 | 建议的做法 |
|---|---|
| 帮助谷歌发现重要页面 | XML 网站地图和内部链接 |
| 限制爬虫访问 | Robots.txt |
| 将可爬取的 HTML 页面从索引中排除 | Meta robots noindex |
| 排除受支持的非HTML资源 | X-Robots-Tag noindex |
| 合并重复的 URL 信号 | 规范标签或适当的重定向 |
| 保护机密内容 | 身份验证或访问控制 |
规范标签是提示,而非绝对指令。它们不能替代访问控制。.
如需更好地发现页面和整理主题,请参阅我们的 SEO内部链接指南.
5. 如何在 WordPress 中配置 XML 网站地图
WordPress 自带原生 XML 网站地图功能,而 Yoast SEO 等 SEO 插件则提供了额外的网站地图管理功能。.
对于使用 Yoast SEO 的网站,请确认已启用 XML 网站地图,并打开该插件生成的网站地图索引文件。.
请确认您的网站地图中包含的是预期中的、可被索引的规范 URL,而不是重定向页面、重复页面或被有意排除的页面。.
通过以下方式提交网站地图网址: Google 搜索控制台 → 站点地图.
然后,请监控网站地图的处理情况和页面索引报告,而不是认为提交后就一定能被收录。.
6. 如何为 WordPress 配置 robots.txt 文件
对于典型的 WordPress 安装,robots.txt 的基本配置可能如下:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

网站地图:https://example.com/sitemap_index.xml
请将示例网站地图的 URL 替换为您实际的网站地图地址。.
避免阻塞 /wp-content/ 或其他包含 CSS、JavaScript 和图片的目录,Google 需要这些内容来渲染重要页面。.
请勿在未核实其影响的情况下,直接复制无关网站中那些过于宽泛的 robots.txt 屏蔽规则。.
修改 robots.txt 文件后,请验证响应结果,并在 Google 搜索控制台中检查受影响的 URL。.
7. 网站地图和robots.txt中常见的SEO错误
- 阻止希望被收录的页面: 谷歌可能无法检查其内容或“noindex”指令。.
- 列出非规范 URL: 网站地图通常应包含首选规范网址。.
- 包括重定向页面: 将网站地图条目更新至其最终目标位置。.
- 利用 robots.txt 保护隐私: 公共爬虫规则无法保护敏感文件的安全。.
- 封锁基本资源: 受限的 CSS 或 JavaScript 可能会干扰渲染。.
- 忽略内部链接: 网站地图不能替代便于导航的网站结构。.
在进行 HTTPS 迁移时,请始终如一地更新网站地图 URL 和规范 URL 信号。我们的 HTTP 到 HTTPS 重定向指南 解释了这一过程。.
8. 服务器性能如何影响谷歌的抓取
可靠的主机服务有助于搜索引擎稳定地访问您的网站。频繁的服务器错误、超时以及响应性能不佳都会影响爬虫抓取。.
为了确保基础设施的灵活性,, DigitalOcean 以及 Vultr 是值得评估的相关云托管服务提供商。.
ChemiCloud 以及 FastComet 在比较托管型网站托管环境时,这些是其他可选方案。.
在选择服务提供商之前,请比较服务器的可靠性、技术支持、资源限制和运营要求。.
有关诊断基础设施瓶颈的信息,请参阅我们的 服务器性能监控指南.

9. 如何审核抓取和索引
使用 Google 搜索控制台检查重要 URL、查看索引报告,并检查网站地图的处理情况。.
调查因 noindex 标签、robots.txt 限制、重定向、重复内容信号或服务器问题而被排除在外的页面。.
对于 WordPress 的可用性错误,我们的 WordPress 503 错误指南 涵盖了相关的故障排除方法。.
在网站进行重大迁移、URL变更或更新robots.txt文件后,请审查抓取和索引趋势。.
常见问题解答
robots.txt 会阻止 Google 进行索引吗?
不能完全保证。如果谷歌在其他地方发现了该被屏蔽的网址,它仍可能出现在搜索结果中。.
XML网站地图能提高谷歌的排名吗?
网站地图有助于提升网站的可发现性,但并不能直接保证排名更高。.
XML 网站地图中应包含 noindex 页面吗?
通常来说,不需要。网站地图应侧重于您希望被收录的URL。.
我可以同时使用 robots.txt 和 XML 网站地图吗?
是的。它们具有互补的功能,并且可以在同一个网站上进行配置。.
WordPress 的 XML 网站地图在哪里?
WordPress 通常会在以下位置提供一个原生网站地图: /wp-sitemap.xml. Yoast SEO 通常使用 /sitemap_index.xml.
我应该通过 robots.txt 阻止重复页面吗?
并非自动如此。根据重复内容问题的具体情况,规范化处理、重定向和noindex标签可能更为合适。.
最终裁决
……之间的区别 XML 网站地图与 Robots.txt 原理很简单:网站地图用于支持 URL 的发现,而 robots.txt 则用于管理爬虫的访问权限。.
为了确保 Google 能有效抓取和收录网站,应结合使用结构清晰的站点地图、适当的 robots.txt 指令、可收录性控制措施、强大的内部链接以及稳定的服务器性能。.
发现 → 抓取 → 评估 → 收录。.