寻找具有竞争力的 96GB GPU 服务器租赁 要处理这些方案,需要了解加速器内存的分配方式。一台标称总显存为96GB的机器,可能配备一块大容量GPU、两块48GB显卡,或者多块小容量加速器。对于大型语言模型的推理、微调和AI开发而言,这些配置所产生的结果可能大相径庭。
在比较每小时费率之前,请先确定您的模型是否需要连续的设备内存、是否支持多GPU执行,以及是否为上下文窗口和运行时开销预留了足够的容量。本指南将详细说明实际的内存需求、托管选项以及真实的租赁成本分析。
96GB GPU服务器究竟意味着什么?
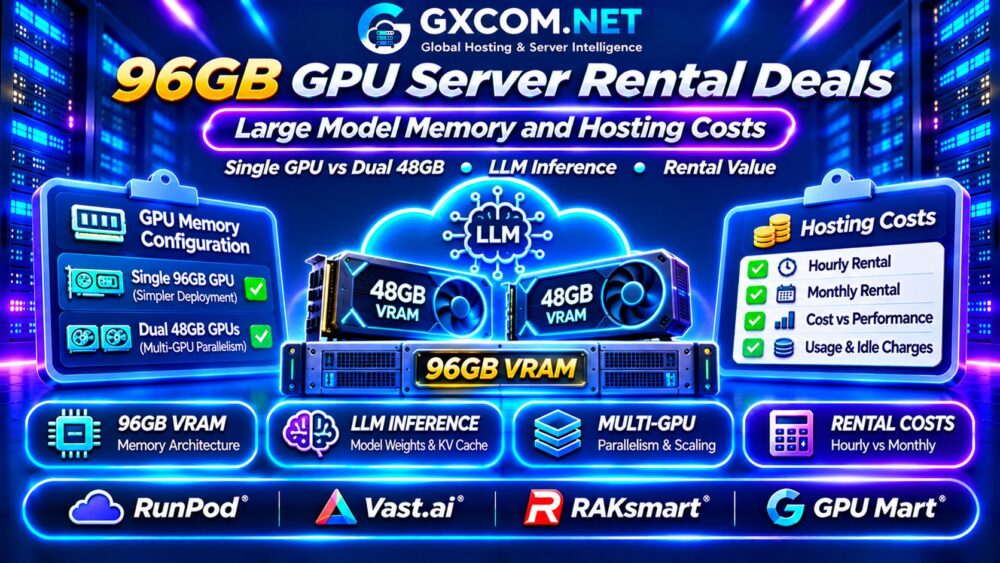
一台96GB的GPU服务器并不一定意味着它配备了一块96GB的图形处理器。服务商宣传的96GB可能是指多台设备GPU内存的总和。
例如,两块 NVIDIA L40S GPU 总共提供 96GB 的物理 VRAM,但每块显卡都有各自独立的 48GB 内存空间。应用程序无法自动将这些设备视为一个连续的 96GB 内存分配区。
其他配置可能使用内存容量更大的加速器或超过两块 GPU。请务必核实具体的 GPU 型号、设备数量、每台设备的可用内存以及虚拟化限制。
我们的 NVIDIA AI GPU 服务器指南 阐述了选择加速器时需要考虑的其他因素。
单GPU与双48GB GPU配置对比
单设备部署通常可以简化模型加载、内存管理和推理服务。当软件显式地分配模型权重和计算任务时,多GPU部署可以支持更大的工作负载。
| 配置 | 内存布局 | 关键考虑因素 |
|---|---|---|
| 单张 96GB GPU | 单个设备的内存空间 | 更简便的部署 |
| 两块 48GB 显卡 | 独立的内存空间 | 需要支持并行处理 |
| 四块 24GB 显卡 | 四项独立拨款 | 分销流程更为复杂 |
这些仅为架构示例,并不意味着所列出的每种配置均可租用。互连带宽、PCIe 拓扑、软件兼容性以及通信开销都会影响多 GPU 性能。
大型语言模型需要多少显存?
模型参数数量只是GPU内存需求的一个方面。权重、键值缓存、激活函数缓冲区、临时张量以及框架开销都会消耗内存。
简单计算一下,一个包含700亿个参数的密集型模型,仅权重部分(按每个参数2字节计算)就大约需要140GB。如果按理想情况(每个参数4位)计算,在扣除量化元数据和运行时开销之前,原始权重大约需要35GB。
实际内存需求取决于模型架构、量化实现方式、上下文长度以及并发情况。较长的提示词和多个同时发起的请求会显著增加键值对缓存的使用量。

96GB级别的配置或许能够容纳一些大型量化模型,但仅凭容量并不能保证推断速度达到可接受的水平。
什么时候值得租用96GB显存?
当较小的 GPU 无法处理模型权重、较长的上下文窗口或所需的推理并发度时,大内存配置就变得颇具吸引力。
它们还可能有助于某些微调工作流,尽管训练的内存需求与推理的内存需求存在显著差异。LoRA、QLoRA、梯度检查点和CPU卸载等技术可以减轻GPU的内存压力。
对于较小的机型,租用 96GB 可能会造成资金浪费。请将您的工作负载需求与我们的 经济实惠的 NVIDIA GPU VPS 指南 在购买超过实际需要的内存之前。
四家经过认证的GPU托管服务商对比
RunPod:面向人工智能工作负载的GPU云平台
RunPod 适用于需要 GPU 环境进行推理、实验和模型开发的开发者。请比较可用的加速器配置、GPU 数量、持久化存储以及实例生命周期计费方式。
请确认所选的部署环境是否支持您的模型所需的多GPU框架。
Vast.ai:市场平台上的 GPU 算力
Vast.ai 提供基于市场平台的GPU租赁服务。各条列表在GPU型号、主机可靠性、互连技术、存储及网络性能等方面可能存在差异。
请比较完整的机器规格,而不是仅选择广告中标注的最低GPU小时单价。在运行成本高昂的实验之前,请先确认中断风险和数据持久性。
RAKsmart:GPU 服务器基础设施
RAKsmart 是另一家经批准的供应商,可就GPU服务器需求进行评估。请确认可用的加速器型号、GPU数量、系统内存、CPU资源、网络带宽以及合同期限。
对于持续的企业级工作负载,请索取具体的硬件报价,而不是假设通用GPU列表能满足您的内存需求。
GPU Mart:GPU 虚拟专用服务器和服务器租赁
GPU Mart 这对正在比较 GPU VPS 和专用 GPU 主机方案的买家来说很有参考价值。
确认宣传中的GPU内存是专用、共享还是分布在多个设备上。检查许可、存储、管理以及月度计费条款。
这些供应商仅为潜在购买对象,并非对当前可购96GB显卡优惠的经核实的排名。
GPU互连与推理性能
如果模型执行需要通过带宽受限的互连进行频繁通信,那么即使两块GPU的总内存足够大,其性能仍可能不佳。
请检查主机是否使用 PCIe,在适用情况下是否支持 NVLink,以及是否提供了必要的设备拓扑。NVLink 的可用性因 GPU 型号和代次而异;切勿默认其已包含在内。
虽然vLLM等软件框架和分布式推理系统可能支持张量并行,但必须验证其配置和模型兼容性。
在决定长期租赁之前,请使用您的实际模型对每秒代币数、首个代币延迟以及并发性进行基准测试。
计算实际每小时和每月的租金成本
假设两种配置。服务器 A 的每小时费用为 1.80 美元,而服务器 B 的每小时费用为 2.40 美元。在本例中,两者均满足相同的应用程序要求。
| 使用场景 | 服务器 A | 服务器 B |
|---|---|---|
| 每小时租金 | $1.80 | $2.40 |
| 每月100小时 | $180 | $240 |
| 每月720小时 | $1,296 | $1,728 |
上述数字不包括存储、数据传输、税费及其他费用。这些数字仅供参考,并非服务提供商的实际报价。
服务器 A 在 720 小时内节省了 432 美元,但如果其吞吐量明显较低,则未必更具性价比。请计算每完成一个工作负载或每生成一百万个代币的成本。
闲置费用、存储及关机政策
当实例处于空闲状态时,GPU租赁费用仍可能持续增加。在某些平台上,停止计算可能会免除加速器费用,但持久卷和预留资源仍可能产生费用。

请确认终止实例是否会删除其文件,以及重启是否需要重新配置。在释放硬件之前,请先独立保存重要的模型检查点。
我们的 GPU 与 CPU 服务器的对比 提供了额外的成本规划背景信息。
96GB GPU租赁购买检查清单
- 核实每台设备的具体 GPU 型号和物理显存容量。
- 确认该模型是否支持多GPU执行。
- 计算权重内存、KV缓存和运行时开销。
- 检查 PCIe 拓扑结构、互连线路和系统内存。
- 比较每小时租赁费、仓储费、转运费和闲置费。
- 在做出长期承诺之前,先对实际推理吞吐量进行基准测试。
常见问题解答
两块48GB显卡能否运行一个需要96GB显存的模型?
如果模型和服务框架支持工作负载的分布式处理,那么理论上是可以的。内存不会自动合并为一个分配单元。
对于70B模型来说,96GB是否足够?
根据精度、运行时开销、上下文长度以及每块GPU的可用内存情况,某些经过量化的70B模型可能适用。
按小时还是按月租用GPU更划算?
按小时计费的租赁方式通常适合间歇性工作。对于持续性工作,如果总成本和性能具有竞争力,则选择按月签约更为合理。
最终裁决
最优惠的 96GB GPU 服务器租赁方案应具备合适的内存架构、支持的软件、可靠的硬件访问以及可预见的托管成本。
比较 RunPod、Vast.ai、 RAKsmart, ,以及 GPU Mart 采用真实的机型基准测试,而非仅依赖VRAM的汇总数据。如需进一步了解供应商信息,请浏览我们的 NVIDIA GPU 服务器供应商对比.