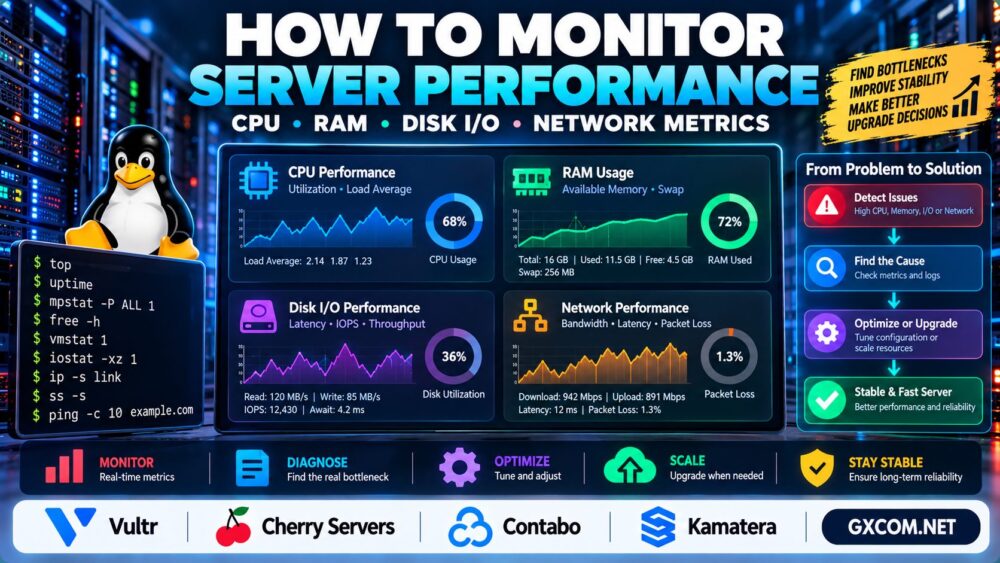
您的服务器运行缓慢、占用过多内存,还是在流量高峰时难以应对?有效的 服务器性能监控 可帮助您确定问题是由 CPU、内存、磁盘 I/O 还是网络活动引起的。.
如果没有可靠的指标,升级服务器硬件不仅会浪费资金,而且还无法解决真正的瓶颈问题。.
本指南介绍了 Linux 服务器监控的基本命令、性能指标以及诊断资源问题的实用步骤。.
在服务器上应该监控哪些内容?
首先从四个资源类别入手:CPU、内存、存储和网络。.
| 资源 | 重要指标 | 常见的预警信号 |
|---|---|---|
| CPU | 利用率、平均负载、运行队列 | 持续的饱和状态和处理延迟 |
| RAM | 可用内存、交换活动、内存压力 | 内存不足错误和持续的交换操作 |
| 磁盘I/O | 延迟、利用率、吞吐量、IOPS | 读取、写入和应用程序响应速度慢 |
| 网络 | 吞吐量、延迟、丢包率、错误 | 传输速度慢且连接不稳定 |
简答: 应建立正常的性能基准,监控资源趋势,并调查持续存在的异常情况,而不是对孤立的峰值做出反应。.
1. 如何监控服务器 CPU 性能
CPU 监控有助于判断应用程序是否受到处理能力的限制。.
在 Linux 上,请按以下步骤开始:
顶部
运行时间
顶部 显示正在运行的进程和CPU使用率。. 运行时间 包括1分钟、5分钟和15分钟的系统平均负载。.
负载平均值与 CPU 利用率并不相同。它包括可运行任务,在 Linux 系统中还包括处于不可中断状态的任务。.
将负载与 CPU 处理能力进行对比,然后分析进程行为和 I/O 等待情况。.
若要查看详细的按CPU统计信息,请使用:
mpstat -P ALL 1此命令需要相应的监控软件包,通常是 sysstat.
2. 如何监控内存和交换空间的使用情况
内存占用率高并不一定意味着您的服务器需要更多的内存。Linux 会利用可用内存进行文件系统缓存,这有助于提升性能。.
使用以下命令检查内存可用情况:
free -h
vmstat 1
应关注可用内存、交换活动以及持续的内存压力,而不仅仅是已用内存的百分比。.
频繁的交换操作、应用程序崩溃以及内存不足事件可能表明内存不足或应用程序运行效率低下。.
如需进行更深入的容量规划,请参阅我们的 专用服务器内存需求指南.

3. 如何监控磁盘 I/O 性能
存储性能会影响数据库查询、应用程序加载、备份以及文件操作。.
使用以下命令检查磁盘活动:
iostat -xz 1根据您使用的 Linux 发行版不同,您可能需要安装 sysstat.
重要指标包括:
- await: 平均 I/O 请求时间,包括排队时间和处理时间。.
- r/s 和 w/s: 每秒读写操作次数。.
- rkB/s 和 wkB/s: 数据吞吐量。.
- %util: 设备忙时间,在现代并行存储系统中需要谨慎解读。.
在持续工作负载期间,高延迟可能表明存在存储争用,但并不存在适用于所有应用程序的通用延迟阈值。.
NVMe 存储可能有助于处理 I/O 密集型工作负载,不过数据库配置和查询效率同样重要。.
4. 如何监控网络性能
网络问题可能会导致一台运行正常的服务器看起来运行缓慢,尤其是当用户从远距离连接时。.
使用以下命令查看网络接口统计信息:
ip -s link
ss -s
这些命令提供接口计数器和套接字汇总信息。.
进行基本的延迟和丢包检查:
ping -c 10 example.com请注意,ICMP 响应可能会被过滤或降级处理。仅凭 ping 失败并不能证明应用程序流量不可用。.
关于网络容量规划,请阅读我们的 10Gbps 与 1Gbps 专用服务器对比.
5. 如何识别真正的服务器瓶颈
不要仅凭单一指标来评估性能。.
| 症状 | 可能的调查范围 |
|---|---|
| CPU 占用率高且请求队列不断增长 | 应用程序处理或 CPU 限制 |
| 可用内存不足且持续发生交换 | 内存压力 |
| 数据库活动期间磁盘延迟较高 | 存储或数据库工作负载 |
| 因网络错误导致外部传输速度缓慢 | 网络接口或连接性 |
将指标与应用程序日志、数据库活动、流量模式以及最近的配置变更进行关联。.
对于网站而言,响应缓慢还可能由 PHP 工作进程、低效的查询或缓存问题引起。.
我们的 WordPress 503 错误故障排除指南 解释了资源问题如何可能导致网站可用性故障。.
6. 服务器监控工具:该选哪一款?
命令行工具对于即时故障排除非常有用,但生产环境同样能从历史监控和警报中获益。.
常见的选项包括 Prometheus 搭配 Grafana、Zabbix 和 Netdata。.
根据服务器数量、所需指标、运维复杂度以及告警需求,选择合适的监控平台。.
针对持续的资源压力、服务故障、存储容量以及异常网络错误配置警报。.
7. 什么时候应该升级服务器?
只有在确认存在持续的资源限制,并检查过软件优化能否解决该问题后,才进行升级。.
对于灵活的云基础设施,, Vultr 以及 卡马特拉 在比较计算配置和扩展需求时,这些是需要评估的相关供应商。.
Contabo 在评估VPS资源分配和总体成本时,可将此因素纳入考虑,而 Cherry 服务器 适用于专用和裸机工作负载。.
应比较实际的 CPU 分配、内存、存储性能、网络限制以及支持条款,而不仅仅是广告中宣传的规格。.
有关基础设施的选择,请参阅我们的 云托管与VPS对比.
服务器性能监控检查清单
- 记录 CPU、内存、磁盘和网络的基准指标。.
- 监控峰值流量和计划工作负载。.
- 跟踪应用程序和数据库的响应时间。.
- 针对持续存在的问题配置有意义的警报。.
- 在升级硬件之前,请先审查容量趋势。.
- 在进行重大配置更改后,测试系统性能。.
对于那些已超出虚拟化基础设施承载能力的工作负载,我们的 专用服务器与VPS对比指南 解释了其中的权衡。.

常见问题解答
哪些是服务器性能最重要的指标?
CPU 利用率、内存压力、磁盘延迟、网络吞吐量、错误以及应用程序响应时间都是有用的切入点。.
如何在 Linux 上查看 CPU 使用率?
使用 顶部 或 mpstat 以检查 CPU 使用率和进程活动。.
我该如何判断我的服务器是否需要增加内存?
应关注持续的内存压力、页面交换以及应用程序故障,而非仅仅关注内存使用率过高这一现象。.
导致磁盘 I/O 等待时间过长的原因是什么?
可能的原因包括存储争用、设备速度慢、数据库工作负载以及其他正在等待 I/O 完成的进程。.
10Gbps端口能解决网络延迟问题吗?
不一定。端口容量和延迟是不同的特性。路由、距离和拥塞情况同样重要。.
监控VPS和独立服务器的方式应该有所不同吗?
核心指标虽然相似,但VPS的性能还可能取决于虚拟化开销、共享资源以及服务商设定的限制。.
最终裁决
生效 服务器性能监控 综合了 CPU、内存、磁盘 I/O、网络以及应用层方面的测量数据。.
在实际工作负载下衡量性能,排查长期存在的瓶颈,并仅在有充分依据支持的情况下才升级资源。.
监控 → 比较基准 → 识别瓶颈 → 优化 → 扩展。.